Виявлення помилок з низькими накладними витратами за допомогою просторово-часових кодів
У цьому туторіалі ми реалізуємо робочий процес для вибірки з кліффордової схеми та використаємо пакет qiskit-paulice, щоб підвищити точність виміряного розподілу, застосувавши просторово-часові перевірки Паулі по всій схемі. Просторово-часові перевірки Паулі подібні до когерентних перевірок Паулі (CPC) тим, що кліффордова схема-«корисне навантаження» заплутується з певними допоміжними кубітами, щоб «перевіряти» певні інваріанти в схемі. Вимірювання допоміжних кубітів дає синдром, який використовується для визначення того, чи було виявлено логічну помилку під час виконання схеми. Постселекція лише тих вибірок, у яких помилку не виявлено, може підвищити точність вибіркових розподілів ціною зниження частки відібраних вибірок. Ключова відмінність між CPC і просторово-часовими перевірками полягає в тому, що вимірювання синдромів CPC потребує вимірювання локалізованих у часі операторів великої ваги. На топологіях кубітів з обмеженою зв'язністю, як-от heavy hex, реалізація цих перевірок потребує багатьох гейтів SWAP, що часто робить схему надто глибокою для практичного виконання. Реалізація перевірок Паулі як просторово-часових кодів дозволяє розподілити їх по всій схемі корисного навантаження, що забезпечує апаратно-ефективне кодування кубітів, яке залишається ефективним у виявленні логічних помилок під час виконання схеми. Основна роль пакета qiskit-paulice — знаходити та вставляти допустимі просторово-часові перевірки Паулі в ті місця схеми, які одночасно максимізують ефективність виявлення помилок і мінімізують накладні витрати на кубіти.
Цей туторіал реалізує робочий процес підвищення точності розподілу, отриманого вибіркою з квантової схеми, за допомогою просторово-часових перевірок. Оскільки ми використовуватимемо кліффордову схему, точність можна оцінити безпосередньо за усередненими очікуваними значеннями стабілізаторів схеми. Ми виконаємо такі кроки:
-
Створення схеми: неглибока одновимірна випадкова кліффордова схема типу brickwork, яка використовується для візуалізації перевірок.
-
Визначення кубітів як цілей для перевірок: відобрази схему на фізичні кубіти QPU Heron
ibm_bostonі визнач кубіти із сусідніми допоміжними кубітами. -
Транспіляція схеми для бекенда: обери розкладку кубітів і перетвори гейти схеми на рідний набір гейтів
ibm_boston. -
Створення моделі шуму з даних бекенда: згенеруй грубу модель шуму на основі еталонних даних бекенда. Ці дані про шум використовуватимуться для оцінювання ефективності кожної додаткової перевірки.
-
Візуалізація перевірок Паулі: додай кілька перевірок Паулі до неглибокої схеми, щоб побачити, як додаються перевірки.
-
Визначення стабілізаторів для вимірювання: збільш глибину схеми, щоб посилити вплив шуму гейтів. Випадково відбери підмножину стабілізаторів глибшої схеми.
-
Пошук хороших перевірок для всього стану: знайди один набір перевірок для стабілізаторів стану, який готує схема. Такі перевірки є допустимими незалежно від того, що вимірюється потім, тож одна й та сама схема з перевірками придатна для кожного відібраного стабілізатора.
-
Вибірка з шумної схеми: виміряй схеми без перевірок і з перевірками в базисі кожного відібраного стабілізатора за допомогою samplomatic і виконай їх вибірку примітивом
Executorна шумному симуляторі, який використовує той самий деполяризаційний шум, що й під час пошуку перевірок. -
Постселекція вибірок схеми з перевірками без виявлених помилок: видали вибірки, які не проходять принаймні одну перевірку. Обчисли очікувані значення для шумної схеми без перевірок і схеми з перевірками.
-
Порівняння точності початкового та постселектованого шумних станів: покажи, що постселекція лише вибірок без виявлених помилок покращує оцінену точність шумного стану.
1. Створення схеми
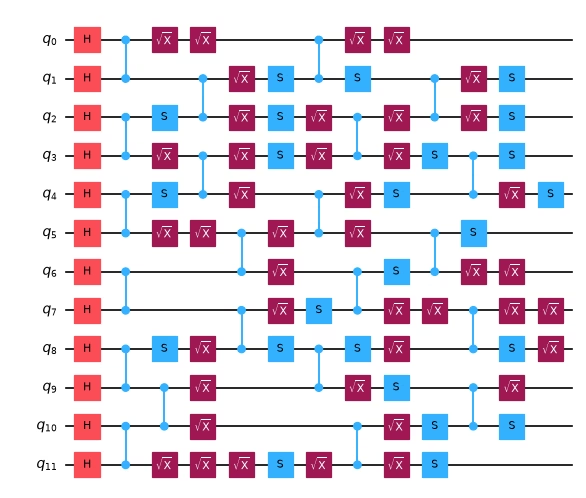
Спочатку ми створимо неглибоку кліффордову схему, у якій заплутувальні гейти розташовані зі зв'язністю типу brickwork. Ми використаємо цю невелику схему, щоб візуалізувати, як до схеми додаються перевірки.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "qiskit_paulice": "qiskit-paulice", "samplomatic": "samplomatic"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import numpy as np
from qiskit import QuantumCircuit

def random_clifford_circuit(
    num_qubits: int, depth: int, rng: np.random.Generator
) -> QuantumCircuit:
    """Brickwork random Clifford on `num_qubits`, with `depth` CZ layers."""
    qc = QuantumCircuit(num_qubits)
    qc.h(range(num_qubits))
    for d in range(depth):
        for i in range(d % 2, num_qubits - 1, 2):
            qc.cz(i, i + 1)
        for q in range(num_qubits):
            if rng.integers(0, 2):
                qc.sx(q)
            if rng.integers(0, 2):
                qc.s(q)
            if rng.integers(0, 2):
                qc.sx(q)
    return qc

num_qubits = 12
depth = 4
seed = 1764
rng = np.random.default_rng(seed)
np.random.seed(seed)
circuit = random_clifford_circuit(num_qubits, depth, rng)
circuit.draw("mpl", fold=-1, scale=0.6)
2. Визначення кубітів як цілей для перевірок
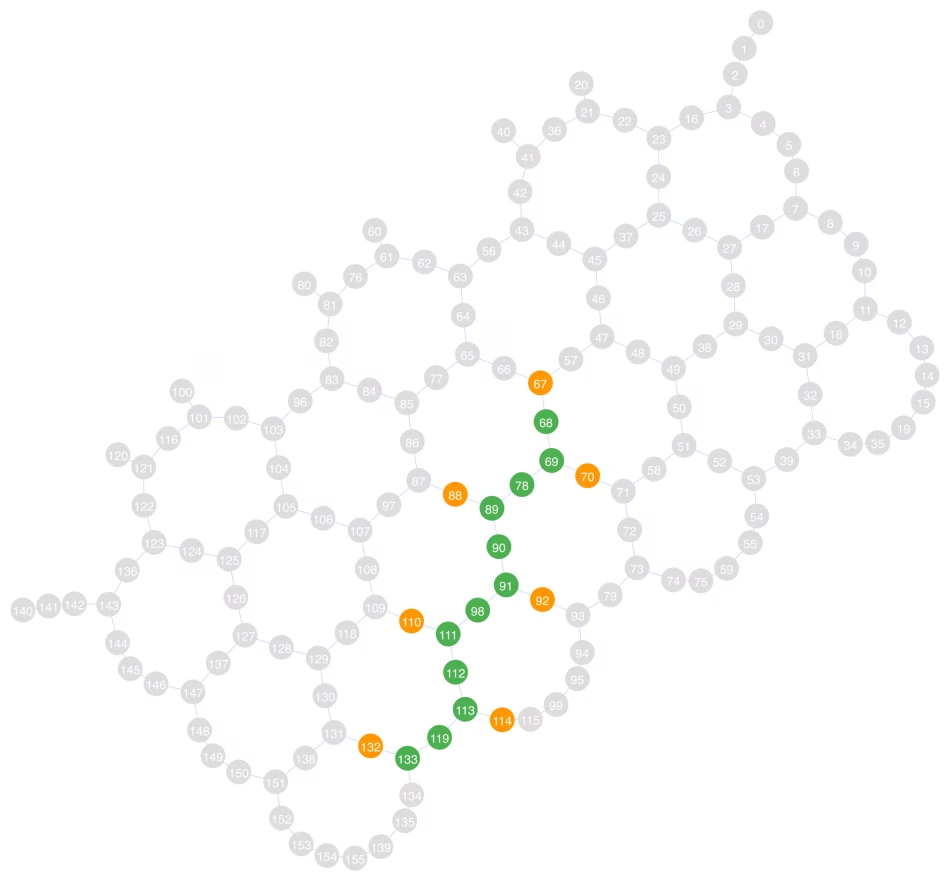
Далі ми обираємо одновимірну розкладку кубітів на QPU Heron r3, ibm_boston. Ми обираємо розкладку, що зигзагом проходить діагонально через граф зв'язності та максимізує кількість доступних допоміжних кубітів. Щоб знайти доступні допоміжні кубіти, ми використовуємо функцію get_check_qubits, яка повертає списки пар ціль/допоміжний кубіт. Перевірку Паулі на target_qubits[i] буде реалізовано за допомогою ancilla_qubits[i].
На графі зв'язності нижче зелені кубіти — це кубіти корисного навантаження, а помаранчеві — допоміжні кубіти, які ми використаємо для реалізації перевірок. Кубіти 68, 69, 89, 91, 111, 113 і 133 мають суміжні допоміжні кубіти, тому ми використаємо ці кубіти (що відповідають віртуальним кубітам 0, 1, 3, 5, 7, 9 і 11) як цільові кубіти для реалізації перевірок. Зауваж, що кубіт 134 є суміжним із кубітом 133 у корисному навантаженні, але не підсвічений як допоміжний. Це тому, що 133 уже було (довільно) обрано для реалізації перевірки з допоміжним кубітом 132.
from qiskit.visualization import plot_coupling_map
from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_paulice.layout import get_check_qubits

service = QiskitRuntimeService()
backend = service.backend("ibm_boston")

# Choose a layout and pair each available target qubit with a neighboring ancilla
layout = [68, 69, 78, 89, 90, 91, 98, 111, 112, 113, 119, 133]
target_qubits, ancilla_qubits = get_check_qubits(backend, layout)

print(f"Target qubits:  {target_qubits}")
print(f"Ancilla qubits: {ancilla_qubits}")
plot_coupling_map(
    num_qubits=backend.num_qubits,
    qubit_coordinates=getattr(
        backend.configuration(), "qubit_coordinates", None
    ),
    coupling_map=backend.configuration().coupling_map,
    figsize=(12, 12),
    qubit_color=[
        "#4CAF50"
        if i in set(layout)
        else "#FF9800"
        if i in set(ancilla_qubits)
        else "#DDDDDD"
        for i in backend.coupling_map.graph.node_indices()
    ],
    qubit_size=220,
    line_width=2,
    font_size=90,
)
Target qubits:  [68, 69, 89, 91, 111, 113, 133]
Ancilla qubits: [67, 70, 88, 92, 110, 114, 132]
3. Транспіляція схеми для бекенда
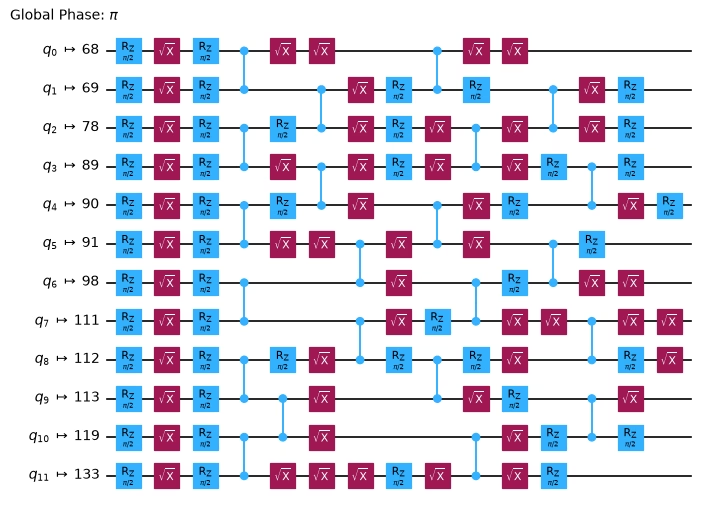
Оскільки бекенд уже обрано, ми можемо транспілювати нашу віртуальну схему в ISA-схему. Тут ми лише задаємо розкладку кубітів і перетворюємо гейти на рідний набір гейтів ibm_boston.
from qiskit.transpiler import generate_preset_pass_manager

pm = generate_preset_pass_manager(
    optimization_level=0, backend=backend, initial_layout=layout
)
circuit_isa = pm.run(circuit)
circuit_isa.draw("mpl", fold=-1, scale=0.6)
4. Створення моделі шуму з даних бекенда
Тепер, коли ми знаємо, як схема буде розташована на QPU, ми можемо змоделювати, як шум гейтів і зчитування на бекенді вплине на виконання схеми. Модель шуму використовується для визначення оптимальних місць у схемі для розміщення перевірок Паулі. Ми хочемо розміщувати перевірки в позиціях, де вони захоплюють максимальну кількість помилок. Хоча точніша модель шуму може покращити можливості перевірок з виявлення, зазвичай не потрібно вивчати модель шуму вибіркою з QPU. Тут ми виводимо однорідну деполяризаційну модель шуму гейтів, використовуючи лише еталонні дані бекенда з qiskit-ibm-runtime, і відкидаємо похибку зчитування, яку він також повідомляє: перевірки, які ми знаходимо на кроці 7, зчитують лише свій допоміжний кубіт, тож похибки зчитування корисного навантаження для них невидимі й лише знизили б постселектовану точність на кроці 10. Докладніше про задання шуму гейтів і зчитування див. у документації qiskit_paulice.NoiseModel. Якщо ти хочеш використати навчену модель шуму Паулі-Ліндблада, див. NoiseModel.from_pauli_lindblad_maps.
from dataclasses import replace

from qiskit_paulice.noise_models import NoiseModel

# Model the gate noise as a uniform depolarizing channel based on backend benchmark data
noise_model = replace(
    NoiseModel.from_backend(backend, layout, uniform_gate_noise=True),
    readout_noise=None,
)
print(noise_model)
NoiseModel(gate_noise=0.0015808382794757693, readout_noise=None, idling_noise=None)
5. Візуалізація перевірок Паулі
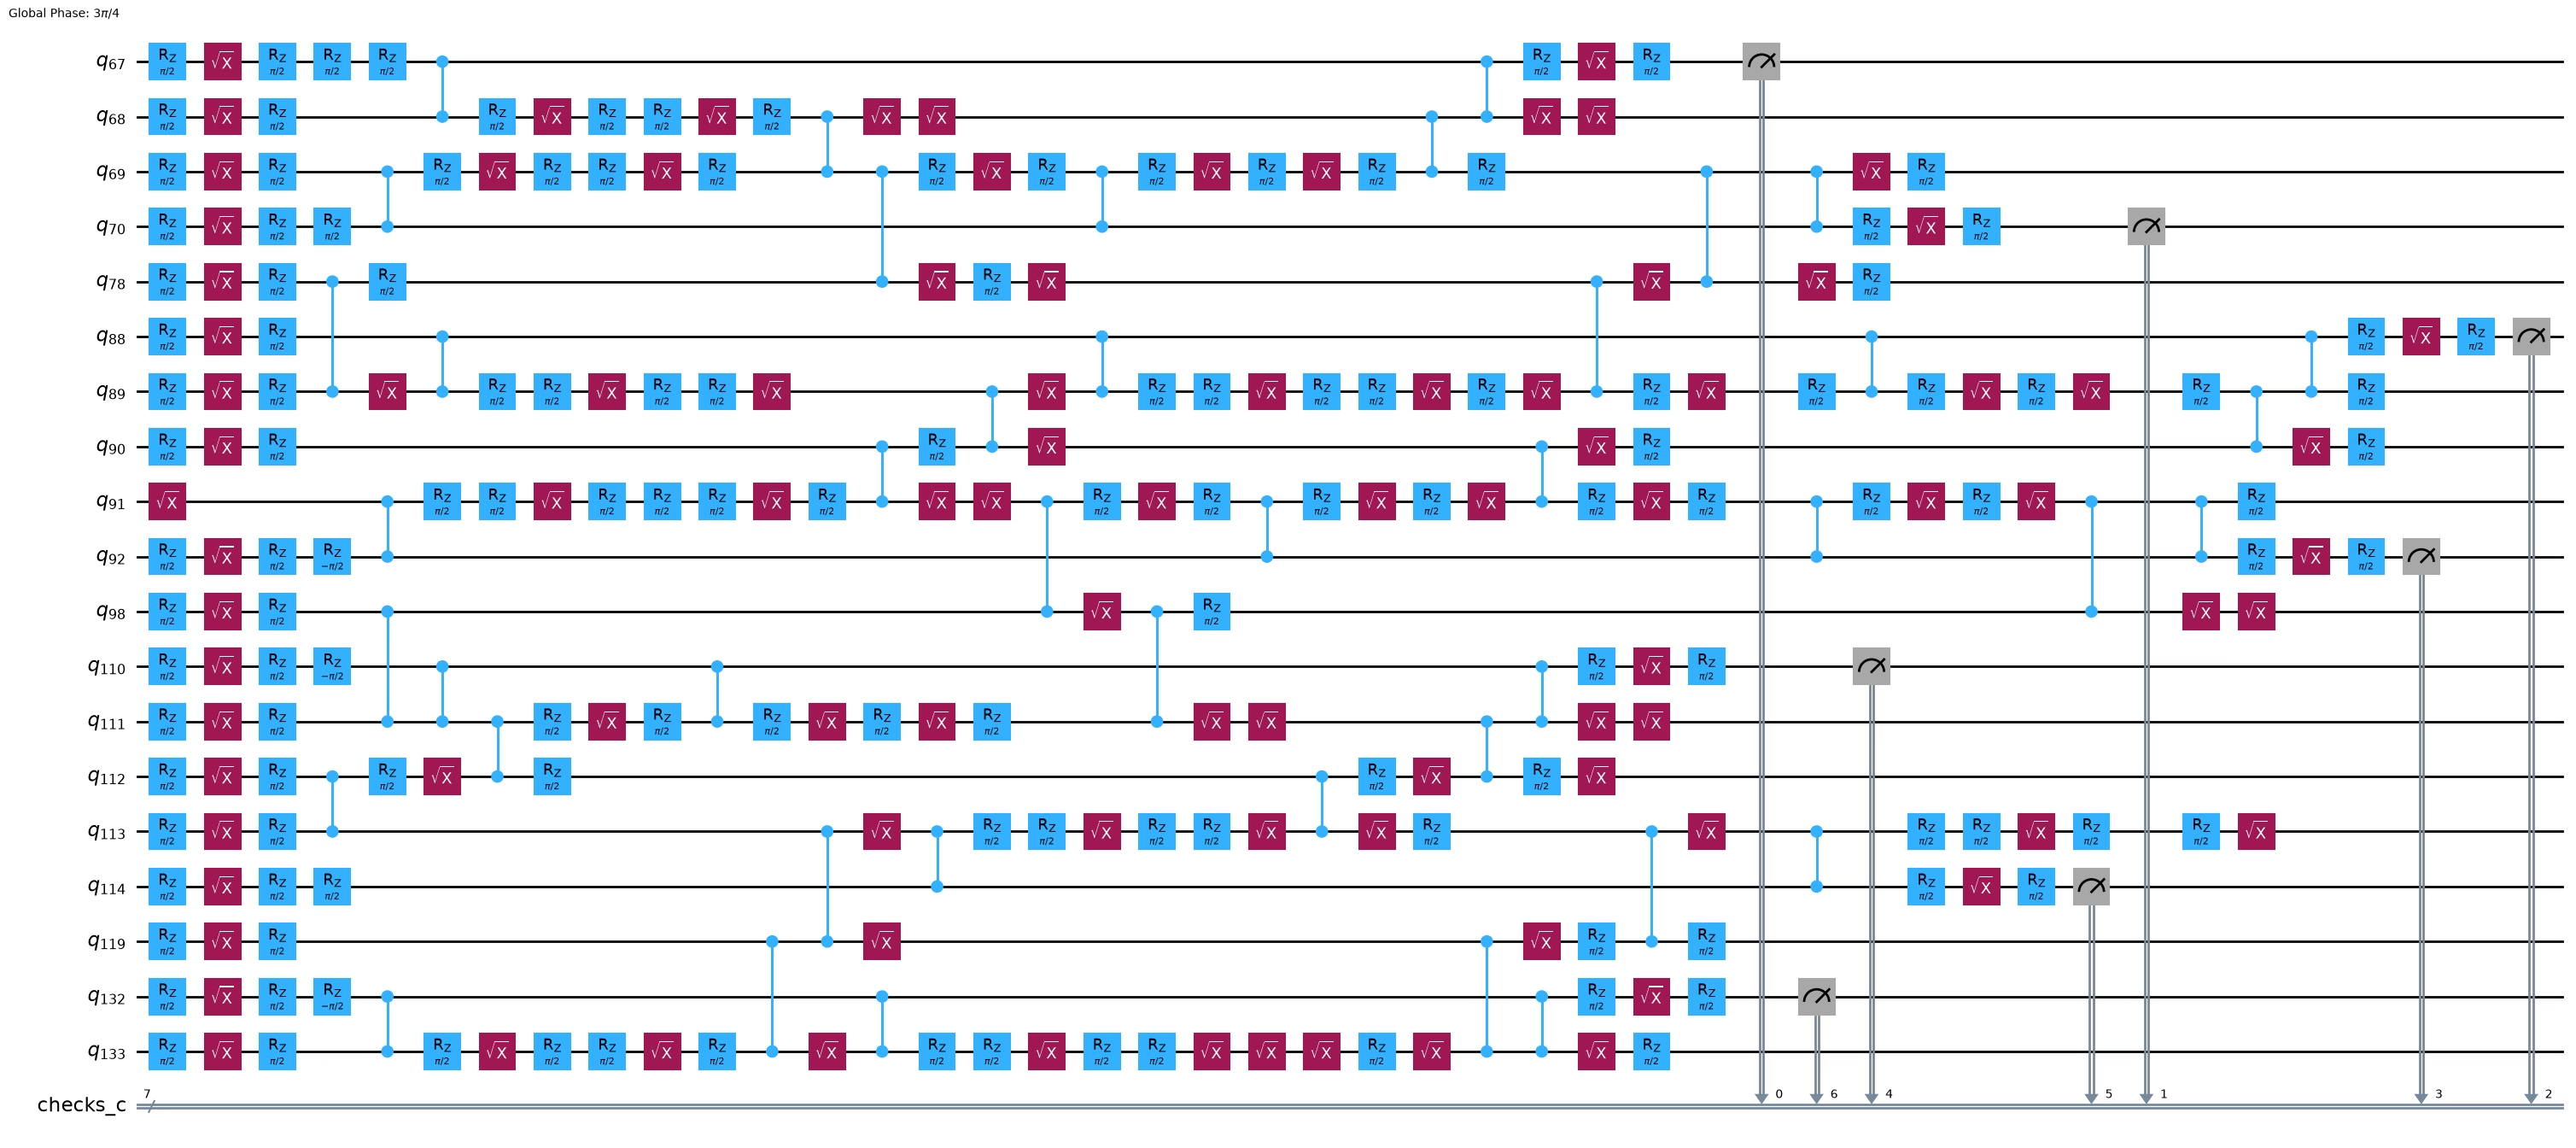
Тепер додамо кілька перевірок до схеми й подивимося, як вони виглядають. Ми можемо використати функцію qiskit_paulice.add_pauli_checks, щоб знайти хороший набір допустимих перевірок. Ми передаємо кліффордову схему корисного навантаження як вхідні дані разом зі списком кубітів корисного навантаження, до яких слід додати перевірки (цільові кубіти), і моделлю шуму, яку ми створили на попередньому кроці. У цьому прикладі ми додамо перевірки до всіх 7 цільових кубітів із доступними допоміжними кубітами. Перевірки додаються до кубітів у порядку їх появи в target_qubits, що полегшує міркування про остаточну розкладку схеми з перевірками: final_layout = layout + ancilla_qubits. Якщо користувач вирішить запустити одну з вихідних схем із меншою кількістю (i) перевірок, остаточна розкладка буде final_layout = layout + ancilla_qubits[:i+1].
Візуалізація схеми показує, що перевірки було правильно реалізовано із заданими парами ціль/допоміжний кубіт.
Подробиці про qiskit_paulice.add_pauli_checks:
- Першим вхідним аргументом має бути кліффордова схема. Тут вона не має вимірювань, і ми передаємо
stabilizers="all", тож перевірки знаходяться для стабілізаторів стану, який готує схема: перевірка є допустимою, якщо її просторово-часовий добуток Паулі вимірює такий стабілізатор, її синдромом є лише біт її допоміжного кубіта, і вона залишається допустимою в якому б базисі потім не вимірювалося корисне навантаження. Саме це потрібно для оцінювання точності, оскільки кожен відібраний стабілізатор вимірюється в іншому базисі. (Якщо опуститиstabilizers, натомість знаходяться перевірки для термінальних вимірювань схеми.) - Другий позиційний аргумент — це список індексів цільових кубітів. Кожен цільовий кубіт матиме заплутувальні гейти з допоміжним кубітом, утворюючи перевірку. Перевірки знаходитимуться й додаватимуться до схеми в порядку, у якому вони задані в цьому аргументі.
- Останній позиційний аргумент — це модель шуму, що представляє шум, який, як очікується, впливатиме на схему під час виконання. Ця модель використовується для оцінювання ефективності заданої перевірки.
ancilla_qubits: якщо вхідна схема має розкладку, цей іменований аргумент вказуєadd_pauli_checks, як призначати фізичні кубіти новододаним допоміжним кубітам.ancilla_qubitsмає бути тієї самої довжини, що йtarget_qubits(2-й позиційний аргумент), аancilla_qubits[i]слід використовувати для реалізації перевірок наtarget_qubits[i].cost: функція вартості, що використовується для оцінювання перевірок. Може бутиgammaабоLER(логічна частота помилок), які є способами описати, яка частина каналу шуму залишається не виявленою перевірками. Зstabilizers="all"помилка вважається логічною, якщо вона змінює підготовлений стан, що саме й вимірює точність.method: метод, що використовується для пошуку допустимих перевірок. Ми використовуємоwindowed, який випадково вибирає багато просторових віконних підмножин носія (дротів) цільового кубіта. Інші допустимі значення —geneticіwindowed_genetic.- Вихідні дані
add_pauli_checksмістять схеми зі зростальною кількістю перевірок — від схеми без перевірок до схеми з перевірками на кожному цільовому кубіті (за умови, що допустимі перевірки знайдено).
Докладну інформацію про пошук хороших просторово-часових перевірок Паулі див. у розділах II-IV додаткової інформації
import matplotlib.pyplot as plt
from qiskit_paulice import add_pauli_checks

# Find checks on circuit
checked = add_pauli_checks(
    circuit_isa,
    target_qubits,
    noise_model,
    ancilla_qubits=ancilla_qubits,
    cost="gamma",
    method="windowed",
    seed=seed,
    stabilizers="all",
)

print(f"Physical layout of payload+ancillas: {layout + ancilla_qubits}")
print("Checked circuit:")
checked[-1].circuit.draw("mpl", fold=-1, idle_wires=False)
Physical layout of payload+ancillas: [68, 69, 78, 89, 90, 91, 98, 111, 112, 113, 119, 133, 67, 70, 88, 92, 110, 114, 132]
Checked circuit:
6. Визначення стабілізаторів для вимірювання
Щоб перевірити ефективність виявлення помилок, ми оцінимо точність стабілізаторного стану , який схема ідеально готує, відносно шумного стану , який насправді видає апаратне забезпечення. Проєктор на чистий стабілізаторний стан визначається як рівномірне усереднення за елементами його стабілізаторної групи :
Підставивши це в рівняння точності, ми бачимо, що точність шумного стану дорівнює середньому очікуваному значенню всіх стабілізаторів відносно :
Для більших задач вимірювання (або навіть перелічення) усіх стабілізаторів неможливе, тому точність часто оцінюють, вимірюючи випадкову вибірку стабілізаторів. Рівномірно випадкова вибірка стабілізаторів з дає незміщену оцінку точності ,
Для цього експерименту ми зробимо схему набагато глибшою, щоб посилити ефект шуму гейтів, і додамо перевірки до кожного кубіта із сусіднім допоміжним кубітом. Хоча існують досконаліші способи вибірки стабілізаторів для оцінювання точності, у цьому прикладі ми відберемо стабілізаторів з рівномірною ймовірністю.
from qiskit.quantum_info import Clifford, Pauli, PauliList

num_stabilizers = 100
num_shots = 1_000
num_checks = len(target_qubits)
depth = 72

circuit = random_clifford_circuit(num_qubits, depth, rng)
# Create all 2^N stabilizers
stabilizers = PauliList([Pauli("I" * num_qubits)])
for generator in (
    Pauli(label) for label in Clifford(circuit).to_labels(mode="S")
):
    stabilizers = stabilizers + stabilizers.compose(generator)

# Choose some random stabilizers from the set
keep = np.where(stabilizers.x.any(axis=1) | stabilizers.z.any(axis=1))[0]
chosen = np.random.default_rng(seed).choice(
    keep, size=min(num_stabilizers, len(keep)), replace=False
)
stabilizers = stabilizers[chosen]
depth = circuit.depth(lambda x: x.operation.num_qubits == 2)
print(
    f"Sampled {len(stabilizers)} stabilizers of {circuit.num_qubits}-qubit circuit with two-qubit depth of {depth}: {{{stabilizers[0]}, {stabilizers[1]}, ...}}"
)
Sampled 100 stabilizers of 12-qubit circuit with two-qubit depth of 72: {-YIIYZZZIZIYY, -XIXYIIZXYIZX, ...}
7. Пошук хороших перевірок для всього стану
Ми знаходимо один набір перевірок для глибокої схеми точно так само, як на кроці 5. Оскільки перевірки зчитують лише свої допоміжні кубіти, та сама схема з перевірками придатна для кожного відібраного стабілізатора. Повернені схеми вимірюють лише допоміжні кубіти перевірок, тому вимірювання корисного навантаження ми додамо на наступному кроці.
import time

# Transpile the deep payload without measurements and find one set of checks for the whole state
payload_isa = pm.run(circuit)
t0 = time.time()
checked = add_pauli_checks(
    payload_isa,
    target_qubits,
    noise_model,
    ancilla_qubits=ancilla_qubits,
    cost="gamma",
    method="windowed",
    seed=seed,
    stabilizers="all",
)
print(
    f"Added {len(checked[-1].check_qubits)} checks in {time.time() - t0:.0f}s."
)
print(
    f"2-qubit depth increased from {payload_isa.depth(lambda x: len(x.qubits) == 2)} to "
    f"{checked[-1].circuit.depth(lambda x: len(x.qubits) == 2)} when adding {num_checks} checks."
)
Added 7 checks in 3s.
2-qubit depth increased from 72 to 85 when adding 7 checks.
8. Вибірка з шумної схеми
Ми робимо вибірку для кожного варіанта — від голого корисного навантаження до схеми з усіма 7 перевірками — для кожного відібраного стабілізатора. Варіант із нуль перевірок — це голе корисне навантаження з тими самими вимірюваннями, тому він слугує шумним еталоном. Замість того щоб додавати обертання базису кожного стабілізатора до копії кожного варіанта, ми дозволяємо samplomatic обирати базис вимірювання під час вибірки. Для кожного варіанта ми:
-
Вимірюємо корисне навантаження та групуємо термінальні вимірювання в бокс за допомогою boxing pass manager з samplomatic. Бокс несе анотацію
ChangeBasis, томуbuildповертає шаблонну схему, гейти зміни базису якої параметризовано, разом із samplex, що обчислює параметри для запитаного базису. -
Додаємо шаблон і samplex до
QuantumProgram. Samplex приймає по одному базису вимірювання на кубіт у боксі, у зростальному фізичному порядку, закодованому як , , , . Передача масиву базисів із провідною віссю довжини100змушує один елемент виміряти всі100стабілізаторів: корисне навантаження в базисі кожного стабілізатора, а допоміжні кубіти в . Кубіт поза носієм стабілізатора також вимірюється в , а його біт ігнорується під час обчислення очікуваного значення стабілізатора.
Примітив Executor з qiskit-ibm-runtime виконує всю програму в одному завданні. Якщо замість QPU передати AerSimulator, він виконується локально на цьому симуляторі, тому ми передаємо йому симулятор із тим самим деполяризаційним шумом гейтів, який ми використали для пошуку перевірок, і використовуємо стабілізаторний метод, оскільки всі схеми є кліффордовими. Qiskit Aer потрібен лише для побудови цього симулятора: локальний режим бере seed з опцій Executor, але ігнорує їхній noise_model, тому шум має бути заданий на самому симуляторі. Передача натомість бекенда QPU виконала б ту саму програму на обладнанні. Коли симуляції завершаться, ми обчислимо частку постселекції та очікувані значення, щоб відчути, наскільки добре спрацювало виявлення помилок, перш ніж візуалізувати дані.
from qiskit import ClassicalRegister
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel as AerNoiseModel
from qiskit_aer.noise import depolarizing_error
from qiskit_ibm_runtime import Executor
from qiskit_ibm_runtime.quantum_program import QuantumProgram
from samplomatic.builders import build
from samplomatic.transpiler import generate_boxing_pass_manager

# Group the terminal measurements into a box whose measurement basis is chosen at sampling time
boxing_pm = generate_boxing_pass_manager(
    enable_gates=False, measure_annotations="change_basis"
)

# bases[i, q]: basis in which physical qubit q is measured for stabilizer i (I=0, Z=1, X=2, Y=3)
bases = np.ones((len(stabilizers), backend.num_qubits), dtype=np.uint8)
bases[:, layout] = stabilizers.z + 2 * stabilizers.x

program = QuantumProgram(shots=num_shots)
for variant in checked:
    circ = variant.circuit.copy()
    circ.add_register(meas := ClassicalRegister(num_qubits, "meas"))
    circ.measure(layout, meas)
    template, samplex = build(boxing_pm.run(circ))
    (basis_input,) = samplex.inputs().get_specs()
    measured_qubits = sorted(layout + list(variant.check_qubits))
    program.append_samplex_item(
        template,
        samplex=samplex,
        samplex_arguments={basis_input.name: bases[:, measured_qubits]},
        shape=(len(stabilizers),),
    )

# Simulate the program with the same gate noise we used to find the checks
aer_nm = AerNoiseModel()
aer_nm.add_all_qubit_quantum_error(
    depolarizing_error(noise_model.gate_noise, 2), ["cz"]
)
noisy_sim = AerSimulator(method="stabilizer", noise_model=aer_nm)

# outs[k][register]: bits of the variant with k checks, shape (stabilizers, shots, bits)
t0 = time.time()
outs = (
    Executor(noisy_sim, options={"simulator": {"seed_simulator": seed}})
    .run(program)
    .result()
)
print(
    f"Sampled {len(checked)} circuits for {len(stabilizers)} stabilizers in {time.time() - t0:.0f}s."
)
Sampled 8 circuits for 100 stabilizers in 77s.
9. Постселекція вибірок схеми з перевірками
У цьому пакеті перевірка реалізується за допомогою заплутувальних гейтів між одним допоміжним кубітом і одним цільовим кубітом. Кожен допоміжний кубіт починає в стані , тому стабілізує його вхідний стан. Пряме поширення від початку допоміжного кубіта через усю схему з перевірками дає , помножений на стабілізатор підготовленого стану, тож перевірка проходить, якщо біт допоміжного кубіта дорівнює . Вибірку зберігають, якщо проходять усі перевірки.
Схеми з перевірками вимірюють допоміжні кубіти в регістр checks_c, тому вибірку зберігають, якщо кожен біт цього регістра дорівнює 0. Загалом метод get_postselection_method екземплярів CheckedCircuit, які повертає add_pauli_checks, відображає бітовий рядок шота на синдром кожної перевірки одразу; для перевірок, знайдених для стабілізаторів підготовленого стану, кожен синдром — це просто біт його допоміжного кубіта, тож ми читаємо регістр безпосередньо.
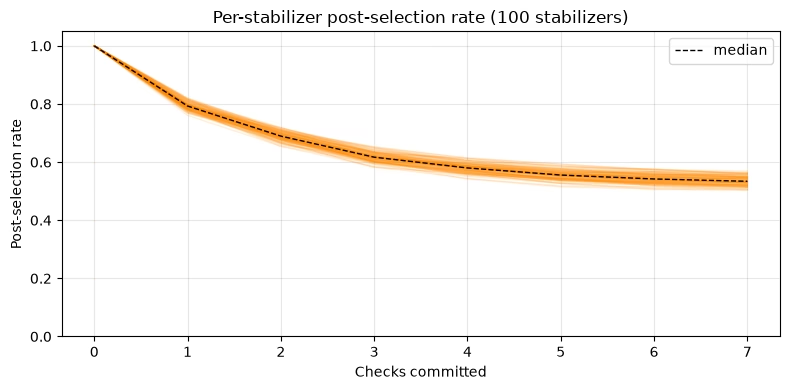
На діаграмі видно, що додавання більшої кількості перевірок знижує частку постселекції. Хоча мета виявлення помилок — виловити якомога більше помилок, зі зниженням частки постселекції може знадобитися більше шотів для досягнення певної цільової точності. Якщо частка постселекції падає надто низько, кількість шотів, потрібних для збору однієї логічної вибірки, може стати неприйнятною. У цьому прикладі частка постселекції, схоже, збігається, що означає, що додаткові перевірки дають дедалі менше додаткових можливостей виявлення. Хоча додавання більшої кількості перевірок Паулі загалом забезпечує кращі можливості виявлення помилок, воно коштує збільшенням глибини схеми та вартості вибірки.
def keep_mask(out):
    """Per-shot True/False: every ancilla read 0, so every Pauli check passed."""
    if "checks_c" not in out:  # the bare payload has no checks
        return np.ones(out["meas"].shape[:-1], dtype=bool)
    return ~out["checks_c"].any(axis=-1)

# masks[k][i]: kept shots of stabilizer i measured on the variant with k checks
masks = [keep_mask(out) for out in outs]
psrs_arr = np.array([mask.mean(axis=-1) for mask in masks]).T
ks = np.arange(psrs_arr.shape[1])

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(ks, psrs_arr.T, color="darkorange", alpha=0.15, linewidth=1)
ax.plot(
    ks,
    np.median(psrs_arr, axis=0),
    color="black",
    linewidth=1,
    linestyle="--",
    label="median",
)
ax.set(
    xlabel="Checks committed",
    ylabel="Post-selection rate",
    ylim=(0, 1.05),
    title=f"Per-stabilizer post-selection rate ({len(psrs_arr)} stabilizers)",
)
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
10. Порівняння точності початкового та постселектованого шумних станів
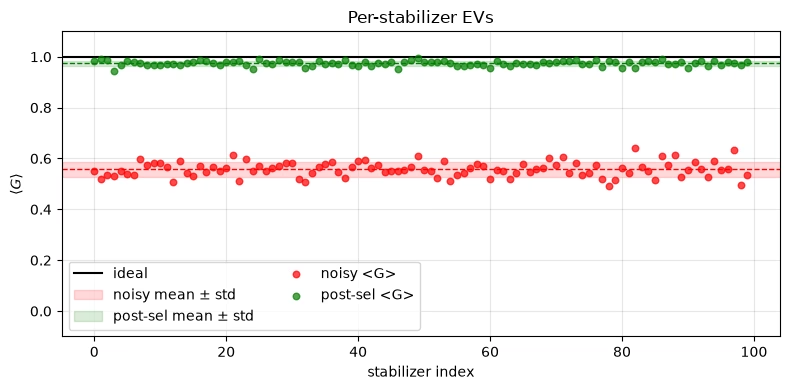
Ми бачимо, що постселекція лише вибірок без виявлених помилок значно покращує очікуване значення для кожного стабілізатора, а отже, покращує оцінену точність стабілізаторного стану. Хоча постселектовані значення було обчислено лише за вибірками, що пройшли кожну перевірку, очікувані значення набагато точніші, а вибіркова дисперсія нижча. Тепер ми також бачимо, що частка постселекції вище насправді збігалася до значення, подібного до точності шумної схеми. Частка постселекції збігалася тому, що перевірки ловили переважну більшість помилок, які реально виникали під час виконання схеми.
def expectation_values(out, mask):
    """EV of each stabilizer from the shots of ``out`` kept by ``mask``.

    Bit q of ``meas`` is virtual qubit q, so a stabilizer's eigenvalue in a shot is the parity of
    the bits in its support, times its sign.
    """
    support = stabilizers.x | stabilizers.z
    parity = (out["meas"] & support[:, None, :]).sum(axis=-1) % 2
    signs = np.where(stabilizers.phase == 2, -1.0, 1.0)
    eigenvalues = np.where(parity, -1.0, 1.0) * signs[:, None]
    kept = mask.sum(axis=-1)
    return np.where(
        kept > 0,
        (eigenvalues * mask).sum(axis=-1) / np.maximum(kept, 1),
        np.nan,
    )

evs_noisy = expectation_values(outs[0], masks[0])
evs_post = expectation_values(outs[-1], masks[-1])
print(
    f"ideal fidelity: 1.0\n"
    f"noisy fidelity: {np.nanmean(evs_noisy):.4f}\n"
    f"postselected fidelity: {np.nanmean(evs_post):.4f}\n"
    f"mean post-sel rate: {masks[-1].mean():.3f}\n"
)

evs_ideal = np.ones(len(stabilizers))
idx = np.arange(len(stabilizers))

def cum_mean_sem(ys):
    valid = ~np.isnan(ys)
    s = np.cumsum(np.where(valid, ys, 0.0))
    s2 = np.cumsum(np.where(valid, ys**2, 0.0))
    n = np.maximum(np.cumsum(valid).astype(float), 1)
    mean = s / n
    sem = np.sqrt(np.maximum(s2 / n - mean**2, 0) / n)
    return np.where(np.cumsum(valid) > 0, mean, np.nan), sem

def strip(ax, ys, color, label):
    m, s = np.nanmean(ys), np.nanstd(ys)
    ax.axhspan(
        m - s, m + s, color=color, alpha=0.15, label=f"{label} mean ± std"
    )
    ax.axhline(m, color=color, linewidth=1, linestyle="--")

fig, ax = plt.subplots(figsize=(8, 4))
ax.axhline(np.nanmean(evs_ideal), color="black", linewidth=1.5, label="ideal")
strip(ax, evs_noisy, "red", "noisy")
strip(ax, evs_post, "green", "post-sel")
ax.scatter(
    idx, evs_noisy, color="red", s=22, alpha=0.7, zorder=3, label="noisy <G>"
)
ax.scatter(
    idx,
    evs_post,
    color="green",
    s=22,
    alpha=0.7,
    zorder=3,
    label="post-sel <G>",
)
ax.set(
    xlabel="stabilizer index",
    ylabel=r"$\langle G \rangle$",
    ylim=(-0.1, 1.1),
    title="Per-stabilizer EVs",
)
ax.legend(loc="lower left", ncol=2)
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

M = np.arange(1, len(stabilizers) + 1)
fig, ax = plt.subplots(figsize=(8, 4))
for ys, color, label in [
    (evs_ideal, "black", "ideal"),
    (evs_noisy, "red", "noisy"),
    (evs_post, "green", "post-sel"),
]:
    cm, sem = cum_mean_sem(ys)
    ax.plot(M, cm, color=color, linewidth=1.5, label=label)
    ax.fill_between(M, cm - sem, cm + sem, color=color, alpha=0.15)
ax.set(
    xlabel="number of stabilizers averaged",
    ylabel="running fidelity estimate",
    title="Fidelity convergence vs. number of stabilizers",
)
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
ideal fidelity: 1.0
noisy fidelity: 0.5582
postselected fidelity: 0.9747
mean post-sel rate: 0.535

Оскільки один набір перевірок обслуговує кожен стабілізатор, є лише одна крива gamma: значення функції вартості після фіксації кожної перевірки. Для інших задач на іншому наборі фізичних кубітів і з неідеальною моделлю шуму (пам'ятай, що наша модель шуму в цьому туторіалі точно моделювала шум, який впливає на вибірки) порядок, у якому перевірки додаються до цільових кубітів, може мати помітніший вплив на те, як збігається крива.
Те, що ця крива gamma збігається до 1.0, означає, що додаткові перевірки не зможуть виявити значну кількість додаткових помилок, оскільки змодельованих помилок, не охоплених перевірками, дуже мало. Це підтверджує наше раніше спостереження про те, що збіжність частки постселекції зумовлена відсутністю неохоплених помилок у схемі.
costs = [variant.cost for variant in checked]

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(range(len(costs)), costs, color="steelblue", marker="o")
ax.set(
    xlabel="Checks committed",
    ylabel="Gamma",
    yscale="log",
    title="Gamma of the noise left uncovered by the checks",
)
ax.grid(True, alpha=0.3, which="both")
plt.tight_layout()
plt.show()
