Симуляція динаміки одновимірної моделі Фермі-Хаббарда за допомогою потокових множин
Функції, описані в цьому посібнику, наразі доступні лише в Python API. Еквівалентну функціональність буде додано до C API в майбутньому випуску.
Цей посібник будує схему для часової динаміки одновимірної моделі Фермі-Хаббарда, від запису гамільтоніана до перевірки еволюціонованих густин на вузлах. Цікавим цей шлях робить одна ідея з фреймворку потокових множин Ґандона та ін. [1], роботи, що також надихнула TransferVertexOperator у цьому пакеті:
Замість групувати члени гамільтоніана після відображення ферміон-у-кубіт, групуй їх перед ним, у потокові множини — одновимірні підмножини орієнтованого графа ферміонних взаємодій, чиї оператори переносу взаємно комутують.
Цей вибір визначає все подальше. Він вимагає такого:
-
Власне кодування ферміон-у-кубіт, пристосоване до потокових множин, яке тут витрачає один допоміжний кубіт (ancilla), щоб кількість кубітів, пов'язана з реалізацією заданого члена гамільтоніана, більше не зростала з кількістю ферміонних мод (як це відбувається в Джордана-Вігнера (JW)).
-
Власний синтез, що використовує комутативність усередині кожної множини. Виграш — схема, двокубітна глибина якої стала відносно розміру системи, на противагу лінійному зростанню при потермовій тротеризації на основі JW.
Механізм, що вводить твоє власне кодування в транспілятор (CustomF2QLayout та MapperFnEvolutionSynthesis), переноситься на будь-яку модель.
Посібник із транспіляції про стадії транспілятора, згадані в усьому тексті, та посібник про мапери про загальний рецепт написання власного мапера.
Оператори переносу та потокові множини
TransferVertexOperator будується з операторів вершин та операторів переносу . У термінах ферміонних операторів народження й знищення,
отже вимірює заповнення моди (воно дорівнює , коли мода порожня, і , коли заповнена), тоді як переносить ферміон уздовж орієнтованого ребра . Зауваж, що два індекси не взаємозамінні. Перший індекс несе комбінацію з мінусом, а другий — з плюсом, саме це відрізняє від і надає ребру орієнтацію.
Вони задовольняють змішані комутаційні співвідношення. Два оператори переносу, що діють на різні вузли, комутують тривіально, оскільки кожен є парним добутком ферміонних операторів. Цікавий випадок — спільний вузол. Там обидва комутують, якщо стрілки течуть крізь цей вузол (одна входить, одна виходить), і антикомутують, якщо вони конфліктують (обидві входять або обидві виходять).
Правило найлегше побачити на малюнку. Якщо зобразити вершини як вузли, а кожен як стрілку від до , отримаємо орієнтований граф взаємодій, тут для чотиривузлового ланцюжка, що використовується в усьому цьому посібнику, який містить обидві орієнтації кожного зв'язку:

Простеж правило на рисунку. Подивись, наприклад, на та . Одна стрілка входить у вузол 2, а інша виходить із нього, тож ферміон тече наскрізь, і ці два оператори комутують. Натомість подивись на та . Обидві стрілки вказують у вузол 2. Вони конфліктують, і ці два антикомутують.
Саме це робить можливими потокові множини. Візьми множину стрілок, що утворюють орієнтований шлях, і кожна пара або стикається «голова до хвоста», або не стикається взагалі, тож уся множина комутує, хоча окремі оператори перекриваються на спільних вузлах. Еволюція під дією однієї потокової множини тому не має похибки Троттера, і, як показує крок 7, її також можна виконати зі сталою глибиною схеми.
1. Гамільтоніан Фермі-Хаббарда
Одновимірна модель Фермі-Хаббарда на вузлах (безспінова, з відкритими межами) має вигляд
Слідуючи рівнянню (9) з Ref. [1], член стрибків дорівнює . Взаємодія діагональна, тому її виражено через оператори вершин за допомогою :
Обидві частини будуються безпосередньо як TransferVertexOperator. Зауваж, що зберігається як діагональний елемент (j, j):
>>> from collections import defaultdict
>>> from qiskit_fermions.operators import TransferVertexOperator
>>>
>>> def fermi_hubbard_1d(num_sites, tunneling, interaction):
...     data: defaultdict[tuple[tuple[int, int], ...], complex] = defaultdict(complex)
...     for j in range(num_sites - 1):
...         k = j + 1
...         # hopping: -t (a^dag_j a_k + a^dag_k a_j) = t (T_jk + T_kj)
...         data[((j, k),)] += tunneling
...         data[((k, j),)] += tunneling
...         # interaction: U n_j n_k with n_j = (1 - V_j) / 2
...         data[()] += interaction / 4
...         data[((j, j),)] -= interaction / 4
...         data[((k, k),)] -= interaction / 4
...         data[((j, j), (k, k))] += interaction / 4
...     return TransferVertexOperator.from_dict(data)
>>>
>>> num_sites = 4
>>> hamiltonian = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
>>> print(format(hamiltonian))
  1.500000e0 +0.000000e0j * ()
-5.000000e-1 +0.000000e0j * (V(0))
 5.000000e-1 +0.000000e0j * (V(0) V(1))
  1.000000e0 +0.000000e0j * (T(0,1))
  1.000000e0 +0.000000e0j * (T(1,0))
 -1.000000e0 +0.000000e0j * (V(1))
 5.000000e-1 +0.000000e0j * (V(1) V(2))
  1.000000e0 +0.000000e0j * (T(1,2))
  1.000000e0 +0.000000e0j * (T(2,1))
 -1.000000e0 +0.000000e0j * (V(2))
 5.000000e-1 +0.000000e0j * (V(2) V(3))
  1.000000e0 +0.000000e0j * (T(2,3))
  1.000000e0 +0.000000e0j * (T(3,2))
-5.000000e-1 +0.000000e0j * (V(3))
Внутрішні вузли отримують коефіцієнт при , бо входять у два зв'язки, тоді як крайові вузли входять лише в один. Кожен перелічений тут член присутній у графі, намальованому вище. Члени T(j,k) — це його стрілки, а члени V(j) — його вузли.
2. Розбиття на потокові множини
Далі познач кожен член потоковою множиною, до якої він належить. Для цього існує атрибут groups. Гейт Evolution над згрупованим оператором розкладається на один Evolution на кожну групу (крок 6 використовує це), тож групування, вирішене тут на ферміонному рівні, зберігається в схемі.
Для одновимірного ланцюжка дві потокові множини стрибків — це стрілки, орієнтовані на схід (), і стрілки, орієнтовані на захід (). Діагональні члени взаємодії комутують з усім діагональним і утворюють третю групу:
>>> def flow_set_groups(operator):
...     groups = []
...     for terms, _ in operator.iter_terms():
...         match terms:
...             case [(left, right)] if right == left + 1:
...                 groups.append(0)  # east-oriented: T_{j,j+1}
...             case [(left, right)] if right == left - 1:
...                 groups.append(1)  # west-oriented: T_{j+1,j}
...             case _:
...                 groups.append(2)  # diagonal interaction terms
...     return groups
>>>
>>> hamiltonian.groups = flow_set_groups(hamiltonian)
>>> hamiltonian.num_groups()
3
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(index, sorted(terms for terms, _ in group.iter_terms()))
0 [[(0, 1)], [(1, 2)], [(2, 3)]]
1 [[(1, 0)], [(2, 1)], [(3, 2)]]
2 [[], [(0, 0)], [(0, 0), (1, 1)], [(1, 1)], [(1, 1), (2, 2)], [(2, 2)], [(2, 2), (3, 3)], [(3, 3)]]
Групи 0 і 1 — це дві потокові множини. Кожна множина є орієнтованим шляхом уздовж ланцюжка, тому за властивістю потоку всі члени всередині групи комутують.
Кожна група також має бути ермітовою сама по собі, оскільки формула добутку експоненціює групи окремо, а унітарну еволюцію має лише ермітів множник. groups_are_hermitian() це підтверджує:
>>> from qiskit_fermions.operators.terms.grouping import groups_are_hermitian
>>>
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
Тут варто зупинитися, бо дві групи стрибків односпрямовані: група 0 містить лише члени, орієнтовані на схід, а група 1 — лише орієнтовані на захід. Такий поділ гамільтоніана зазвичай порушив би ермітовість, оскільки потребує поруч свого спряженого партнера . TransferVertexOperator уникає цієї проблеми, бо вже ермітів сам по собі. Він є добутком двох майоранівських операторів (див. його визначення в кроці 1), а не голим , тож його образ Джордана-Вігнера має дійсний коефіцієнт, а не уявний. Отже, саме вибір такого подання оператора робить односпрямовану потокову множину законним множником Троттера.
Позначки схід/захід у цьому посібнику геометричні: ланцюжок намальовано зліва направо, а індекси мод зростають у цьому напрямку; вказує на схід, а — на захід. Ref. [1] внутрішньо непослідовна щодо цього називання (її текст і рисунки розходяться), тому цей посібник свідомо не слідує тексту, а натомість зберігає позначки з рисунка. Під час перехресного читання з статтею зіставляй потокові множини за їхніми вагами Паулі (1 і 3 нижче), а не за словами про сторони світу.
3. Напиши власне кодування
Розділ IV B з Ref. [1] класифікує форми, яких може набувати локальне кодування ферміон-у-кубіт, обмежене потоковою множиною. Звичайний Джордан-Вігнер використовує кубітів і відображає кожен член стрибка в Паулі ваги 2. Класифікація показує, що витрата додаткових кубітів купує структуру в закодованих операторах.
Реалізоване тут кодування — це конструкція з делокалізованою парністю з додатка B 2 (рівняння B4 і B5), що використовує один допоміжний кубіт (ancilla), тож . Ферміонну парність делокалізовано на пару кубітів:
Індекс в останньому виразі вимагає додаткового кубіта. Останній зв'язок ланцюжка має , тож його потрапляє на кубіт , на один за останньою ферміонною модою . Цей завершальний кубіт і є допоміжним, і саме тому , а не . Той самий вихід за межі з'являється в , чий припадає на допоміжний кубіт при .
Виграш помітний одразу: одна ціла потокова множина відображається на суму Паулі ваги 1.
Префактори фіксуються нормуванням , а відносний мінус між двома орієнтаціями фіксується тотожністю добутку , яку задовольняють наведені вище Паулі. Помилка в будь-якому з них дає оператор, що підкоряється комутаційним співвідношенням, але вже не представляє той самий гамільтоніан, тож кодування слід перевіряти чисельно, як показано в кроці 4.
Написання кодування означає написання функції, що відображає один узагальнений оператор переносу в рядок Паулі; map_transfer_vertex_generators() бере на себе ітерацію по членах і їхню композицію:
>>> from qiskit.quantum_info import SparseObservable
>>> from qiskit_fermions.mappers import map_transfer_vertex_generators
>>>
>>> def flow_set_action(action, num_qubits):
...     match action:
...         case (j, k) if j == k:
...             # vertex operator: V_j = Z_j Z_{j+1}
...             return SparseObservable.from_sparse_list(
...                 [("ZZ", [j, j + 1], 1.0)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j + 1:
...             # east-oriented transfer operator: weight 1
...             return SparseObservable.from_sparse_list(
...                 [("X", [k], -0.5)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j - 1:
...             # west-oriented transfer operator: weight 3
...             return SparseObservable.from_sparse_list(
...                 [("ZXZ", [k, k + 1, k + 2], 0.5)], num_qubits=num_qubits
...             )
...         case _:
...             raise ValueError(f"not a nearest-neighbor transfer operator: {action}")
>>>
>>> def flow_set_encoding(operator, num_qubits):
...     return map_transfer_vertex_generators(
...         operator,
...         lambda action: flow_set_action(action, num_qubits),
...         identity=lambda: SparseObservable.identity(num_qubits),
...         compose=SparseObservable.compose,
...     ).simplify()
MapperFnEvolutionSynthesis.mapper_fn очікує сигнатуру (operator, num_qubits), а тип повернення має бути SparseObservable, що робить функцію безпосередньо придатною як плагін транспілятора. Див. крок 6.
Застосування його до гамільтоніана з кроку 1 дає закодований оператор на кубітах:
>>> num_qubits = num_sites + 1
>>> encoded = flow_set_encoding(hamiltonian, num_qubits)
>>> for label, indices, coeff in sorted(encoded.to_sparse_list()):
...     print(f"{label:3s} {str(indices):12s} {coeff.real:+.2f}")
    []           +1.50
X   [1]          -0.50
X   [2]          -0.50
X   [3]          -0.50
ZXZ [0, 1, 2]    +0.50
ZXZ [1, 2, 3]    +0.50
ZXZ [2, 3, 4]    +0.50
ZZ  [0, 1]       -0.50
ZZ  [0, 2]       +0.50
ZZ  [1, 2]       -1.00
ZZ  [1, 3]       +0.50
ZZ  [2, 3]       -1.00
ZZ  [2, 4]       +0.50
ZZ  [3, 4]       -0.50
Є 14 членів трьох видів: стрибок перетворився на X та ZXZ, взаємодія — на ZZ, а початковий [] — це одиничний оператор, що додає лише глобальну фазу. Зауваж, що члени ZZ сягають найближчих і наступних за найближчими сусідів; охоплює кубіти від до , і це ціна делокалізації парності.
Групування за потоковою множиною виявляє асиметрію, яку дає ця конструкція. Перелічимо ваги Паулі, наявні в кожній групі:
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     weights = {len(indices) for _, indices, _ in flow_set_encoding(group, num_qubits).to_sparse_list()}
...     print(index, sorted(weights))
0 [1]
1 [3]
2 [0, 2]
Потокова множина, орієнтована на схід (група 0), складається цілком із Паулі ваги 1. Її часова еволюція тому є шаром однокубітних обертань і не потребує заплутувальних гейтів, тоді як за Джордана-Вігнера кожен член стрибка має вагу 2 і вимагає їх. Це компроміс простір-час з Ref. [1] у найпростішій формі: один додатковий кубіт перетворює половину гамільтоніана стрибків на однокубітні обертання.
Потокова множина, орієнтована на захід (група 1), платить за це вагою три, а взаємодія (група 2) має вагу два, де запис ваги нуль — це одиничний оператор. Жодне з цього ще не є твердженням про схему; що синтез робить із цими вагами, — тема кроків 6 і 7.
4. Перевірка кодування
Власне кодування корисне лише тоді, коли воно вірне, і написане вручну слід перевіряти. Оскільки це кодування використовує кубітів, гільбертів простір кубітів удвічі більший за ферміонний, тож закодований гамільтоніан не може дорівнювати гамільтоніану Джордана-Вігнера член за членом. Натомість вони пов'язані ізометрією.
Звідки береться ізометрія: у Джордана-Вігнера базисний стан — це рядок заповнень; кубіт містить . Це кодування натомість зберігає кумулятивні парності. Визначимо
так що біт фіксує парність усіх заповнень до вузла включно. Для заповнень є таких бітів, звідси й береться допоміжний кубіт. Заповнення відновлюється як різниця сусідніх бітів, . Тому зайнятий вузол проявляється як доменна стінка між двома сусідніми бітами, через що це кодування називають кодуванням доменної стінки (або Крамерса-Ваньє). Саме тому також : добуток двох сусідніх зчитує цю різницю.
Якщо виписати це відображення для кількох станів, структура стає наочною (зауваж, що зафіксовано, тому лише половина з станів кубітів потрапляє в образ, а отже, це ізометрія, а не унітарне перетворення):
>>> def domain_wall_bits(occupations):
...     parity = 0
...     bits = [0]
...     for occupation in occupations:
...         parity ^= occupation
...         bits.append(parity)
...     return bits
>>>
>>> for occupations in ([0, 0, 0, 0], [1, 0, 0, 0], [1, 1, 0, 0], [1, 0, 1, 0]):
...     bits = domain_wall_bits(occupations)
...     # little-endian: reversed() prints qubit 0 on the right, as Qiskit labels do
...     print("".join(map(str, occupations)), "->", "".join(str(b) for b in reversed(bits)))
0000 -> 00000
1000 -> 11110
1100 -> 00010
1010 -> 00110
Один ферміон на вузлі 0 перевертає кожну кумулятивну парність над ним, і це і є делокалізація в дії. Зібравши ці стовпці в матрицю, отримуємо ізометрію , а кодування є вірним, коли воно переплітає обидва гамільтоніани:
Тобто відображення ферміонного стану в простір кубітів з подальшою еволюцією там має давати той самий результат, що й спочатку еволюція у ферміонному просторі та відображення після неї.
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp
>>> from qiskit_fermions.mappers.library import transfer_vertex_jordan_wigner
>>>
>>> def to_matrix(observable):
...     # SparseObservable carries no dense-matrix method, so route through
...     # SparsePauliOp. This is only ever needed for the checks below --
...     # the encoding itself never leaves SparseObservable.
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix()
>>>
>>> def domain_wall_isometry(num_sites):
...     isometry = np.zeros((2 ** (num_sites + 1), 2**num_sites), dtype=complex)
...     for index in range(2**num_sites):
...         occupations = [(index >> j) & 1 for j in range(num_sites)]
...         bits = domain_wall_bits(occupations)
...         isometry[sum(b << j for j, b in enumerate(bits)), index] = 1.0
...     return isometry
>>>
>>> isometry = domain_wall_isometry(num_sites)
>>> np.allclose(isometry.conj().T @ isometry, np.eye(2**num_sites))
True
>>>
>>> def intertwines(operator):
...     """Whether both mappings of `operator` agree through the isometry."""
...     flow = to_matrix(flow_set_encoding(operator, num_qubits))
...     reference = to_matrix(transfer_vertex_jordan_wigner(operator, num_sites).simplify())
...     return np.allclose(flow @ isometry, isometry @ reference)
>>>
>>> intertwines(hamiltonian)
True
>>> # and, more strongly, once per flow set: a product formula evolves the groups
>>> # separately, so each one has to be intertwined on its own
>>> all(intertwines(group) for group in hamiltonian.split_out_groups())
True
Співвідношення переплетення виконується точно і окремо для кожної множини потоків. Саме це друге, сильніше твердження використовують наступні кроки: формула добутку еволюціонує групи по одній, а добуток переплетених множників сам є переплетеним, тож будь-яке наближення, побудоване з цих груп, збігається в обох кодуваннях, хоча самі кодування відрізняються. Як наслідок, спектри мають збігатися, причому кожне власне значення Джордана-Вігнера з'являється двічі у більшому просторі, по разу для кожного значення необмеженої глобальної парності:
>>> jw_matrix = to_matrix(transfer_vertex_jordan_wigner(hamiltonian, num_sites).simplify())
>>> flow_matrix = to_matrix(flow_set_encoding(hamiltonian, num_qubits))
>>>
>>> jw_spectrum = np.linalg.eigvalsh(jw_matrix)
>>> flow_spectrum = np.linalg.eigvalsh(flow_matrix)
>>> np.allclose(
...     np.sort(flow_spectrum),
...     np.sort(np.concatenate([jw_spectrum, jw_spectrum])),
... )
True
>>> print(f"{jw_spectrum[0]:.10f}  {flow_spectrum[0]:.10f}")
-1.8557725066  -1.8557725066
5. Побудуй ферміонну схему
Перш ніж залучати будь-які кубіти, динаміка виражається на ферміонному рівні. FermionicCircuit діє на ферміонні моди, а не на кубіти, і вся схема складається з вентиля Evolution над гамільтоніаном:
>>> from qiskit_fermions.circuit import FermionicCircuit
>>> from qiskit_fermions.circuit.library import Evolution
>>> from qiskit_fermions.circuit.library.synthesis import FermionicLieTrotter
>>>
>>> total_time = 1.0
>>> circuit = FermionicCircuit(num_sites)
>>> circuit.append(
...     Evolution(
...         num_sites, hamiltonian, time=total_time, synthesis=FermionicLieTrotter()
...     ),
...     circuit.modes,
... )
>>> circuit.draw("mpl")
<Figure size ... with 1 Axes>

Є один непрозорий блок над усіма чотирма модами, і цікаво, на що він розкладається. Аргумент synthesis визначає, як саме: FermionicLieTrotter є формулою добутку першого порядку, яка розбиває оператор за його groups і еволюціонує кожну групу по черзі. Отже, розбиття на множини потоків з кроку 2 і є тротеризацією, а один виклик decompose() виконує її, даючи один вентиль Evolution на кожну множину потоків у порядку груп: схід, захід, потім діагональна взаємодія, що містять відповідно 3, 3 і 8 доданків.
>>> flow_set_circuit = circuit.decompose()
>>> flow_set_circuit.draw("mpl")
<Figure size ... with 1 Axes>
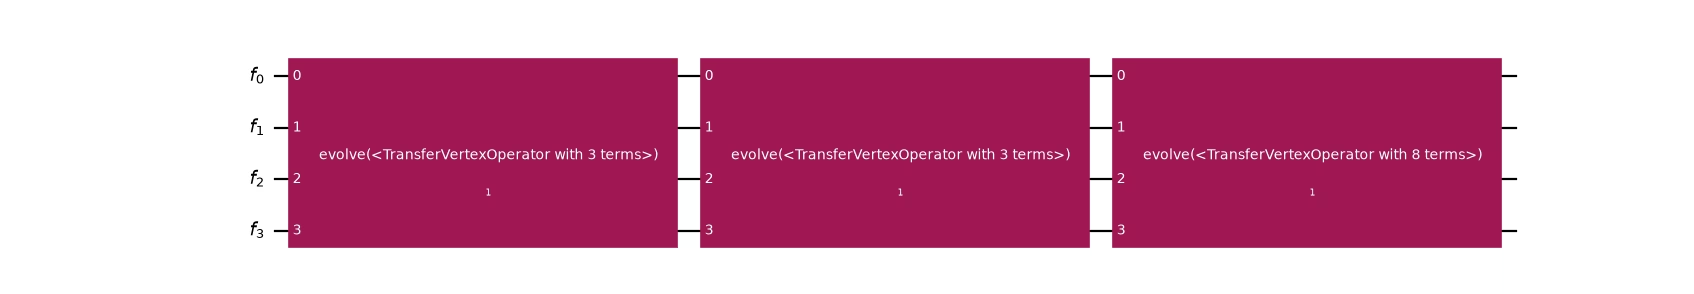
Зауваж, що все це відбувається цілком у ферміонному просторі: жодного кубіта ще не згадано, а наближення вже зроблено. Тому кількість кроків Троттера теж належить сюди, як reps, що ділить час і повторює весь прохід:
>>> def trotter_steps(reps):
...     step = FermionicCircuit(num_sites)
...     step.append(
...         Evolution(
...             num_sites,
...             hamiltonian,
...             time=total_time,
...             synthesis=FermionicLieTrotter(reps=reps),
...         ),
...         step.modes,
...     )
...     return step.decompose()
>>>
>>> trotter_steps(3).count_ops()["Evolution"]
9
Дев'ять вентилів: три множини потоків, пройдені циклічно тричі, кожна за третину часу. Саме це циклічне чергування робить це тротеризацією, а не повторним нарізанням однієї групи. Повторення однієї групи нічого не дало б, бо послідовні експоненти того самого оператора комутують, тож A(t/3) A(t/3) A(t/3) — це просто A(t). Формула, яка зчитує групи, може їх чергувати; формула, застосована після відображення, не може, бо групування на той момент уже втрачено.
Саме цей крок робить групування значущим. Кожен згенерований вентиль відображається й синтезується незалежно, тож усе подальше діє на розбиття, визначене на ферміонному рівні. Якщо пропустити декомпозицію, весь оператор передається наступному етапові цілком, і групування ігнорується.
6. Транспілюй із користувацьким кодуванням
Тепер кодування готове до використання транспілятором. Потрібні ще два елементи:
-
Розташування (layout). Типовий
TrivialF2QLayoutприпускає один кубіт на моду, що в цій ситуації хибно.CustomF2QLayoutзіставляє ферміонний регістр ізQuantumRegisterіншого розміру, і саме так допоміжні кубіти потрапляють у конвеєр. -
Плагін синтезу.
MapperFnEvolutionSynthesisбезпосередньо приймає функцію мапера, відображає з її допомогою гамільтоніан вентиляEvolutionі видаєPauliEvolutionGate, зберігаючи конвенцію . Йогоproduct_formulaвизначає, як цей вентиль перетворюється на обертання. Зауваж, що це друга, незалежна формула добутку, яка діє на кубіти після відображення: сюди передаєтьсяLieTrotterіз Qiskit, а крок 7 замінює його таким, що знає про множини потоків.
Оскільки кожне порівняння нижче повторно запускає цей конвеєр, його варто один раз обгорнути у функцію:
>>> from qiskit.circuit import QuantumRegister
>>> from qiskit.passmanager import MultiStagePassManager
>>> from qiskit_fermions.transpiler import FermionicCircuitToDAG, QuantumDAGToCircuit
>>> from qiskit_fermions.transpiler.passes import (
...     CustomF2QLayout,
...     F2QSynthesis,
...     MapperFnEvolutionSynthesis,
... )
>>>
>>> def flow_set_pass_manager(mode_register, product_formula=None):
...     '''Build the pipeline mapping `mode_register` with the flow-set encoding.'''
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         flow_set_encoding, product_formula=product_formula
...     )
...     # this encoding spends one ancilla on top of the fermionic modes
...     qubit_register = QuantumRegister(mode_register.size + 1, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from qiskit.synthesis import LieTrotter
>>>
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, LieTrotter())
>>> qubit_circuit = pass_manager.run(flow_set_circuit)
>>> qubit_circuit.num_qubits
5
Чотири ферміонні моди стали п'ятикубітною схемою, де допоміжний кубіт надає користувацьке розташування.
Тепер подивимося, що насправді містить отримана схема. Багаторазова декомпозиція зводить вентилі еволюції аж до U і CX, щоб двокубітну вартість двох стратегій синтезу, які порівнюються нижче, вимірювати в одній «валюті»: count_ops() тоді повідомляє кількість CX, а depth() приймає функцію-фільтр для вимірювання двокубітної глибини. Зауваж, що цей reps є глибиною декомпозиції, не пов'язаною з кількістю кроків Троттера, яку формула добутку приймає і яка далі в цьому посібнику також зветься reps:
>>> decomposed = qubit_circuit.decompose(reps=6)
>>> decomposed.count_ops()["cx"]
26
>>> decomposed.depth(lambda instruction: len(instruction.qubits) == 2)
23
Двадцять шість вентилів CX у двадцяти трьох шарах, тож майже нічого не виконується паралельно. Малюнок схеми показує чому:
>>> decomposed.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
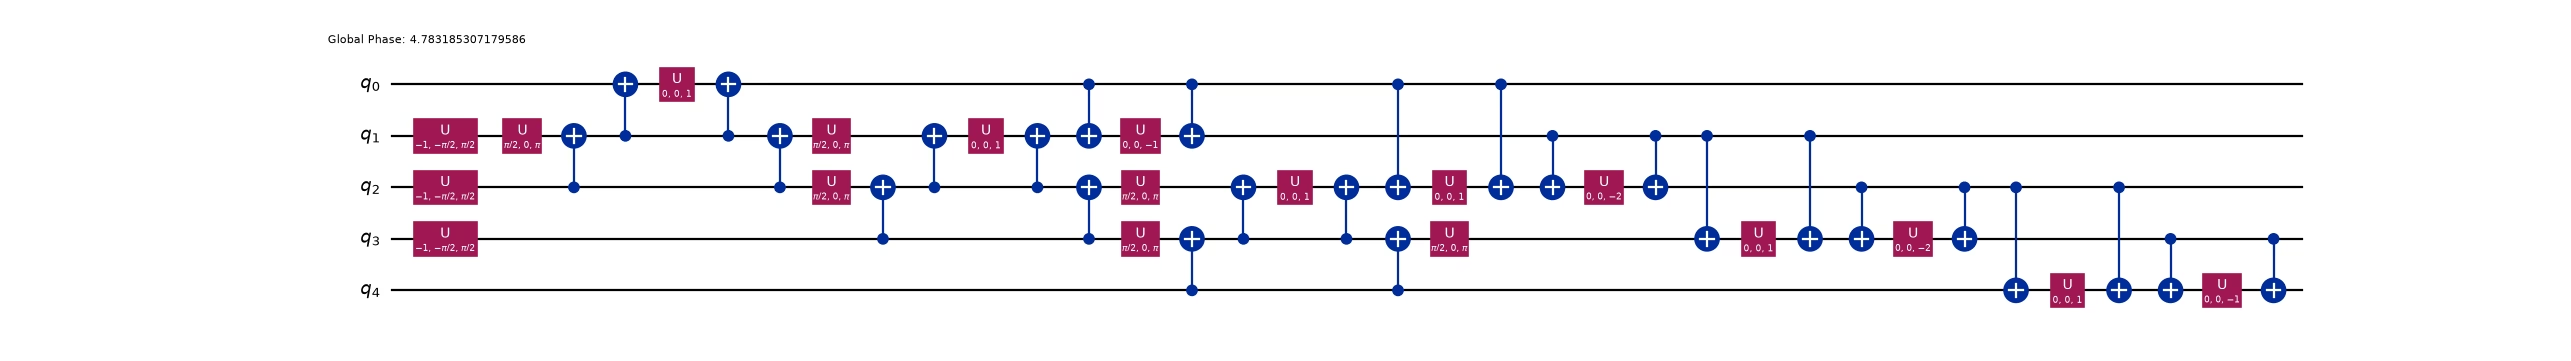
Кожен доданок скомпільовано окремо: зміна базису, драбина CX до єдиного обертання, потім драбина скасовується. Множина потоків ваги 1 безкоштовна; її доданки — поодинокі обертання без драбин навколо, але кожен доданок ваги 3 коштує чотири вентилі CX, і оскільки драбини видаються послідовно, ніщо не перекривається.
Отже, групування переживає весь конвеєр (три множини потоків, три відображені PauliEvolutionGate) і все одно майже нічого не дає. Ферміонна тротеризація кроку 5 виконала свою роботу; марнує її формула на боці кубітів. LieTrotter отримує набір доданків, про які їй випадково нічого не повідомлено, і компілює кожен окремо. Вона не може знати, що вони взаємно комутують, тож серіалізує те, що могло б ділити одну зміну базису.
Саме цю прогалину має закрити це кодування: працюють дві формули добутку, а структуру досі отримала лише ферміонна. Наступний крок пропонує синтез на боці кубітів, який також її використовує.
7. Синтез, що враховує множини потоків
Щоб повернути перевагу, потрібно повідомити синтезу на боці кубітів про структуру. Це розділ IV C із джерела [1]: оскільки всі доданки множини потоків комутують, їх можна одночасно діагоналізувати одним кліффордівським колом, обертаючи в одному спільному базисі й повертаючи назад, замість того, щоб робити це для кожного доданка окремо.
Для цього кодування кліффорд простий. Спряження ланцюжком вентилів CZ між найближчими сусідами відображає
одночасно для кожного . Один ланцюжок CZ перетворює всю множину потоків ваги 3 (захід) на шар незалежних однокубітних обертань . Інтерфейс EvolutionSynthesis вимагає лише методу synthesize(), який і реалізує цей клас. Він не містить кількості кроків Троттера, бо отримує по одній множині потоків за раз і тому не може розподілити еволюцію між множинами. Цей розподіл належить рівнем вище, у ферміонному просторі, де F2FSynthesisPlugin бачить їх усі одночасно (див. крок 9):
>>> from qiskit.circuit import QuantumCircuit
>>> from qiskit.synthesis.evolution import EvolutionSynthesis
>>>
>>> def cz_brickwork(circuit):
...     # emit even and odd bonds as two layers, so the CZs are scheduled in
...     # parallel: a chain of overlapping CZs has depth 2, not num_qubits - 1
...     #
...     # NOTE: CZ gates are diagonal, so they all commute and each is its own inverse.
...     # This whole layer is therefore self-inverse, which is why the conjugation below
...     # calls it twice rather than calling it and then its inverse.
...     for offset in (0, 1):
...         for j in range(offset, circuit.num_qubits - 1, 2):
...             circuit.cz(j, j + 1)
>>>
>>> # The interaction reaches nearest (distance 1) and next-nearest (distance 2)
>>> # neighbors, so every interior qubit carries four Rzz gates and can only do one at
>>> # a time: four layers is the best any schedule can do. These offsets achieve it.
>>> def rzz_layers(circuit, angles):
...     """Emit the diagonal Rzz gates in four layers of disjoint qubit pairs."""
...     near = [(j, k) for j, k in angles if k - j == 1]
...     far = [(j, k) for j, k in angles if k - j == 2]
...     schedule = [
...         [(j, k) for j, k in near if j % 2 == 0],
...         [(j, k) for j, k in far if j % 4 in (0, 1)],
...         [(j, k) for j, k in near if j % 2 == 1],
...         [(j, k) for j, k in far if j % 4 in (2, 3)],
...     ]
...     # emit layer by layer, since Qiskit's depth follows the order gates were added
...     for layer in schedule:
...         for j, k in layer:
...             circuit.rzz(angles[j, k], j, k)
>>>
>>> class FlowSetSynthesis(EvolutionSynthesis):
...     '''Synthesize one flow set of the encoded Hamiltonian at a time.'''
...
...     preserve_order = True
...
...     def synthesize(self, evolution):
...         circuit = QuantumCircuit(evolution.operator.num_qubits)
...         east, west, diagonal = [], [], {}
...
...         for label, indices, coeff in evolution.operator.to_sparse_list():
...             angle = 2 * evolution.time * coeff.real
...             match label, indices:
...                 case "", _:  # the identity contributes only a global phase
...                     circuit.global_phase -= angle / 2
...                 case "X", [qubit]:  # east flow set: already weight-1
...                     east.append((qubit, angle))
...                 case "ZXZ", [j, k, l] if (k, l) == (j + 1, j + 2):
...                     west.append((k, angle))  # needs the CZ conjugation below
...                 case "ZZ", [j, k]:  # interaction: diagonal, see rzz_layers above
...                     diagonal[min(j, k), max(j, k)] = angle
...                 case _:
...                     raise ValueError(f"unexpected Pauli term: {label} on {indices}")
...
...         # east flow set: bare rotations, no entangling gates at all
...         for qubit, angle in east:
...             circuit.rx(angle, qubit)
...
...         # west flow set: one CZ chain diagonalizes the WHOLE set at once
...         if west:
...             cz_brickwork(circuit)
...             for qubit, angle in west:
...                 circuit.rx(angle, qubit)
...             cz_brickwork(circuit)
...
...         if diagonal:
...             rzz_layers(circuit, diagonal)
...
...         return circuit
Дві деталі легко пропустити. Користувацький EvolutionSynthesis має містити атрибут preserve_order, який зчитує прохід високорівневого синтезу.
Обидва допоміжні засоби видають свої вентилі явними шарами, а не в порядку доданків, бо depth() розташовує вентилі якомога раніше, у порядку їх додавання. Оскільки всі вентилі всередині однієї з цих множин комутують, порядок можна обирати вільно. Синтез доданок за доданком обирає порядок погано. Якщо видавати перекривний ланцюжок CZ послідовно, то буде повідомлено глибину, що зростає з кількістю кубітів, а не сталу 2, яку могло б досягти обладнання.
Саме тому синтез вище не містить кількості кроків Троттера. Він отримує одну множину потоків на вентиль, тож повторення всередині нього повторювало б в межах множини, а не чергувало б їх між собою:
repeating within one set:      A(t/2) A(t/2) B(t/2) B(t/2)
what a Trotterization needs:   A(t/2) B(t/2) A(t/2) B(t/2)
Перша форма нічого не дає: послідовні експоненти того самого оператора комутують, тож A(t/2) A(t/2) — це просто A(t), і похибка лишається на рівні одного кроку, скільки б кроків не запитували.
Тому кількість кроків належить ферміонному FermionicLieTrotter з кроку 5, який зчитує groups і може їх чергувати. У такому розподілі праці й полягає суть: ферміонна формула визначає, скільки кроків і в якому порядку, а цей клас вирішує, наскільки дешево реалізується кожна отримана множина.
Щоб обрати порядок, передай його в MapperFnEvolutionSynthesis.product_formula, що є аргументом, який приймає flow_set_pass_manager. Більше нічого в конвеєрі (чи у ферміонній схемі, на якій він працює) не змінюється:
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, FlowSetSynthesis())
>>>
>>> flow_circuit = pass_manager.run(flow_set_circuit).decompose(reps=6)
>>> flow_circuit.count_ops()["cx"]
22
>>> flow_circuit.depth(lambda instruction: len(instruction.qubits) == 2)
12
>>> flow_circuit.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
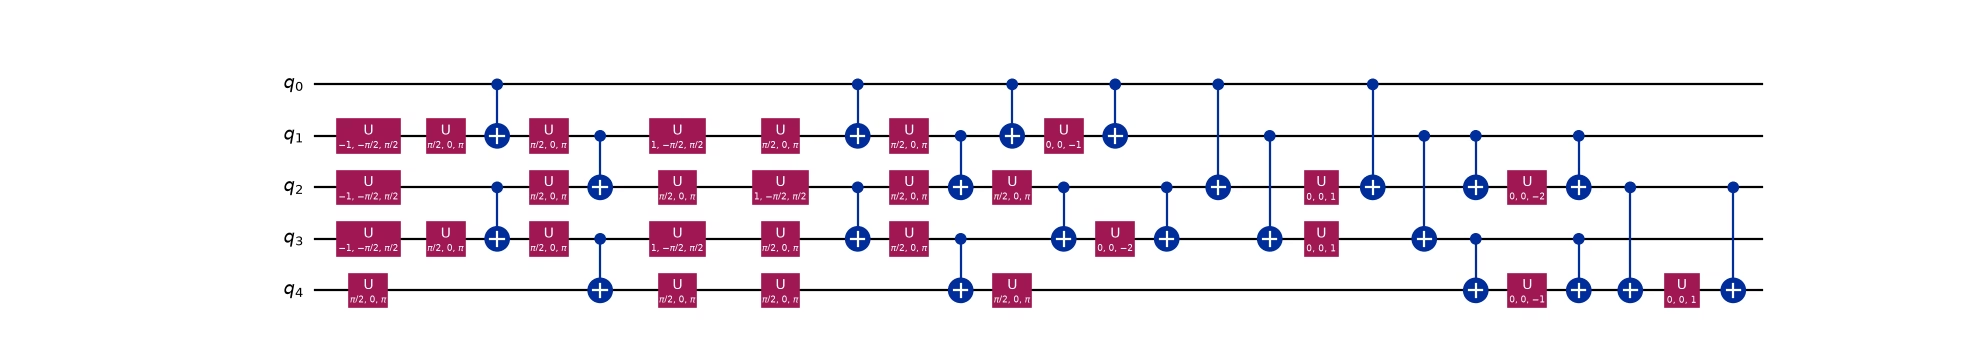
Із глибини 23 та 26 вентилів CX до глибини 12 та 22 вентилів CX. Зауваж, що це менше заплутувальних вентилів і майже вдвічі менша глибина. Порівнявши два малюнки, видно, що різниця не в тому, що вентилі дешевші, а в тому, що вони вкладаються стосом. Послідовні драбини зникли; заплутувальні вентилі тепер розташовані один над одним у спільних шарах, бо вся західна множина потоків обертається в одному спільному базисі, а взаємодія видається шарами неперетинних пар.
FlowSetSynthesis зіставляє зі шаблоном абсолютні індекси кубітів, що тут безпечно лише тому, що кожна множина потоків цього гамільтоніана охоплює весь регістр. Ферміонна формула добутку звужує кожен множник до мод, яких він справді торкається, тож групування, чиї множини покривали б лише частину ланцюжка, надійшло б з переіменованими індексами, і наведені вище шаблони не збіглися б.
Обидва малюнки показують схему після decompose(reps=6), що переписує все в базис U і CX, тому вентилі CZ, Rx і Rzz, які видає FlowSetSynthesis, як такі не видно. Це зроблено навмисно: так обидві схеми опиняються в одному базисі, що є єдиним способом зробити двокубітні кількості й глибини вище співставними. У цих малюнках варта уваги саме шарова структура, а не назви вентилів.
8. Стала глибина у великому масштабі
Цікаве питання не в кількості при чотирьох модах, а в тому, як вона масштабується. Два шари цегляної кладки CZ не зростають із довжиною ланцюжка, тож двокубітна глибина одного кроку Троттера має бути сталою. Вимірюємо її безпосередньо на повному гамільтоніані Фермі-Габбарда, далеко за межами того, що можна змоделювати грубою силою:
>>> def evolution_stats(num_sites, product_formula):
...     operator = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
...     operator.groups = flow_set_groups(operator)
...
...     circuit = FermionicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, operator, time=total_time, synthesis=FermionicLieTrotter()
...         ),
...         circuit.modes,
...     )
...     circuit = circuit.decompose()  # one Evolution per flow set, as in step 5
...
...     pass_manager = flow_set_pass_manager(circuit.register, product_formula)
...     decomposed = pass_manager.run(circuit).decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     return decomposed.count_ops()["cx"], decomposed.depth(two_qubit)
>>>
>>> sites = [4, 10, 20, 50, 100]
>>> flow = [evolution_stats(n, FlowSetSynthesis()) for n in sites]
>>> lie_trotter = [evolution_stats(n, LieTrotter()) for n in sites]
>>>
>>> [depth for _, depth in flow]
[12, 12, 12, 12, 12]
>>> [depth for _, depth in lie_trotter]
[23, 47, 87, 207, 407]
Двокубітна глибина лишається 12 від чотирьох мод до 100, тоді як у LieTrotter вона лінійно зростає до 407. Множини потоків дозволяють трохи розпаралелити в межах конвеєра, але кожна множина все одно тротеризується доданок за доданком, тож зростання лише сповільнюється, а не усувається:
>>> import matplotlib.pyplot as plt
>>>
>>> figure, axes = plt.subplots(1, 2, figsize=(9, 3.5), layout="constrained")
>>> for panel, index, title in zip(axes, (1, 0), ("two-qubit depth", "CX count")):
...     _ = panel.plot(sites, [stat[index] for stat in lie_trotter], "o-", label="qubit-level")
...     _ = panel.plot(sites, [stat[index] for stat in flow], "s-", label="flow set")
...     _ = panel.set(xlabel="modes", title=title)
...     _ = panel.legend()
>>> figure
<Figure size ... with 2 Axes>

Кількість вентилів зростає лінійно в обох випадках (є доданків, які треба застосувати, і цього не уникнути), але синтез за множинами потоків застосовує їх у сталій кількості паралельних шарів. Це результат сталої глибини з джерела [1].
Глибина 12 розподіляється між трьома множинами потоків як 0 + 4 + 8 за будь-якої довжини ланцюжка. Східна множина потоків дає нуль; це чисті обертання Rx. Західна множина коштує 4: два шари цегляної кладки CZ на вході та два на виході; якщо відкинути взаємодію, двокубітна глибина лишається чотири за будь-якої довжини ланцюжка. Решта, вісім, — це взаємодія, чиї доданки Rzz діють і на найближчих, і на наступних за найближчими сусідів, а тому потребують чотирьох неперетинних шарів, кожен із яких коштує два вентилі CX. Чотири тут оптимально: кожен внутрішній кубіт несе чотири вентилі Rzz (по два до кожного сусіда і по два до кожного наступного за найближчим) і може брати участь лише в одному одночасно, тож жоден розклад не може бути кращим.
Дві третини глибини припадає на взаємодію, що показує: це кодування особливо добре справляється зі стрибками, а отже й з динамікою ланцюжка вільних ферміонів. Проте зауваж, що взаємодія не комутує зі стрибками. Якщо її відкинути, це не наближення до Фермі-Габбарда, а інша модель. Де саме встановлюється баланс для конкретної задачі, варто дослідити.
9. Перевір динаміку
За відображення доменної стінки (domain-wall) шаблон заповнення стає рядком кумулятивної парності, тож початковий стан готується інакше, ніж за Джордана-Вігнера. Це легко пропустити практичний наслідок делокалізації парності. Допоміжна функція з кроку 4 дає правильну мітку:
>>> occupations = [1, 0, 1, 0]
>>> initial_label = "".join(str(b) for b in reversed(domain_wall_bits(occupations)))
>>> initial_label
'00110'
Із підготовленим станом лишаються два питання, і їх краще ставити окремо: чи обчислює синтез за множинами потоків правильну річ і чи робить він це дешевше?
Спершу правильність. FlowSetSynthesis і LieTrotter із Qiskit отримують ті самі закодовані множини потоків від тієї самої ферміонної тротеризації, тож вони мають реалізовувати те саме унітарне перетворення з точністю до глобальної фази. Користувацькі кліффорди лише переорганізовують роботу; вони не змінюють результату. Випадкові вектори станів виявляють будь-яку розбіжність значно дешевше, ніж побудова повного унітарного перетворення:
>>> from qiskit.quantum_info import Statevector
>>>
>>> rng = np.random.default_rng(1234)
>>>
>>> def agrees_up_to_one_phase(reps, samples=3):
...     """Compare both qubit-side syntheses of the same fermionic Trotterization."""
...     step = trotter_steps(reps)
...     trotter = flow_set_pass_manager(step.register, LieTrotter()).run(step)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     trotter, flow = trotter.decompose(reps=6), flow.decompose(reps=6)
...     dimension = 2**trotter.num_qubits
...     residuals, phases = [], []
...     for _ in range(samples):
...         vector = rng.normal(size=dimension) + 1j * rng.normal(size=dimension)
...         state = Statevector(vector / np.linalg.norm(vector))
...         a = state.evolve(trotter).data
...         b = state.evolve(flow).data
...         overlap = np.vdot(a, b)
...         phases.append(overlap / abs(overlap))
...         residuals.append(np.linalg.norm(b - a * overlap / abs(overlap)))
...     # the SAME global phase must work for every input state
...     spread = max(abs(phase - phases[0]) for phase in phases)
...     return bool(max(residuals) < 1e-9), bool(spread < 1e-9)
>>>
>>> [agrees_up_to_one_phase(reps) for reps in (1, 3)]
[(True, True), (True, True)]
Обидві половини цієї перевірки важливі. Перекриття з одиничним модулем на одному стані необхідне, але недостатнє: синтез, що помилився у фазі, залежній від стану, все одно б це показав. Вимога тієї самої фази на кількох випадкових станах закриває цю прогалину. Перевірка більш ніж одного значення reps теж важлива, бо підтверджує, що збіг переживає чергування множин потоків, а не виконується лише для одного проходу.
Отже, вибір синтезу на боці кубітів не впливає на точність, що й робить порівняння вартості змістовним. Лишається питання, що дає кодування загалом порівняно з очевидною альтернативою: звичайним Джорданом-Вігнером на num_sites кубітах, без допоміжного кубіта і без користувацьких кліффордів. Між двома стовпцями відрізняються і кодування, і синтез на боці кубітів, але перевірка вище показала, що останній не може впливати на результат, тож вірогідності перевіряють саме кодування. Обидва конвеєри також починають із тієї самої ферміонної тротеризації, тож будь-яка різниця у вірогідності вказувала б на помилку, а не на компроміс. Два стовпці — це кодування, множини потоків проти Джордана-Вігнера:
>>> def jordan_wigner_pass_manager(mode_register, product_formula):
...     """The same pipeline under plain Jordan-Wigner: one qubit per mode."""
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         transfer_vertex_jordan_wigner, product_formula=product_formula
...     )
...     qubit_register = QuantumRegister(mode_register.size, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from scipy.linalg import expm
>>>
>>> jw_state = np.zeros(2**num_sites, dtype=complex)
>>> jw_state[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> reference_jw = expm(-1j * total_time * jw_matrix) @ jw_state
>>> reference_flow = expm(-1j * total_time * flow_matrix) @ (isometry @ jw_state)
>>>
>>> def cost_and_fidelity(reps):
...     step = trotter_steps(reps)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     jw = jordan_wigner_pass_manager(step.register, LieTrotter()).run(step)
...     flow, jw = flow.decompose(reps=6), jw.decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     evolved_flow = Statevector.from_label(initial_label).evolve(flow).data
...     evolved_jw = Statevector(jw_state).evolve(jw).data
...     return (
...         abs(np.vdot(evolved_flow, reference_flow)) ** 2,
...         flow.count_ops()["cx"],
...         flow.depth(two_qubit),
...         abs(np.vdot(evolved_jw, reference_jw)) ** 2,
...         jw.count_ops()["cx"],
...         jw.depth(two_qubit),
...     )
>>>
>>> for reps in (1, 2, 4, 8):
...     flow_f, flow_cx, flow_d, jw_f, jw_cx, jw_d = cost_and_fidelity(reps)
...     print(
...         f"{reps} step(s):  flow set {flow_f:.6f}"
...         f" ({flow_cx:3d} CX, depth {flow_d:3d})"
...         f"   JW {jw_f:.6f} ({jw_cx:3d} CX, depth {jw_d:3d})"
...     )
1 step(s):  flow set 0.590661 ( 22 CX, depth  12)   JW 0.590661 ( 18 CX, depth  14)
2 step(s):  flow set 0.926656 ( 44 CX, depth  24)   JW 0.926656 ( 36 CX, depth  26)
4 step(s):  flow set 0.982053 ( 88 CX, depth  48)   JW 0.982053 ( 72 CX, depth  50)
8 step(s):  flow set 0.995395 (176 CX, depth  96)   JW 0.995395 (144 CX, depth  98)
Спершу прочитай стовпець вірогідності: однаково, до кожної надрукованої цифри, у двох різних гільбертових просторах за двох різних кодувань. Це проявляється ферміонна тротеризація. Наближення було зафіксовано на кроці 5, до вибору будь-якого кодування, тож обидві схеми несуть точно похибку формули першого порядку по трьох множинах потоків, і вона спадає приблизно вчетверо при подвоєнні кількості кроків.
Відрізняються кодування вартістю, і компроміс варто висловити прямо. Множина потоків витрачає більше заплутувальних вентилів: 22 проти 18 за один крок. Причина не в допоміжному кубіті, бо він не несе власного двокубітного вентиля. Причина у взаємодії, саме як застерігав крок 3: делокалізація парності перетворює три доданки ZZ між найближчими сусідами на сім, що охоплюють найближчих і наступних за найближчими сусідів, і кожен коштує два вентилі CX. Це ціна за здешевлення стрибків.
За глибиною воно також виграє лише ледь-ледь при такому розмірі (12 проти 14), бо чотири моди надто мало, щоб проявилася асимптотика. Суть у масштабуванні, виміряному в кроці 8: ця глибина 12 стала, тоді як глибина Джордана-Вігнера зростає з ланцюжком. При 14 модах вона вже 12 проти 34.
Виклики decompose() вище є суттєвими з двох незалежних причин.
evolve() і Operator використовують точне означення PauliEvolutionGate, оминаючи користувацький синтез на боці кубітів. Перевірка проти недекомпозованої схеми повідомляє про ідеальну вірогідність навіть для навмисно хибного синтезу.
Те саме стосується рівня вище, ферміонного синтезу. Вентиль Evolution, який ніколи не декомпонується, потрапляє на етап «ферміон-у-кубіт» цілком, і той відображає його, не звертаючись до Evolution.synthesis узагалі, тож reps мовчки не мав би жодного ефекту. trotter_steps з кроку 5 виконує цю декомпозицію; конвеєр, що задає метод через F2FSynthesis, отримує те саме розгортання від проходу.
Як остання перехресна перевірка, густини вузлів , обчислені в закодованому просторі, мають відтворювати результат Джордана-Вігнера. Ця перевірка стосується кодування, а не схеми, тож наближення Троттера в неї не входить. Обидві часові еволюції обчислюються точно, матричною експонентою відповідних гамільтоніанів. Тому будь-яка розбіжність вказувала б на кодування, а не на формулу добутку:
>>> time = 0.8
>>> state_jw = np.zeros(2**num_sites, dtype=complex)
>>> state_jw[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> evolved_jw = expm(-1j * time * jw_matrix) @ state_jw
>>> evolved_flow = expm(-1j * time * flow_matrix) @ (isometry @ state_jw)
>>>
>>> for j in range(num_sites):
...     v_flow = to_matrix(
...         SparseObservable.from_sparse_list([("ZZ", [j, j + 1], 1.0)], num_qubits)
...     )
...     v_jw = to_matrix(SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_sites))
...     density_flow = (1 - np.vdot(evolved_flow, v_flow @ evolved_flow).real) / 2
...     density_jw = (1 - np.vdot(evolved_jw, v_jw @ evolved_jw).real) / 2
...     print(f"site {j}:  {density_flow:.10f}  {density_jw:.10f}")
site 0:  0.6507935456  0.6507935456
site 1:  0.5963201678  0.5963201678
site 2:  0.3365016619  0.3365016619
site 3:  0.4163846247  0.4163846247
Густини збігаються до десяти знаків після коми.
Що варто винести
-
Групуй до відображення. Множини потоків визначаються на орієнтованому ферміонному графі взаємодій, тож групування обирається, поки структура задачі ще доступна. Атрибут
groupsпереносить її у схему, де одинdecompose()перетворює її на один вентильEvolutionна кожну множину потоків. -
Допоміжні кубіти купують структуру. Один додатковий кубіт перетворює цілу множину потоків на паулієві оператори ваги 1, еволюція яких не потребує заплутувальних вентилів. Джерело [1] загалом спостерігає цей компроміс. Більші співвідношення кубітів до ферміонів допускають мілкіші схеми еволюції.
-
Користувацьке кодування — це одна функція. Відобрази один узагальнений оператор переносу на паулієвий рядок; решту зроблять
map_transfer_vertex_generators()іMapperFnEvolutionSynthesis. -
Самого відображення й групування недостатньо. Розбиття еволюції за множинами потоків лише сповільнило лінійне зростання глибини; синтез кожної множини доданок за доданком усе одно відкидав те, що її доданки комутують. Лише надання
EvolutionSynthesis, що враховує множини потоків, зробило глибину сталою. Користувацькі кодування, групування та користувацький синтез доповнюють одне одного: потрібні всі три. -
Дві формули добутку, дві задачі.
FermionicLieTrotterфіксує наближення у ферміонному просторі, де групування ще видно, тож лише він задає похибку Троттера й кількість кроків. ТодіEvolutionSynthesisна боці кубітів визначає лише те, наскільки дешево реалізується кожна множина: крок 9 підтверджує, що обидва вибори дають те саме унітарне перетворення. Саме розділення цих двох дозволяє налаштовувати точність і вартість незалежно. Див. Синтез вентиля Evolution у ферміонному просторі. -
Перевіряй. Кодування, що задовольняє співвідношення комутації, усе одно може представляти інший гамільтоніан, якщо множник або знак неправильні. Перевірка співвідношення переплетення (або, дешевше, спектра) це виявляє.
FlowSetSynthesis вище навмисно написаний для цього кодування на одновимірному ланцюжку. Він зіставляє зі шаблоном конкретні паулієві мітки, які створює кодування, і викликає помилку на будь-чому іншому, замість того щоб мовчки повертатися до загальної формули добутку. Загальна реалізація має дві половини. Зчитування структури множин потоків із groups оператора — це те, що вже робить F2FSynthesisPlugin для еволюції. Виведення діагоналізувального кліффорда зі стабілізаторної групи, як описано в розділі IV C джерела [1], є половиною, що лишається специфічною для кодування.
Крім того, делокалізація парності робить член взаємодії вагою 2, а не діагональним в окремих кубітах, що є зворотною вартістю дешевших членів стрибків.
Далі: два виміри
Усе вище одновимірне, і то навмисно. На ланцюжку множини потоків — це просто дві орієнтації стрілок, а кодуванню потрібен єдиний допоміжний кубіт. Жодне зі спрощень не переживе перехід у два виміри, а саме там потрібні локальні кодування.
На планарній ґратці множина потоків — це орієнтований шлях (або об'єднання неперетинних за вершинами орієнтованих шляхів) через граф взаємодій, і пошук малого набору таких шляхів, що покриває кожне ребро, стає самостійною комбінаторною задачею, а не двохрядковою класифікацією. Змінюється й характер кодувань; замість єдиного допоміжного кубіта на весь ланцюжок вони додають по одному на вузол або комірку ґратки. Верстрате-Цірак (Verstraete-Cirac) пов'язує кожен ферміонний вузол із його власним допоміжним кубітом, співвідношення кубітів до мод дорівнює , тоді як Дербі-Кляссен (Derby-Klassen) розміщує по одному в центрі кожної непарної плакети, зі співвідношенням . Тоді розташування регістра має справжню двовимірну структуру, а стабілізаторна група, на яку треба проєктувати, більше не тривіальна. Закодований гамільтоніан вірний лише на підпросторі, що змінює і підготовку стану, і рецепт перевірки з кроку 4.
Елементи, які будує цей посібник, переносяться далі: CustomF2QLayout для регістра, розмір якого відрізняється від кількості мод, map_transfer_vertex_generators() для самого кодування, MapperFnEvolutionSynthesis для підключення його до транспілятора та користувацький EvolutionSynthesis, щоб структура множин потоків окупилася. Відрізняються лише кодування та декомпозиція на множини потоків.
Посібник із двовимірних множин потоків продовжує тут, розбираючи кодування Верстрате-Цірака на квадратній ґратці: чотири множини потоків, кліффорд глибини 2 для кожної та стабілізаторна проєкція, якої потім потребує перевірка.
A. Gandon, S. Piccinelli, M. Rossmannek, F. Tacchino, A. Baiardi, J. Nys, and I. Tavernelli, Stabilizer-based quantum simulation of fermion dynamics with local qubit encodings (2026), arXiv:2512.11418v2.