Використовуй різні Lp-норми для відкидання паулівських доданків
Примітка: Перш ніж читати цей посібник, прочитай посібник Truncate Pauli terms, який описує усічення доданків Паулі з малою вагою, вбудоване в метод backpropagate на основі заданого TruncationErrorBudget.
У цьому посібнику ти дізнаєшся про іменований аргумент p_norm методу backpropagate, за допомогою якого можна змінити Lp-норму, що використовується для оцінки похибки, яку вносять усічені доданки Паулі.
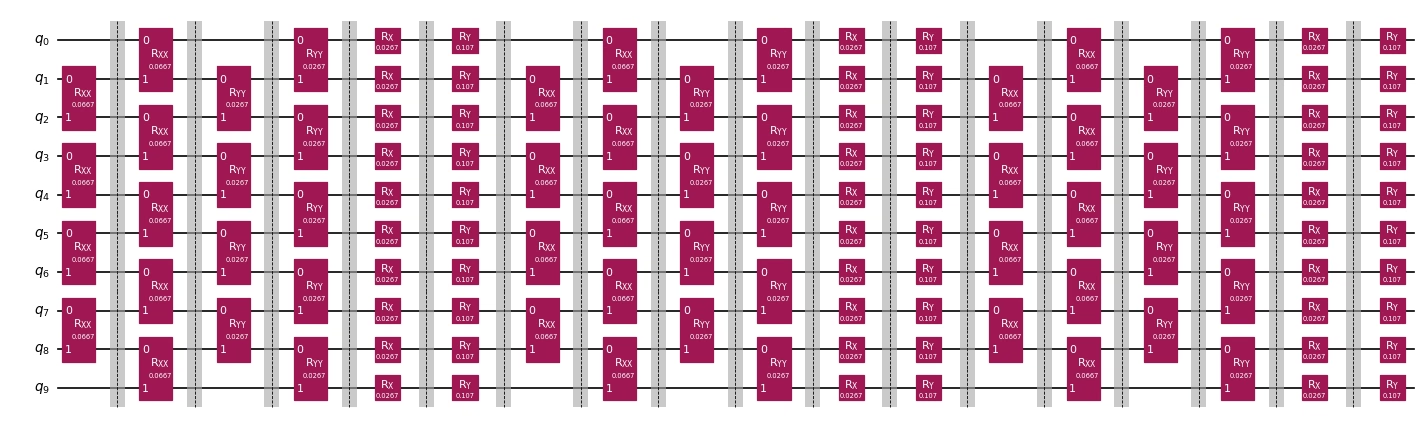
Побудова прикладу схеми
У цьому посібнику використовується та сама приклади схема, що й у посібнику Truncate Pauli terms:
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "qiskit": "qiskit", "qiskit_addon_obp": "qiskit-addon-obp", "qiskit_addon_utils": "qiskit-addon-utils", "rustworkx": "rustworkx"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import rustworkx.generators
from qiskit.synthesis import LieTrotter
from qiskit_addon_utils.problem_generators import (
    PauliOrderStrategy,
    generate_time_evolution_circuit,
    generate_xyz_hamiltonian,
)
from qiskit_addon_utils.slicing import combine_slices, slice_by_gate_types

# Generate a linear chain of 10 qubits
num_qubits = 10
linear_chain = rustworkx.generators.path_graph(num_qubits)

# Use an arbitrary XY model
hamiltonian = generate_xyz_hamiltonian(
    linear_chain,
    coupling_constants=(0.05, 0.02, 0.0),
    ext_magnetic_field=(0.02, 0.08, 0.0),
    pauli_order_strategy=PauliOrderStrategy.InteractionThenColor,
)
# Evolve for some time
circuit = generate_time_evolution_circuit(
    hamiltonian, synthesis=LieTrotter(reps=3), time=2.0
)
# slice the circuit by gate type
slices = slice_by_gate_types(circuit)

# For visualization purposes only, recombine the slices with barriers between them and draw the resulting circuit
combine_slices(slices, include_barriers=True).draw("mpl", fold=50, scale=0.6)
Визнач спостережувану для повної намагніченості:
from qiskit.quantum_info import SparsePauliOp

obs = SparsePauliOp.from_sparse_list(
    [("Z", [i], 1.0) for i in range(num_qubits)], num_qubits=num_qubits
)
Для порівняння обчисли точне очікуване значення:
from qiskit.primitives import StatevectorEstimator

estimator = StatevectorEstimator()
job = estimator.run([(circuit, obs)])
res = job.result()
exact_exp = res[0].data.evs
print(exact_exp)
9.318197859862146
Використання L1-норми
За замовчуванням, як ти вже бачив у посібнику Truncate Pauli terms, p_norm=1, що означає, що похибка оцінюється так:
де — квантовий стан, — справжня різниця між точною та усіченою спостережуваною (яка невідома), — множина усічених доданків Паулі, а — коефіцієнт доданка Паулі.
Ця нерівність є строгою, але для більшості сценаріїв дуже грубою верхньою межею.
У цьому посібнику виконується зворотне поширення шести зрізів прикладу схеми з постійною похибкою на зріз 0.001. Це значення слід розуміти як бюджет у межах заданої p_norm.
from qiskit_addon_obp.utils.truncating import setup_budget

l1_truncation_error_budget = setup_budget(max_error_per_slice=0.001, p_norm=1)
print(l1_truncation_error_budget)
TruncationErrorBudget(per_slice_budget=[0.001], max_error_total=inf, p_norm=1)
from qiskit_addon_obp import backpropagate

max_slices = 6
l1_bp_obs, l1_remaining_slices, l1_metadata = backpropagate(
    obs,
    slices[-max_slices:],
    truncation_error_budget=l1_truncation_error_budget,
)
l1_reduced_circuit = combine_slices(
    slices[:-max_slices] + l1_remaining_slices
)
print(
    f"Backpropagated {max_slices - len(l1_remaining_slices)} circuit slices."
)
print(
    f"New observable contains {len(l1_bp_obs)} terms and {len(l1_bp_obs.group_commuting(qubit_wise=True))} commuting groups."
)
Backpropagated 6 circuit slices.
New observable contains 116 terms and 10 commuting groups.
Тепер ми можемо обчислити очікуване значення спостережуваної після зворотного поширення, а також похибку відносно точного еталона:
estimator = StatevectorEstimator()
job = estimator.run([(l1_reduced_circuit, l1_bp_obs)])
res = job.result()
l1_exp = res[0].data.evs
l1_error = exact_exp - l1_exp
print(l1_exp, l1_error)
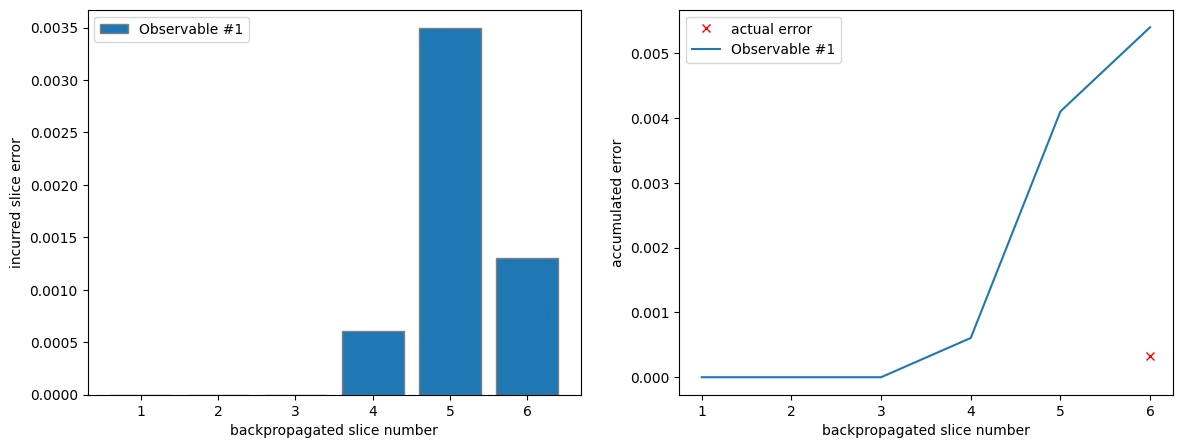
9.317869899338842 0.00032796052330397174
Нарешті, ми можемо побудувати графік похибки, внесеної під час зворотного поширення кожного зрізу, а також накопиченої похибки. Накопичена похибка є сумою похибок зрізів. Видно, що накопичена похибка є дуже грубою верхньою межею фактичної похибки.
from matplotlib import pyplot as plt
from qiskit_addon_obp.utils.visualization import (
    plot_accumulated_error,
    plot_slice_errors,
)

fig, axes = plt.subplots(1, 2, figsize=(14, 5))
axes[1].plot([6], [l1_error], "x", color="red", label="actual error")
plot_slice_errors(l1_metadata, axes[0])
plot_accumulated_error(l1_metadata, axes[1])
Використання L2-норми
Можна стверджувати, що L2-норма краще наближає внесену похибку, ніж L1-норма. Причина в тому, що ми можемо припустити, що квантовий стан взято з гаарівського випадкового ансамблю; тоді внесена похибка має розподіл із нульовим середнім і дисперсією, яку можна приблизно обмежити L2-нормою:
Хоча ця межа не є строгою, вона порушуватиметься лише в патологічних випадках.
Ми знову виконуємо зворотне поширення шести зрізів прикладу схеми з максимальною похибкою на зріз 0.001 (цього разу в сенсі L2-норми).
l2_truncation_error_budget = setup_budget(max_error_per_slice=0.001, p_norm=2)
print(l2_truncation_error_budget)
TruncationErrorBudget(per_slice_budget=[0.001], max_error_total=inf, p_norm=2)
max_slices = 6
l2_bp_obs, l2_remaining_slices, l2_metadata = backpropagate(
    obs,
    slices[-max_slices:],
    truncation_error_budget=l2_truncation_error_budget,
)
l2_reduced_circuit = combine_slices(
    slices[:-max_slices] + l2_remaining_slices
)
print(
    f"Backpropagated {max_slices - len(l2_remaining_slices)} circuit slices."
)
print(
    f"New observable contains {len(l2_bp_obs)} terms and {len(l2_bp_obs.group_commuting(qubit_wise=True))} commuting groups."
)
Backpropagated 6 circuit slices.
New observable contains 84 terms and 6 commuting groups.
Знову обчислюємо очікуване значення спостережуваної після зворотного поширення та похибку відносно точного еталона:
estimator = StatevectorEstimator()
job = estimator.run([(l2_reduced_circuit, l2_bp_obs)])
res = job.result()
l2_exp = res[0].data.evs
l2_error = exact_exp - l2_exp
print(l2_exp, l2_error)
9.317829770853422 0.00036808900872387085
Графік внесених похибок на зріз і накопиченої похибки дає схожу картину, як і раніше.
fig, axes = plt.subplots(1, 2, figsize=(14, 5))
axes[1].plot([6], [l2_error], "x", color="red", label="actual error")
plot_slice_errors(l2_metadata, axes[0])
plot_accumulated_error(l2_metadata, axes[1])
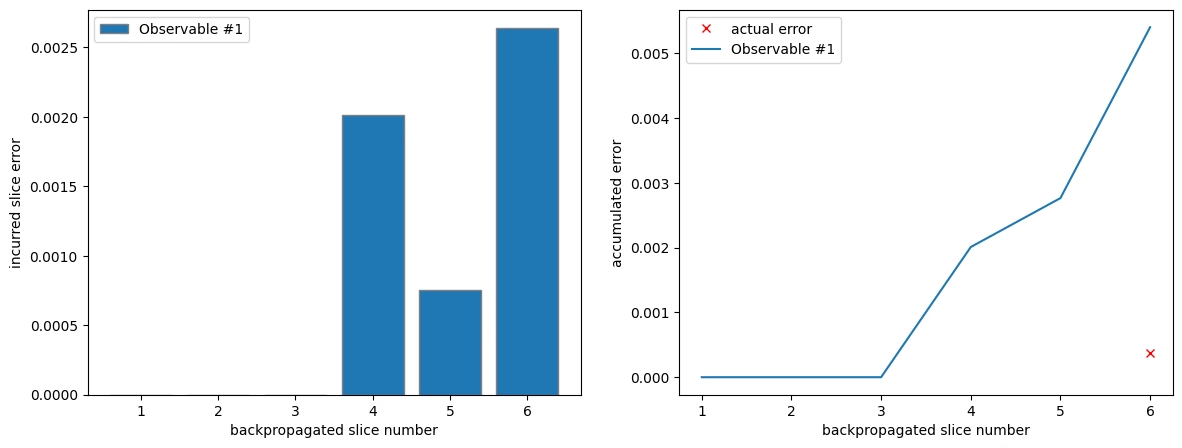
Зауваж, що накопичена похибка знову є сумою похибок окремих зрізів. Це ще одна груба межа через нерівність Мінковського, адже ми маємо обчислювати цю межу рекурсивно:
де новий індекс позначає поточну ітерацію зрізу, так що — фактична похибка на ітерації зворотного поширення , — наближена похибка усічення з ітерації , а — множина доданків Паулі, усічених на ітерації .