PEC із SLC
Імовірнісне скасування помилок (PEC) — це техніка пом'якшення квантового шуму в обчисленнях очікуваних значень observable. Вона дозволяє обчислити незміщену оцінку очікуваних значень. Ця техніка працює через виконання ансамблю шумних схем, у які введено обернену до вивченої моделі шуму. Потім модель шуму апроксимується каналом Паулі за допомогою твірлінгу Паулі (також відомого як рандомізована компіляція). Такі моделі шуму можна вивчати ефективно та пом'якшувати за допомогою PEC (докладніше див. Probabilistic error cancellation with sparse Pauli-Lindblad models on noisy quantum processors).
PEC потребує експоненційних витрат шотів для обчислення незміщеної оцінки. Shaded Lightcones (SLC) — це техніка, що використовує класичні ресурси, щоб обмежити чутливість до помилок у всій схемі. Використовуючи ці межі, користувач може контрольовано налаштовувати зміщення в оцінці observable.
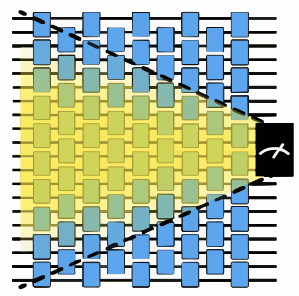
Цей посібник показує, як використовувати PEC разом із SLC, щоб пом'якшувати шум гейтів із меншими витратами шотів порівняно зі звичайним PEC.
Робочий процес такий:
- Задай circuit та observable.
- Обчисли шумні очікувані значення без пом'якшення.
- Обчисли прямі та зворотні межі зміщення.
- Вивчи шум заплутуючих шарів за допомогою qiskit-noise-learning.
- Використай вивчений шум, щоб об'єднати обчислені межі в матрицю локальних масштабів.
- Обери бажану межу зміщення на основі компромісу між витратами шотів і зміщенням.
- Підготуй програму PEC + SLC, виконай її та обміркуй результати.
- Порівняй пом'якшені очікувані значення та витрати шотів.
Задай circuit та observable
Підготуй дзеркальний circuit тротеризованої часової еволюції гамільтоніана одновимірного ланцюга Ізінга на восьми кубітах. Віддзеркали circuit, щоб скасувати його унітарність і отримати тотожний circuit, тому ідеальне очікуване значення кожної observable відоме і дорівнює 1 без потреби його обчислювати. До того ж дзеркалення подвоює глибину circuit, що своєю чергою подвоює вплив шуму.
Використай кут , щоб динаміка не була кліффордівською.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_addon_slc": "qiskit-addon-slc", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "qiskit_mitigation": "qiskit-mitigation", "qiskit_noise_learning": "qiskit-noise-learning", "samplomatic": "samplomatic"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import warnings

import numpy as np
from qiskit.circuit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_mitigation.utils import get_measurement_bases

warnings.filterwarnings("ignore")

def construct_ising_circuit(
    num_qubits: int,
    num_trotter_steps: int,
    rx_angle: float,
) -> QuantumCircuit:
    circuit = QuantumCircuit(num_qubits)

    for _ in range(num_trotter_steps):
        circuit.rx(rx_angle, range(num_qubits))
        for first_qubit in (1, 2):
            for idx in range(first_qubit, num_qubits, 2):
                # equivalent to Rzz(-pi/2):
                circuit.sdg([idx - 1, idx])
                circuit.cz(idx - 1, idx)

    return circuit

def prepare_basis(
    circuit: QuantumCircuit, basis: list[int]
) -> QuantumCircuit:
    # basis is a list of integer values from 0 to 3. These map to the basis measurement as:
    # 0 = I; 1 = Z; 2 = X; 3 = Y
    assert len(basis) == circuit.num_qubits

    out_circ = circuit.copy_empty_like()
    for qb, bas in enumerate(basis):
        if bas == 2:
            out_circ.h(qb)
        elif bas == 3:
            out_circ.rx(-np.pi / 2, qb)

    out_circ.barrier()
    out_circ.compose(circuit, inplace=True)
    return out_circ

def mirror_circuit(circuit: QuantumCircuit) -> QuantumCircuit:
    mirror_circ = circuit.copy_empty_like()
    mirror_circ.compose(circuit.inverse(), inplace=True)
    mirror_circ.barrier()
    mirror_circ.compose(circuit, inplace=True)
    mirror_circ.measure_active()
    return mirror_circ

# define observables
num_qubits = 8  # Width of the Ising chain
# The observable to measure: one X component (on qubit 2) and one Z component (on qubit 5)
target_obs_sparse = [("XZ", [2, 5], 1.0)]
observable = SparsePauliOp.from_sparse_list(
    target_obs_sparse, num_qubits=num_qubits
)

# Determine the measurement basis each qubit requires for this observable.
bases, _ = get_measurement_bases(observable)

# Instantiate the mirrored circuit and prepend the basis-preparation gates
num_trotter_steps = 6
rx_angle = np.pi / 4
circuit = construct_ising_circuit(num_qubits, num_trotter_steps, rx_angle)
mirrored_circuit = mirror_circuit(circuit)
mirrored_circuit = prepare_basis(mirrored_circuit, bases[0])
print("Visualization of 1 mirrored Trotter step")
prepare_basis(
    mirror_circuit(construct_ising_circuit(num_qubits, 1, rx_angle)), bases[0]
).draw("mpl", scale=0.6, fold=-1)
Visualization of 1 mirrored Trotter step

Обчисли шумні очікувані значення без пом'якшення
QuantumProgram містить квантовий circuit і samplex у форматі, придатному для примітива Executor. MitigationTask.prepare будує QuantumProgram зі схеми, observable та значень параметрів і розбиває circuit на бокси із заданими опціями боксингу. Встанови опцію боксингу measure_annotations у "change_basis", щоб повернути вимірювання в потрібні базиси, і додай add_tags: "unique_box", щоб симулятор міг відобразити модель шуму на бокси схеми. Програма за замовчуванням твірлиться за Паулі, що на реальному обладнанні перетворює когерентний шум на шум Паулі, який припускають методи пом'якшення. num_randomizations задає, скільки твірльованих екземплярів кожного circuit семплується, а shots_per_randomization задає, скільки шотів отримує кожен екземпляр, тож їхній добуток — це ліміт шотів на circuit.
Якщо ти маєш доступ до QPU, можеш виконати програму за допомогою Executor, створеного з бекенда QiskitRuntimeService. Цей приклад використовує AerSimulator для локального виконання програми. Його опція симулятора layer_noise_model додає шум із заданої моделі шуму Паулі-Ліндбладу на кожен шар заплутуючих гейтів. Тут ми генеруємо випадкову модель шуму Паулі-Ліндбладу з помилкою на шаровий гейт (EPLG) 0.01, майже на порядок вищою за типові сучасні QPU Heron, щоб посилити ефект використання SLC також на задачі малого масштабу.
from qiskit.circuit import CircuitInstruction
from qiskit.quantum_info import PauliLindbladMap, pauli_basis
from qiskit_aer import AerSimulator
from qiskit_ibm_runtime import Executor
from qiskit_mitigation import MitigationTask, find_combined_unique_layers
from samplomatic import Tag
from samplomatic.utils import get_annotation

def generate_random_pauli_lindblad_noise(
    layers,
    num_qubits: int,
    eplg: float = 3e-3,
    seed: int | None = None,
) -> list[tuple[CircuitInstruction, PauliLindbladMap]]:
    """Generate random Pauli-Lindblad noise over the full Pauli basis."""
    layer_noise_model = []
    for layer in layers:
        layer_instructions = layer.operation.params[0]
        contain_measurement = any(
            inst.name.startswith("measure") for inst in layer_instructions
        )
        if contain_measurement:  # do not add measurement noise
            layer_noise = PauliLindbladMap.identity(num_qubits)
        else:
            edges = [
                (inst.qubits[0]._index, inst.qubits[1]._index)
                for inst in layer_instructions
            ]  # extract the edges of the layer

            basis_paulis = [p for p in pauli_basis(2) if np.sum(p.x + p.z)]
            rng = np.random.default_rng(seed=seed)
            num_generators = len(basis_paulis)
            rates = rng.random(len(basis_paulis)) * eplg / num_generators

            layer_noise = PauliLindbladMap.from_sparse_list(
                [
                    (pauli.to_label(), edge, rate)
                    for pauli, rate in zip(basis_paulis, rates, strict=True)
                    for edge in edges
                ],
                num_qubits=num_qubits,
            )
        layer_noise_model.append((layer, layer_noise))
    return layer_noise_model

num_randomizations = 400
shots_per_randomization = 16

boxing_options = {"add_tags": "unique_box"}

# find the unique layers to generate the layered noise for
box_layers = find_combined_unique_layers(
    [mirrored_circuit], custom_boxing_options=boxing_options
)
layer_noise_model = generate_random_pauli_lindblad_noise(
    box_layers, num_qubits, eplg=1e-2, seed=42
)

# a local noisy simulator in place of a QPU backend
noisy_executor = Executor(
    AerSimulator(),
    options={"simulator": {"layer_noise_model": layer_noise_model}},
)

task = MitigationTask()
program = task.prepare(
    circuit=mirrored_circuit,
    observables=observable,
    parameters=None,
    num_randomizations=num_randomizations,
    shots_per_randomization=shots_per_randomization,
    custom_boxing_options=boxing_options,
)

program._semantic_role = "simulation"  # flag the program for the simulator
job_unmit_res = noisy_executor.run(program).result()
unmitigated_res = task.postprocess(job_unmit_res)

print(f"unmitigated result: {unmitigated_res.data.evs[0]}")
unmitigated result: 0.63125
Обчисли прямі та зворотні межі зміщення
Перш ніж витрачати будь-який час QPU на вивчення шуму, SLC використовує класичне моделювання, щоб обмежити внесок кожної потенційної помилки в зміщення observable. Це робиться у двох взаємодоповнювальних проходах:
-
Пряме поширення: кожна помилка Паулі поширюється вперед крізь решту circuit, і обчислюється її комутатор з observable. Лише помилка, що антикомутує з observable, може зміщувати результат, тому цей прохід дає верхню межу прямого впливу кожної помилки.
-
Зворотне поширення: кожна помилка поширюється назад до початку circuit, і обчислюється її комутатор з початковим станом. Оскільки circuit починається зі стану з усіма нулями, помилки, що комутують із ним, не можуть вплинути на результат, що звужує межу з іншого боку.
Дві межі разом утворюють щільну вилку навколо внеску кожної помилки в зміщення у найгіршому випадку. На наступному кроці ці межі об'єднуються з вивченими швидкостями шуму, щоб ранжувати, які помилки варто виправляти, а які можна безпечно залишити. Опція боксингу inject_noise_strategy="individual_modification" потрібна тут, щоб кожна анотація InjectNoise у розбитому на бокси circuit мала унікальну ідентичність, до якої можна прикріпити межі SLC.
Для задач більшого масштабу ці обчислення можуть вимагати значних класичних обчислювальних ресурсів.
from qiskit_addon_slc.bounds import (
    compute_backward_bounds,
    compute_forward_bounds,
    tighten_with_speed_limit,
)
from qiskit_mitigation import PEC

slc_boxing_options = {
    "add_tags": "unique_box",
    "inject_noise_strategy": "individual_modification",
}

slc_pec_task = PEC()

boxed_circuit, noise_model_paulis = (
    slc_pec_task.generate_slc_bounds_computation_input(
        mirrored_circuit, custom_boxing_options=slc_boxing_options
    )
)

forward_bounds = compute_forward_bounds(
    boxed_circuit, noise_model_paulis, observable
)
tighten_forward_bounds = tighten_with_speed_limit(
    forward_bounds, boxed_circuit, noise_model_paulis, observable
)
backward_bounds = compute_backward_bounds(boxed_circuit, noise_model_paulis)
Вивчи шум заплутуючих шарів
Щоб обчислити остаточну оцінку того, наскільки кожна помилка впливає на зміщення очікуваного значення, а також наскільки дорого її виправити, ми вивчаємо швидкості шуму та застосовуємо їх до передбачених меж шуму, обчислених раніше.
PEC (як і PEC+SLC) припускає твірльовану модель шуму кожного шару заплутуючих гейтів у circuit. Якщо припустити марковську модель шуму, вважається, що глибина circuit не впливає на канал шуму заданого заплутуючого шару. Тому слід вивчати лише модель шуму кожного унікального шару заплутуючих гейтів. Circuit, використаний у цьому посібнику, можна розбити на два унікальні шари. Проєктування схем із мінімальним набором унікальних заплутуючих шарів важливе, якщо ти хочеш вивчити модель шуму, оскільки унікальні шари треба вивчати незалежно. Якщо у твоєму circuit забагато унікальних шарів, вивчення шуму може стати нездійсненним через вартість семплування для вивчення багатьох шарів.
qiskit-noise-learning використовується для вивчення шуму. Вивчальник повторює кожен шар fragment_depths разів у своїх навчальних схемах, твірлить кожну схему num_randomizations разів і підганяє спад виміряних точностей до моделі Паулі-Ліндбладу. Ці параметри можуть впливати на точність вивченої моделі. Що точніше вивчена модель шуму, то точнішим буде скасування шуму.
Наведений нижче код малює вивчену модель шуму, де два шари об'єднано в одну карту. Кожен кубіт зображено як діаграму-круг із його ваговими-1 швидкостями X, Y і Z, підсумованими за двома шарами, а кожне ребро показує вивчені вагові-2 швидкості. Наприклад, швидкість 3e-4 означає, що помилка виникає приблизно три рази на кожні 10 000 використань шару.
from qiskit.providers.fake_provider import GenericBackendV2
from qiskit.quantum_info import PauliList
from qiskit_ibm_runtime.results import LayerError, PauliLindbladError
from qiskit_ibm_runtime.visualization.embeddings import Embedding
from qiskit_noise_learning.aer_executor import AerExecutor
from qiskit_noise_learning.noise_learner import LearningOptions, NoiseLearner
from samplomatic import InjectNoise

line_coupling = [(i, i + 1) for i in range(num_qubits - 1)]
backend = GenericBackendV2(
    num_qubits=num_qubits,
    basis_gates=["id", "rz", "sx", "x", "cz"],
    coupling_map=line_coupling,
)

# first learn only the layers PEC will inject noise into, i.e. not the measurement layer
pec_layers = [
    layer
    for layer in slc_pec_task.find_unique_layers(
        mirrored_circuit, slc_boxing_options
    )
    if get_annotation(layer.operation, InjectNoise)
]
layers = slc_pec_task.find_unique_layers(mirrored_circuit, slc_boxing_options)

learning_options = LearningOptions(
    fragment_depths=[2, 4, 8, 16],
    num_randomizations=250,
    shots_per_randomizations=16,
)

# qiskit-noise-learning is not compatible with the Executor in local mode,
# and requires the simulator present in the package for running simulation
noise_dict = {
    get_annotation(layer.operation, Tag).ref: noise_layer
    for layer, noise_layer in layer_noise_model
}
noise_learner_simulator = AerExecutor(
    qasm_simulator=AerSimulator(), noise_dict=noise_dict
)
learner = NoiseLearner(
    backend, options=learning_options, executor=noise_learner_simulator
)
learned_noise = (
    learner.run(pec_layers).result().to_dict()
)  # keyed by InjectNoise reference

# Draw the learned model on the line, laid out as a line with the qubits in order.
# Composing the two layers' maps sums their rates, giving one map over all the edges.
embedding = Embedding(
    [(0, 0), (0, 2), (0, 4), (2, 4), (4, 4), (4, 2), (4, 0), (2, 0)],
    line_coupling,
)
first, second = learned_noise.values()
learned_model = first.compose(second).simplify()
error = PauliLindbladError(
    PauliList(
        learned_model.get_qubit_sparse_pauli_list_copy().to_pauli_list()
    ),
    learned_model.rates,
)
fig = LayerError(circuit, list(range(num_qubits)), error).draw_map(
    embedding, radius=0.4, height=460, width=620
)
fig.update_traces(
    marker={
        "cmin": 0,
        "cmax": max(learned_model.rates),
        "colorbar": {"tickformat": ".1e", "title": "rate"},
    },
    selector={"mode": "markers"},
)
fig.show()

Використай вивчений шум, щоб об'єднати обчислені межі в матрицю локальних масштабів
Маючи і класичні межі (з попереднього кроку), і вивчені швидкості шуму, ми тепер можемо обчислити матрицю локальних масштабів — вагу для кожної помилки, що визначає, наскільки агресивно PEC має скасовувати кожен окремий член шуму.
Ключова ідея SLC в тому, що не всі помилки треба скасовувати повністю. Помилка, чиї прямі та зворотні межі обидві малі, має незначний вплив на observable незалежно від своєї швидкості, тож її можна залишити частково або повністю непом'якшеною. merge_bounds об'єднує класичні межі з вивченими швидкостями Паулі-Ліндбладу, а потім compute_local_scales призначає кожній помилці масштаб між 0 (повністю ігнорується) і 1 (повністю скасовується) з урахуванням заданого користувачем bias_tolerance. Помилки з великим оціненим внеском у зміщення отримують масштаб, близький до 1 (повна обробка PEC), а помилки з малим внеском отримують нижчий масштаб, що зменшує витрати семплування, які вони несуть.
SLC надає неперервний регулятор між двома крайнощами — звичайним PEC (нульове зміщення, найвищі витрати) і відсутністю пом'якшення взагалі (нульові витрати, повне зміщення від шуму). Параметр bias_tolerance керує цим регулятором: встановлення його в 0 відновлює повний PEC, тоді як більші значення допускають більше залишкового зміщення в обмін на нижчі витрати семплування γ².
Цей крок перебирає bias_tolerance у діапазоні значень і обчислює відповідні витрати семплування для кожного. Побудова цих точок порівняно з витратами повного PEC допомагає обрати робочу точку, що відповідає твоєму бюджету шотів. Наприклад, допуск залишкового зміщення 5 % може зменшити витрати семплування на порядок порівняно з повним PEC, роблячи обчислення можливим на сучасних QPU, де інакше воно було б неможливим.
import matplotlib.pyplot as plt
from qiskit_addon_slc.bounds import compute_local_scales, merge_bounds

merged_bounds = merge_bounds(
    boxed_circuit,
    tighten_forward_bounds,
    backward_bounds,
    noise_rates=learned_noise,
)

biases = []
costs = []
for bias in [0.0, *np.arange(0.01, 0.11, 0.01).tolist()]:
    _, cost_, bias_ = compute_local_scales(
        boxed_circuit,
        merged_bounds,
        noise_rates=learned_noise,
        bias_tolerance=bias,
    )
    biases.append(bias_)
    costs.append(cost_)

# Compute tha full PEC overhead and compare it with the overhead and bias of different SLC configurations
vanilla_gamma = slc_pec_task.calculate_gamma(
    slc_pec_task.boxed_circuit, learned_noise, 1
)

xticks = np.arange(0, 11, 2)

fig, ax = plt.subplots()
ax.scatter(
    [0], [vanilla_gamma**2], marker="D", c="tab:orange", label="full PEC"
)
ax.plot(
    100 * np.array(biases),
    np.array(costs),
    "o-",
    c="tab:blue",
    label="PEC+SLC",
)
ax.set_xticks(xticks, [f"{x:.2f}" for x in xticks])

ax.set_xlabel("Remaining bias [%]")
ax.set_ylabel(r"Sampling overhead, $\gamma^2$")
ax.grid()
ax.legend()
fig.suptitle("PEC sampling overhead reduction due to SLC")
Optimal spacetime partitioning not implemented! Just partitioning list of noisy boxes.
Text(0.5, 0.98, 'PEC sampling overhead reduction due to SLC')

Обери бажану межу зміщення на основі компромісу між витратами шотів і зміщенням
У цьому посібнику ми обираємо допуск зміщення 5%. Зауваж, що цей розрахунок зміщення ґрунтується на вивченій моделі шуму, яка може бути не ідеально узгодженою з реальним шумом пристрою.
chosen_bias_threshold = 0.05
local_scales, sampling_cost, bias = compute_local_scales(
    boxed_circuit, merged_bounds, learned_noise, bias_tolerance=bias
)
slc_pec_task.set_slc_local_scales(
    local_scales, float(np.sqrt(sampling_cost)), bias
)
Підготуй програму PEC + SLC, виконай її та обміркуй результати
Обравши локальні масштаби, ми можемо побудувати повну програму виконання PEC+SLC. Виклик PEC.prepare будує QuantumProgram, що кодує стратегію введення антишуму в анотації боксів circuit. Передача noise_gain="slc_local_scales" наказує executor використовувати ваги окремих помилок, задані set_slc_local_scales, замість застосування того самого повного оберненого підсилення шуму до кожної помилки, як це робив би звичайний PEC.
Для чесного порівняння готується друге завдання PEC з noise_gain=0, що відповідає повному скасуванню PEC без допуску зміщення SLC. Обидві програми додаються до одного QuantumProgram, тож вони спільно використовують одне завдання виконання — їхні схеми чергуються та виконуються разом, тобто будь-який дрейф обладнання однаково впливає на обидві.
Після завершення завдання postprocess перетворює сирі бітові рядки вимірювань на очікувані значення, застосовуючи відповідний коефіцієнт перемасштабування PEC γ для кожного завдання.
program_pec = slc_pec_task.prepare(
    circuit=mirrored_circuit,
    observables=[observable],
    parameters=None,
    num_randomizations=num_randomizations,
    shots_per_randomization=shots_per_randomization,
    custom_boxing_options=slc_boxing_options,
    noise_maps=learned_noise,  # PEC option
    noise_gain="slc_local_scales",  # PEC option. Defines the usage of SLC
    max_sampling_overhead=100,  # PEC option
)

full_pec_task = PEC()
program_pec = full_pec_task.prepare(
    circuit=mirrored_circuit,
    observables=[observable],
    parameters=None,
    num_randomizations=num_randomizations,
    shots_per_randomization=shots_per_randomization,
    custom_boxing_options=boxing_options,
    quantum_program=program_pec,
    noise_maps=learned_noise,  # PEC option
    noise_gain=0,  # PEC option
    max_sampling_overhead=100,  # PEC option
)

# Execute
program_pec._semantic_role = (
    "simulation"  # flag the program for the simulator
)
job_pec_results = noisy_executor.run(program_pec).result()

# post-processing
pec_slc_res = slc_pec_task.postprocess(job_pec_results)
full_pec_res = full_pec_task.postprocess(job_pec_results)
Порівняй пом'якшені очікувані значення та витрати шотів
Ідеальне очікуване значення дзеркального circuit за побудовою дорівнює 1, тому зміщення будь-якої оцінки — це просто |1 - result|. Ця фінальна комірка виводить зміщення та загальну кількість шотів для трьох сценаріїв поруч:
-
Без пом'якшення: сире шумне очікуване значення без застосування скасування помилок.
-
Повний PEC: беззміщене скасування помилок із використанням повної оберненої моделі шуму на кожному шарі, із повними витратами семплування γ².
-
PEC+SLC: скасування помилок, кероване локальними масштабами shaded-lightcone, що допускає обраний
bias_toleranceв обмін на значно меншу кількість шотів.
Порівняння трьох рядків показує конкретну користь SLC: пом'якшене зміщення PEC+SLC залишається значно нижчим за зміщення без пом'якшення, тоді як загальна кількість шотів значно менша, ніж потребував повний PEC.
print(
    f"Unmitigated result bias: {np.abs(1 - unmitigated_res.data.evs[0]) * 100:.2f}%, \
total shots ran: {job_unmit_res[0]['_meas'].shape[0] * job_unmit_res[0]['_meas'].shape[2]}"
)

print(
    f"Full PEC final result bias: {np.abs(1 - full_pec_res.data.evs[0]) * 100:.2f}%, \
total shots ran: {job_pec_results[1]['_meas'].shape[0] * job_pec_results[1]['_meas'].shape[2]}"
)

print(
    f"PEC+SLC final result bias: {np.abs(1 - pec_slc_res.data.evs[0]) * 100:.2f}%, \
total shots ran: {job_pec_results[0]['_meas'].shape[0] * job_pec_results[0]['_meas'].shape[2]}"
)
Unmitigated result bias: 36.88%, total shots ran: 6400
Full PEC final result bias: 0.97%, total shots ran: 48528
PEC+SLC final result bias: 1.46%, total shots ran: 24480