Постселекція з перевірками немарковських помилок
Цей посібник пояснює, що таке перевірки немарковських помилок і як реалізувати їх програмно за допомогою qiskit-mitigation. Ти почнеш із невеликого двокубітного прикладу, щоб візуалізувати перевірки та обговорити, як вони працюють. Після того як у тебе складеться інтуїція, ти спробуєш 20-кубітний приклад, де реалізуєш перевірки та порівняєш різні стратегії постселекції.
Що таке перевірки немарковських помилок?
Перевірки немарковських помилок — це тести на основі вимірювань, що перевіряють, чи стан кубіта ймовірно зіпсований немарковським джерелом помилок. Цей тест виконується розміщенням на кожному кубіті на початку circuit гейта інверсії біта з подовженою тривалістю (xslow або серії з гейтів rx з кутом ), за яким іде звичайний XGate, і вимірюванням, щоб переконатися, що стан успішно перевернувся . Цей тест також можна виконати наприкінці circuit після кожного кінцевого вимірювання, щоб переконатися, що пристрій може успішно перевернути виміряний стан кубіта з . Семпли, пов'язані з невдалими перевірками, можна вважати ненадійними, а постселекція лише семплів, які проходять усі перевірки, може підвищити точність шумного розподілу.
Стратегії постселекції на основі перевірок немарковських помилок
-
Вузлова постселекція: залишай лише семпли, для яких кожен кубіт пройшов свою перевірку (перевірки). Це найсуворіша стратегія, яка загалом призводить до відкидання більшої кількості семплів.
-
Реброва постселекція: для кожного ребра в графі зв'язності кубітів переконайся, що принаймні один кубіт проходить перевірку (перевірки). Ця стратегія м'якша; якщо кубіт не проходить перевірку, семпл усе одно може бути збережений, якщо всі його сусіди проходять свої перевірки.
Кубіти-спостерігачі
Можна задати «кубіти-спостерігачі» — допоміжні кубіти, суміжні з кубітами, що використовуються для виконання початкового circuit. Перевірки немарковських помилок можна розміщувати на цих спостерігачах, забезпечуючи більше покриття проти немарковського шуму, який ці перевірки призначені виявляти.
Частина 1. Візуалізація перевірок немарковських помилок
Перш ніж демонструвати техніку на QPU, ти створиш невеликий двокубітний circuit і додаси перевірки, щоб візуалізувати, як вона працює. Почни зі стану Белла, транспільованого на бекенд QPU ibm_kingston.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "qiskit_mitigation": "qiskit-mitigation", "samplomatic": "samplomatic"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
from qiskit.transpiler import generate_preset_pass_manager
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService(channel="ibm_quantum_platform")
backend = service.backend("ibm_kingston")

qc = QuantumCircuit(2)
qc.h(0)
qc.cx(0, 1)
qc.measure_all()
qc_isa = generate_preset_pass_manager(
    optimization_level=0, backend=backend
).run(qc)
qc_isa.draw("mpl")

Додай кілька перевірок немарковських помилок на початок circuit. Перевірки розміщуватимуться лише на кубітах, які завершуються вимірюванням. Ці перевірки гарантують, що пристрій може успішно перевернути початковий стан кубіта , а вимірювання цих перевірок зчитуються в новий класичний регістр під назвою meas_pre.
from qiskit.transpiler import PassManager
from qiskit_mitigation.postselection.passes import (
    AddPreCircuitNonMarkovianErrorChecks,
)

qc_w_checks = PassManager([AddPreCircuitNonMarkovianErrorChecks()]).run(
    qc_isa
)
qc_w_checks.draw("mpl", idle_wires=False)

Так само ти можеш додати перевірки наприкінці circuit після кожного кінцевого вимірювання. Ці перевірки гарантують, що пристрій може перевернути стан кубіта з , а їхні вимірювання зчитуються в новий класичний регістр під назвою meas_ps.
from qiskit_mitigation.postselection.passes import (
    AddPostCircuitNonMarkovianErrorChecks,
)

qc_w_checks = PassManager([AddPostCircuitNonMarkovianErrorChecks()]).run(
    qc_w_checks
)
qc_w_checks.draw("mpl", idle_wires=False)

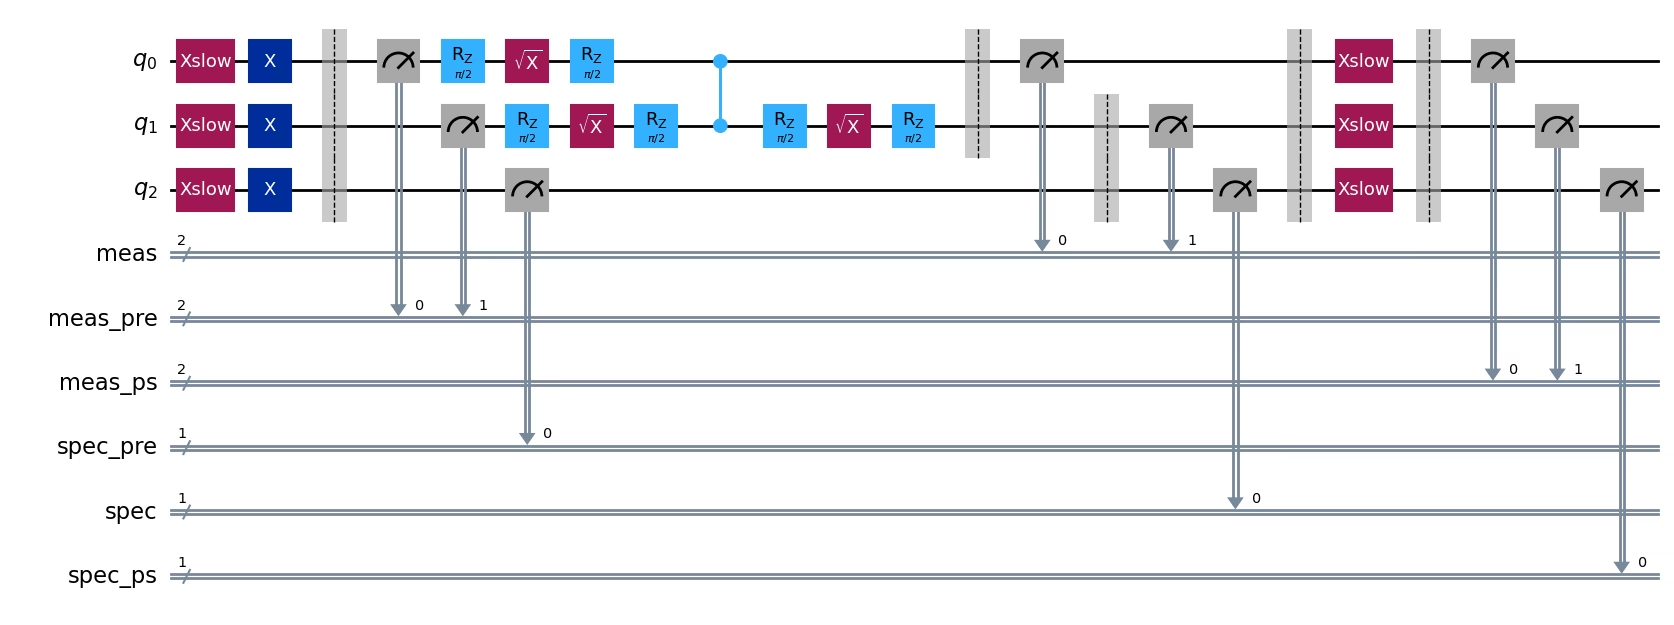
Як згадувалося у вступі, ти можеш використовувати допоміжні кубіти (ancilla), суміжні з кубітами даних, як «спостерігачів» (spectators), щоб забезпечити ширше покриття помилок. Додай перевірки спостерігачів до та після схеми. Ти можеш побачити, що оскільки фізичний кубіт 2 на ibm_kingston суміжний із кубітом даних 1, його було додано як спостерігача, і для нього додано перевірки до та після схеми. Вимірювання спостерігачів додано до нових класичних регістрів під назвами spec_pre і spec.
Така схема містить усі можливі перевірки немарковських помилок, тому вибірка з цієї схеми дає користувачам змогу виконувати постселекцію на основі будь-якої комбінації перевірок [до/після] схеми та стратегії постселекції на основі [вузлів/ребер]. Див. Частину 2 цього посібника, щоб побачити, як це працює на квантовому обладнанні.
from qiskit_mitigation.postselection.passes import (
    AddSpectatorPostCircuitNonMarkovianErrorChecks,
    AddSpectatorPreCircuitNonMarkovianErrorChecks,
)

qc_w_checks = PassManager(
    [
        AddSpectatorPreCircuitNonMarkovianErrorChecks(
            coupling_map=backend.coupling_map
        ),
        AddSpectatorPostCircuitNonMarkovianErrorChecks(
            coupling_map=backend.coupling_map
        ),
    ]
).run(qc_w_checks)
qc_w_checks.draw("mpl", idle_wires=False, fold=-1)
Частина 2: Демонстрація перевірок немарковських помилок на QPU та порівняння стратегій постселекції
Тепер, коли ти розумієш, що таке перевірки немарковських помилок і як вони реалізовані програмно, можна запустити більший приклад на QPU і побачити, як це працює. Спочатку підготуй схему. Вибір схеми не дуже важливий; потрібна лише схема, для якої можна легко перевірити результат. Тут ми обираємо 20-кубітну одновимірну дзеркальну схему Ізінга. Таку схему нетривіально виконувати на обладнанні, і вона має зазнавати впливу немарковських помилок, що дає змогу продемонструвати ефективність перевірок немарковських помилок. Крім того, дзеркальна структура дозволяє тривіально порівняти обчислення зашумлених очікуваних значень із точними значеннями.
У цьому експерименті ми обчислюємо очікувані значення спостережуваної. Вибір спостережуваної також не важливий, тому ми просто обираємо середню намагніченість на один вузол .
import numpy as np
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import CouplingMap

num_qubits = 20
initial_layout = initial_layout = [
    124,
    125,
    126,
    127,
    128,
    129,
    130,
    131,
    132,
    133,
    134,
    135,
    139,
    155,
    154,
    153,
    152,
    151,
    150,
    149,
][:num_qubits]
coupling_map = CouplingMap.from_line(num_qubits, bidirectional=False)

# Num Trotter steps and `rx` angle
num_steps = 6
theta_rx = np.pi / 6

# Average single-site magnetization
observable = (
    SparsePauliOp(
        [
            "I" * iq + "Z" + "I" * (num_qubits - iq - 1)
            for iq in range(num_qubits)
        ]
    )
    / num_qubits
)

# Create the Trotter circuit
circuit = QuantumCircuit(num_qubits)
edges = CouplingMap.from_line(num_qubits, bidirectional=False).get_edges()
edges_a = [e for e in edges if e[0] % 2 == 0]
edges_b = [e for e in edges if e[0] % 2 == 1]
for _ in range(num_steps):
    circuit.rx(theta_rx, [i for i in range(num_qubits)])
    for edge in edges_a:
        circuit.cz(edge[0], edge[1])
    for edge in edges_b:
        circuit.cz(edge[0], edge[1])
circuit = circuit.compose(circuit.inverse())
circuit.measure_all()

# Transpile circuit to backend
pm = generate_preset_pass_manager(
    optimization_level=0, backend=backend, initial_layout=initial_layout
)
isa_circuit = pm.run(circuit)
print(
    f"two-qubit depth: {isa_circuit.depth(lambda instr: instr.operation.num_qubits == 2)}"
)
print(f"total depth:     {isa_circuit.depth()}")
isa_circuit.draw("mpl", fold=-1, idle_wires=False)
two-qubit depth: 24
total depth:     85
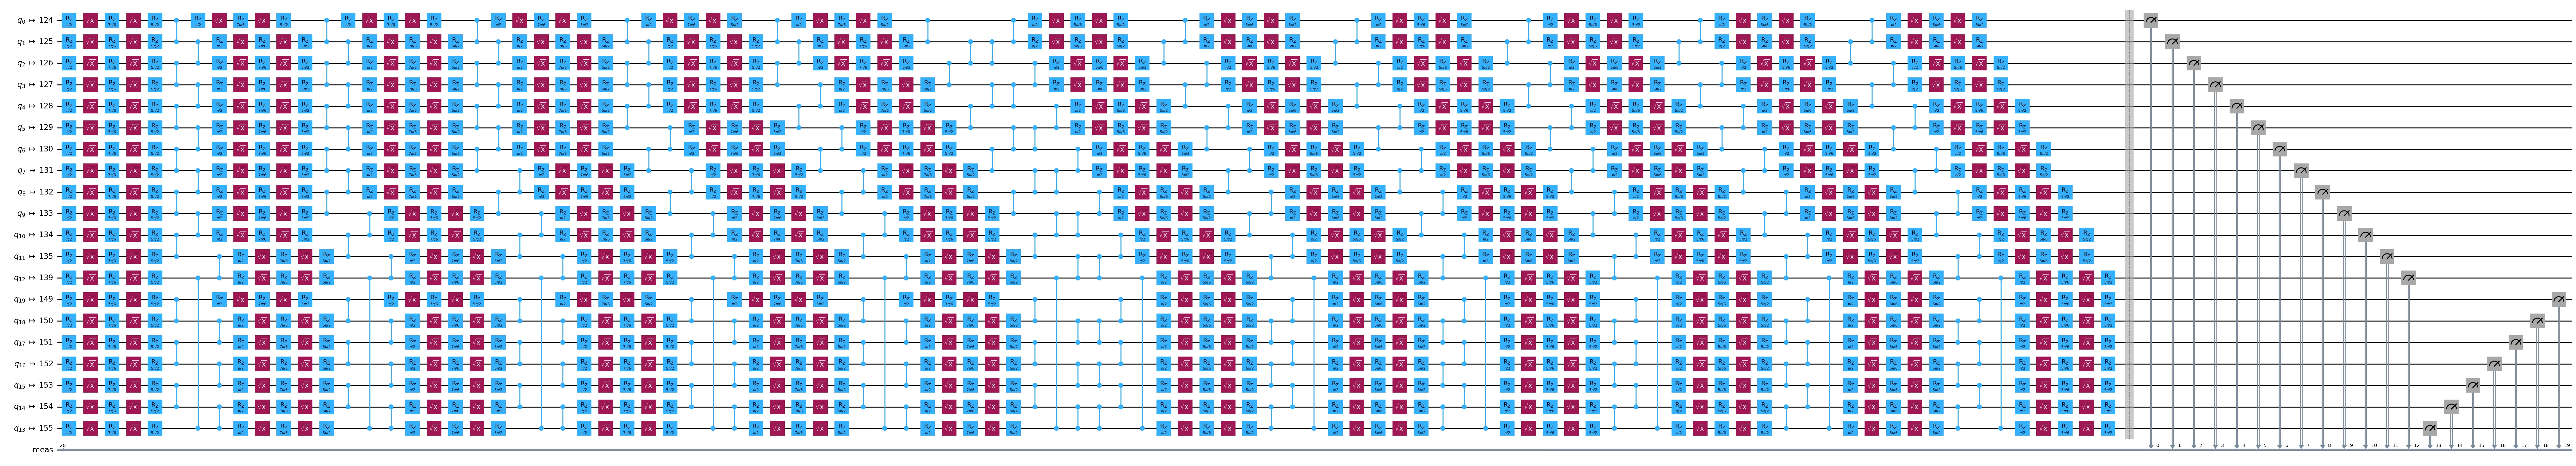
Тепер ми додаємо перевірки до та після схеми на кожному кубіті, включно із сімома суміжними кубітами-спостерігачами. Коли ти додаєш до схеми всі можливі перевірки, ти можеш вирішити, яку стратегію постселекції використовувати під час постобробки.
# Use all non-Markovian error checks so we can compare all strategies in post-processing.
combined = PassManager(
    [
        AddPreCircuitNonMarkovianErrorChecks(x_pulse_type="rx"),
        AddSpectatorPreCircuitNonMarkovianErrorChecks(
            backend.coupling_map, x_pulse_type="rx"
        ),
        AddPostCircuitNonMarkovianErrorChecks(x_pulse_type="rx"),
        AddSpectatorPostCircuitNonMarkovianErrorChecks(
            backend.coupling_map, x_pulse_type="rx"
        ),
    ]
).run(isa_circuit)
combined_isa = generate_preset_pass_manager(
    optimization_level=0, backend=backend
).run(combined)

print("cregs:", [(c.name, c.size) for c in combined_isa.cregs])
cregs: [('meas', 20), ('meas_pre', 20), ('spec_pre', 7), ('meas_ps', 20), ('spec', 7), ('spec_ps', 7)]
Використай примітив Executor, щоб отримати вибірку зі схеми, що містить перевірки.
from qiskit_ibm_runtime import Executor
from samplomatic.quantum_program import QuantumProgram

# Raw and combined-checks circuits in a single 100k-shot program so they share calibration.
program = QuantumProgram(shots=100_000)
program.append_circuit_item(isa_circuit)  # raw circuit, no checks
program.append_circuit_item(
    combined_isa
)  # combined pre + post non-Markovian error checks
job = Executor(backend).run(program)
print(f"job id: {job.job_id()}")
print(f"status: {job.status()}")
job id: d9badrm6hjac73ffe31g
status: QUEUED
Клас PostSelector знає про структуру creg перевірок, тому він може зіставити кожен біт у вибірках із пов’язаним вимірюванням схеми. Його метод compute_mask можна використати, щоб створити маску над послідовністю вибірок за заданою стратегією постселекції (вузли чи ребра) і типом перевірок немарковських помилок (до чи після схеми). Щоб поєднати стратегії до та після схеми в одну маску, їхні маски можна обчислити незалежно, а потім об’єднати операцією AND. Тут ми використовуємо PostSelector, щоб створити маски для всіх різноманітних стратегій, і розглядаємо результати для кожної доступної перестановки стратегій.
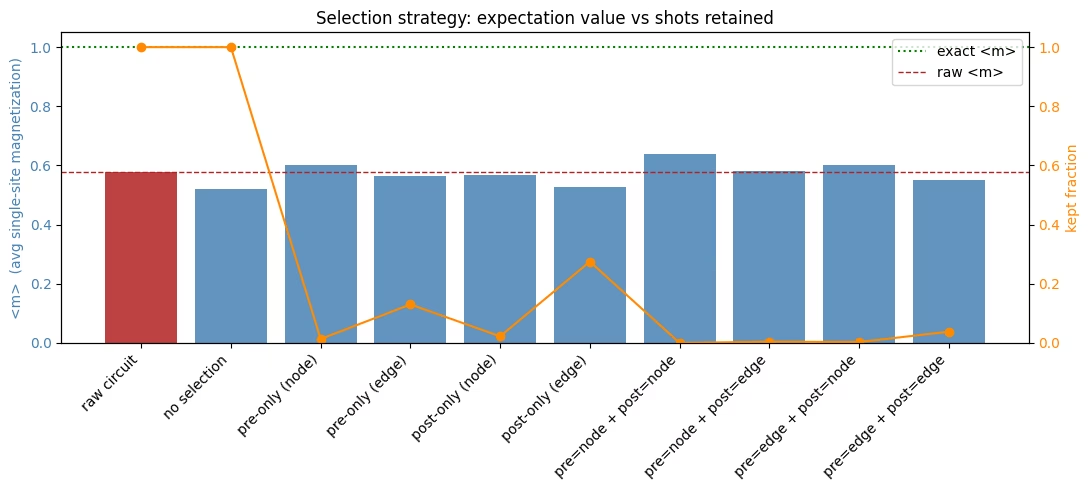
На візуалізації нижче видно, як стратегія постселекції впливає на частку відібраних вибірок, а також на якість відповіді. Як і очікувалося, стратегії з постселекцією на основі вузлів дали найнижчу частку відбору. Стратегії на основі ребер м’якші й зазвичай дають вищу частку відбору. Користувачам слід поекспериментувати з різними стратегіями на своїй задачі, щоб визначити правильний баланс між часткою відбору та якістю вибіркового розподілу. У цьому прикладі використання постселекції на основі вузлів із перевірками до та після схеми дало найкращу відповідь із часткою відбору .028%. Деякі стратегії не перевершили необроблену схему. Також видно, що додавання перевірок без використання жодної з них (стовпчик «no selection» на діаграмі нижче) працює найгірше.
import matplotlib.pyplot as plt
from qiskit_mitigation.postselection import PostSelector

selector = PostSelector.from_circuit(combined_isa, backend.coupling_map)

exec_results = job.result()
# The Executor returns numpy arrays keyed by classical-register name, so each result item is
# already the {creg_name: ndarray} mapping that compute_mask expects.
raw_bits = exec_results[0]["meas"]  # raw circuit, no checks
bits = exec_results[1]  # combined pre+post circuit

meas_bits = bits["meas"]
total = meas_bits[..., 0].size

def magnetization(b, mask=None):
    """Average single-site magnetization over the (optionally masked) measurement bits."""
    kept = b if mask is None else b[mask]
    return (1 - 2 * kept.astype(int)).mean()  # bit 0 -> +1, bit 1 -> -1

rows = []

def report(label, mask=None, b=meas_bits):
    """Record and print the magnetization and kept fraction for one selection strategy."""
    kept = b[..., 0].size if mask is None else int(mask.sum())
    ev = magnetization(b, mask)
    rows.append((label, ev, kept / total))
    print(f"{label:<24}: <m> = {ev:+.4f}   (kept {kept:>6}/{total})")

# Compare all possible postselection strategies
report("raw circuit", b=raw_bits)
report("no selection")
for s in ("node", "edge"):
    report(f"pre-only ({s})", selector.compute_mask(bits, s, mode="pre"))
for s in ("node", "edge"):
    report(f"post-only ({s})", selector.compute_mask(bits, s, mode="post"))
for pre_s in ("node", "edge"):
    for post_s in ("node", "edge"):
        keep = selector.compute_mask(
            bits, pre_s, mode="pre"
        ) & selector.compute_mask(bits, post_s, mode="post")
        report(f"pre={pre_s} + post={post_s}", keep)

labels = [r[0] for r in rows]
evs = [r[1] for r in rows]
fracs = [r[2] for r in rows]
x = range(len(labels))

fig, ax1 = plt.subplots(figsize=(11, 5))

# Bars: expectation value per selection strategy.
bar_colors = ["firebrick"] + ["steelblue"] * (len(evs) - 1)
ax1.bar(x, evs, color=bar_colors, alpha=0.85)
ax1.axhline(1.0, color="green", ls=":", lw=1.5, label="exact <m>")
ax1.axhline(rows[0][1], color="firebrick", ls="--", lw=1, label="raw <m>")
ax1.set_ylabel("<m>  (avg single-site magnetization)", color="steelblue")
ax1.tick_params(axis="y", labelcolor="steelblue")
ax1.set_xticks(list(x))
ax1.set_xticklabels(labels, rotation=45, ha="right")
ax1.legend(loc="upper right")

# Line: fraction of shots retained (right axis).
ax2 = ax1.twinx()
ax2.plot(x, fracs, "o-", color="darkorange")
ax2.set_ylabel("kept fraction", color="darkorange")
ax2.tick_params(axis="y", labelcolor="darkorange")
ax2.set_ylim(0, 1.05)

ax1.set_title("Selection strategy: expectation value vs shots retained")
fig.tight_layout()
plt.show()
raw circuit             : <m> = +0.5791   (kept 100000/100000)
no selection            : <m> = +0.5211   (kept 100000/100000)
pre-only (node)         : <m> = +0.6026   (kept   1357/100000)
pre-only (edge)         : <m> = +0.5637   (kept  13029/100000)
post-only (node)        : <m> = +0.5682   (kept   2254/100000)
post-only (edge)        : <m> = +0.5265   (kept  27514/100000)
pre=node + post=node    : <m> = +0.6393   (kept     28/100000)
pre=node + post=edge    : <m> = +0.5799   (kept    442/100000)
pre=edge + post=node    : <m> = +0.6006   (kept    317/100000)
pre=edge + post=edge    : <m> = +0.5521   (kept   3836/100000)