Техніки пом'якшення та придушення помилок
Бета-версія нової моделі виконання вже доступна. Спрямована модель виконання забезпечує більшу гнучкість при налаштуванні робочого процесу пом'якшення помилок. Дивись посібник Спрямована модель виконання для отримання додаткової інформації.
Техніки пом'якшення та придушення помилок використовуються для покращення якості результатів при масштабуванні до більших робочих навантажень. На цій сторінці наведено загальні пояснення технік придушення та пом'якшення помилок, доступних у Qiskit.
Динамічне роз'єднання
Квантові схеми виконуються на апаратному забезпеченні IBM® у вигляді послідовностей мікрохвильових імпульсів, які потрібно планувати та запускати в точні часові інтервали. На жаль, небажані взаємодії між кубітами можуть призводити до когерентних помилок на простоюючих кубітах. Динамічне роз'єднання працює шляхом вставки послідовностей імпульсів на простоюючих кубітах, щоб приблизно компенсувати вплив цих помилок. Кожна вставлена послідовність імпульсів є операцією тотожності, але фізична наявність імпульсів має ефект придушення помилок. Існує багато можливих варіантів послідовностей імпульсів, і те, яка послідовність краща для кожного конкретного випадку, залишається активною областю досліджень.
Зверни увагу, що динамічне роз'єднання в основному корисне для схем, що містять проміжки, у яких деякі кубіти простоюють без будь-яких операцій над ними. Якщо операції в схемі розміщені дуже щільно, так що всі кубіти більшість часу зайняті, то додавання імпульсів динамічного роз'єднання може не покращити продуктивність. Насправді це може навіть погіршити продуктивність через недосконалості самих імпульсів.
Діаграма нижче зображує динамічне роз'єднання з послідовністю імпульсів XX. Абстрактна схема ліворуч відображається на розклад мікрохвильових імпульсів у верхньому правому куті. У нижньому правому куті зображено той самий розклад, але з послідовністю двох X-імпульсів, вставленою під час простою першого кубіта.
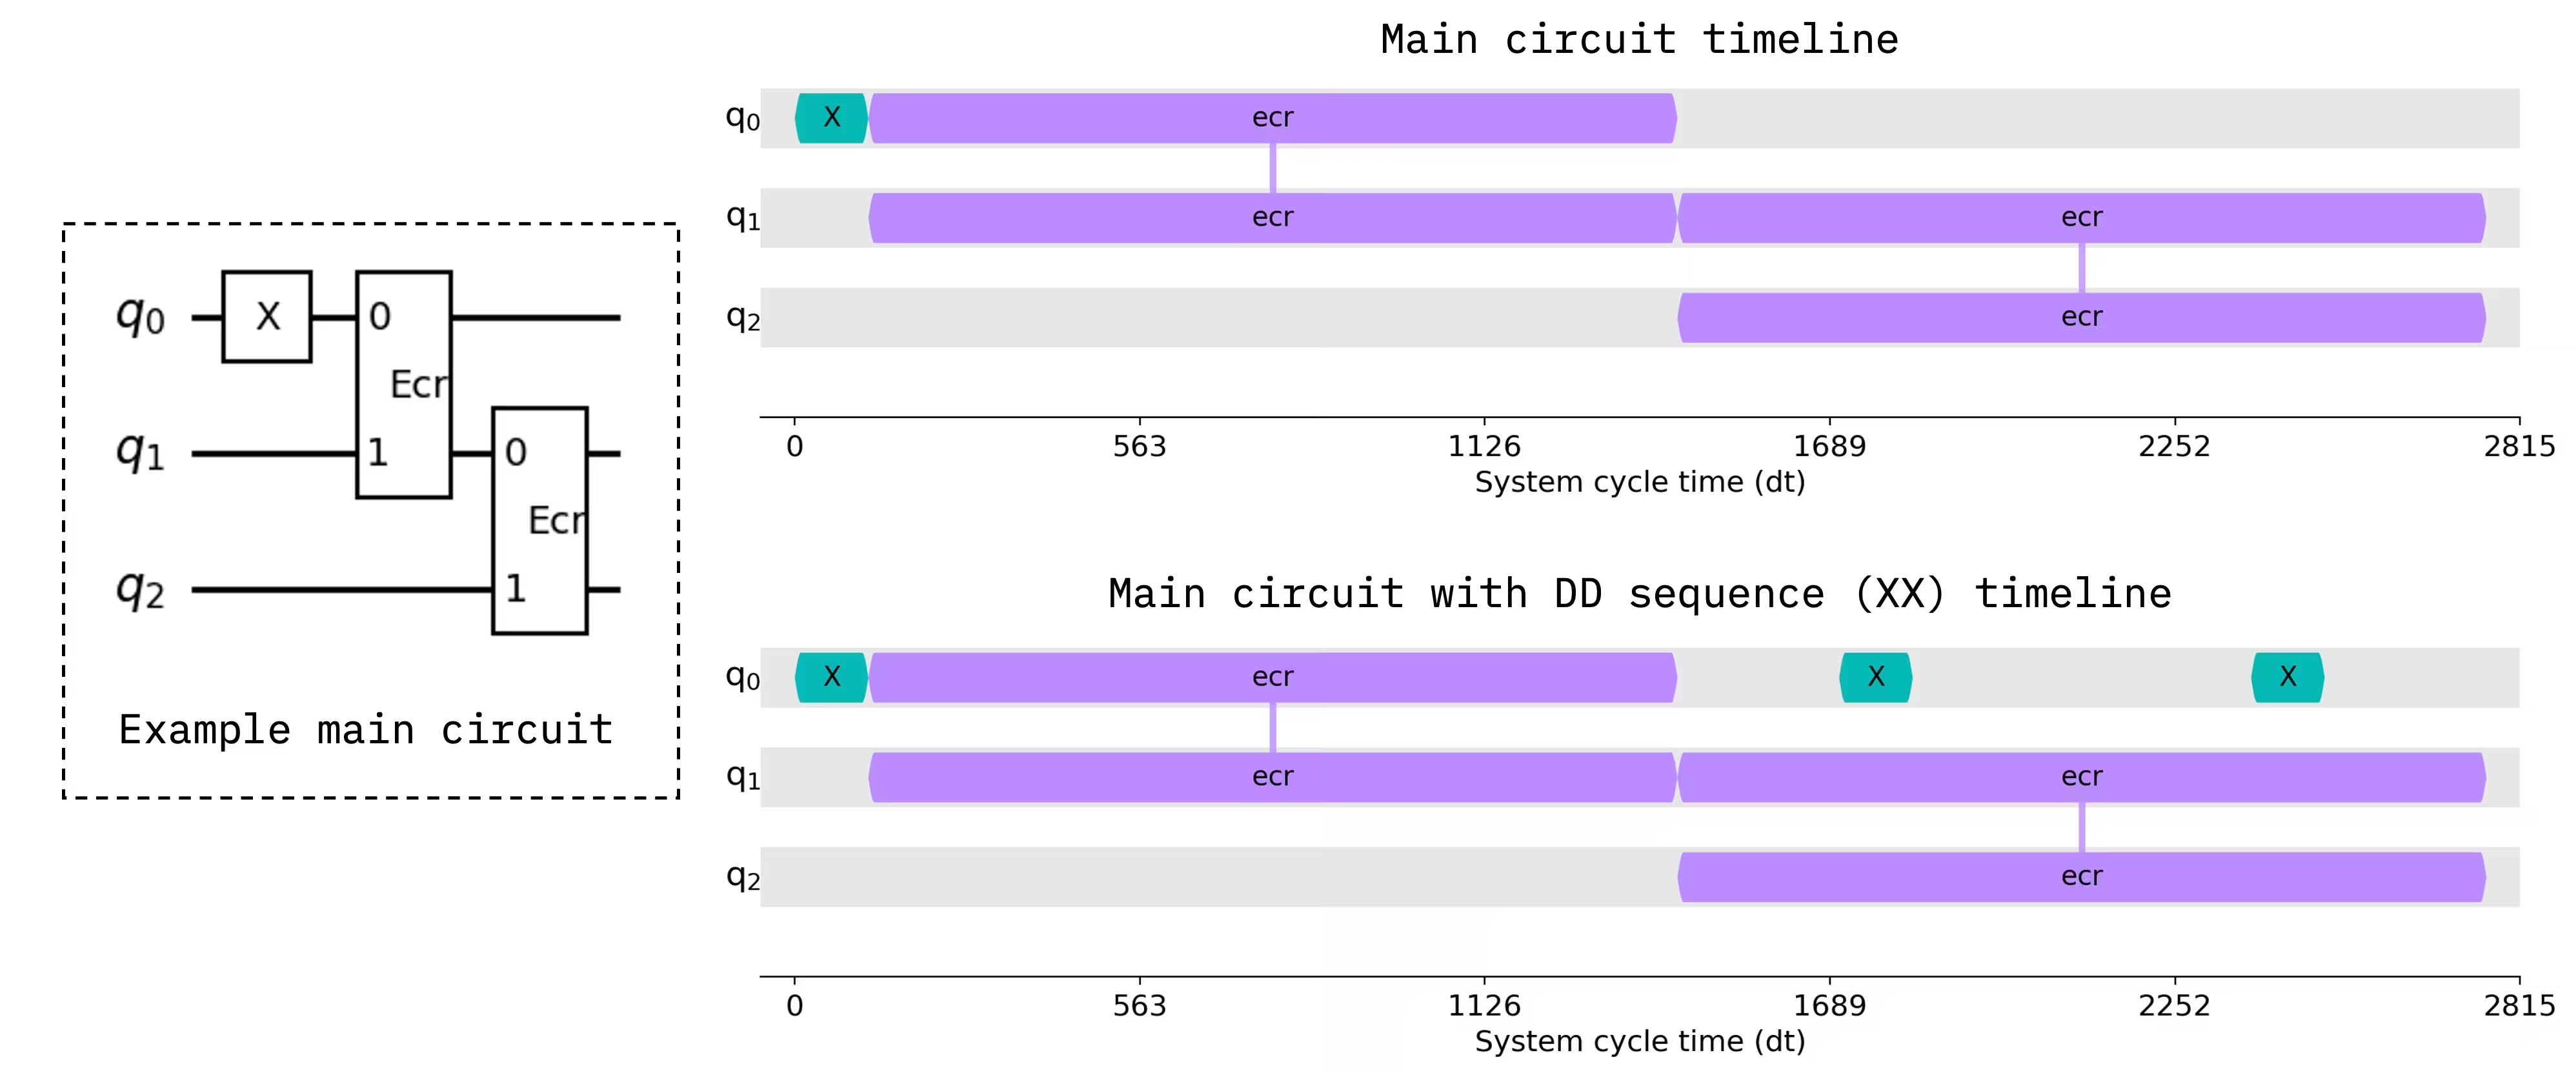
Динамічне роз'єднання можна ввімкнути так:
- Прохід транспілятора динамічного роз'єднання у Qiskit
- Параметр динамічного роз'єднання, якщо використовуєш IBM Quantum Estimator або Sampler
Скручування Паулі
Скручування, також відоме як рандомізована компіляція, є широко вживаною технікою для перетворення довільних каналів шуму на канали шуму з більш конкретною структурою.
Скручування Паулі — це особливий вид скручування, що використовує операції Паулі. Воно має ефект перетворення будь-якого квантового каналу на канал Паулі. Виконуване саме по собі, воно може пом'якшити когерентний шум, оскільки когерентний шум, як правило, накопичується квадратично з кількістю операцій, тоді як шум Паулі накопичується лінійно. Скручування Паулі часто поєднується з іншими техніками пом'якшення помилок, які краще працюють із шумом Паулі, ніж із довільним шумом.
Скручування Паулі реалізується шляхом «обгортання» вибраного набору гейтів випадково обраними однокубітними гейтами Паулі таким чином, що ідеальний ефект гейта залишається незмінним. У результаті одна схема замінюється випадковим ансамблем схем, усі з однаковим ідеальним ефектом. При вибірці схеми зразки беруться з кількох випадкових екземплярів, а не лише з одного.
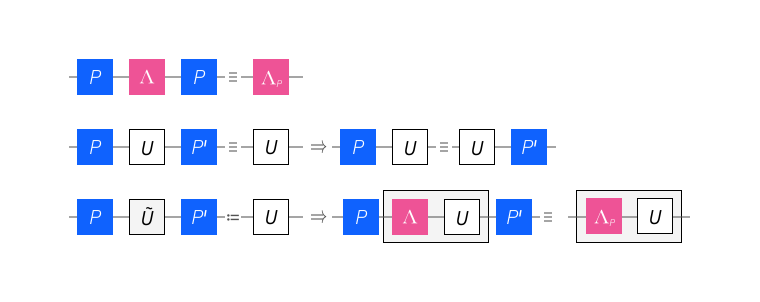
Оскільки більшість помилок у сучасному квантовому апаратному забезпеченні походить від двокубітних гейтів, ця техніка часто застосовується виключно до (нативних) двокубітних гейтів. Наступна діаграма зображує деякі скручування Паулі для гейтів CNOT і ECR. Кожна схема в рядку має однаковий ідеальний ефект.
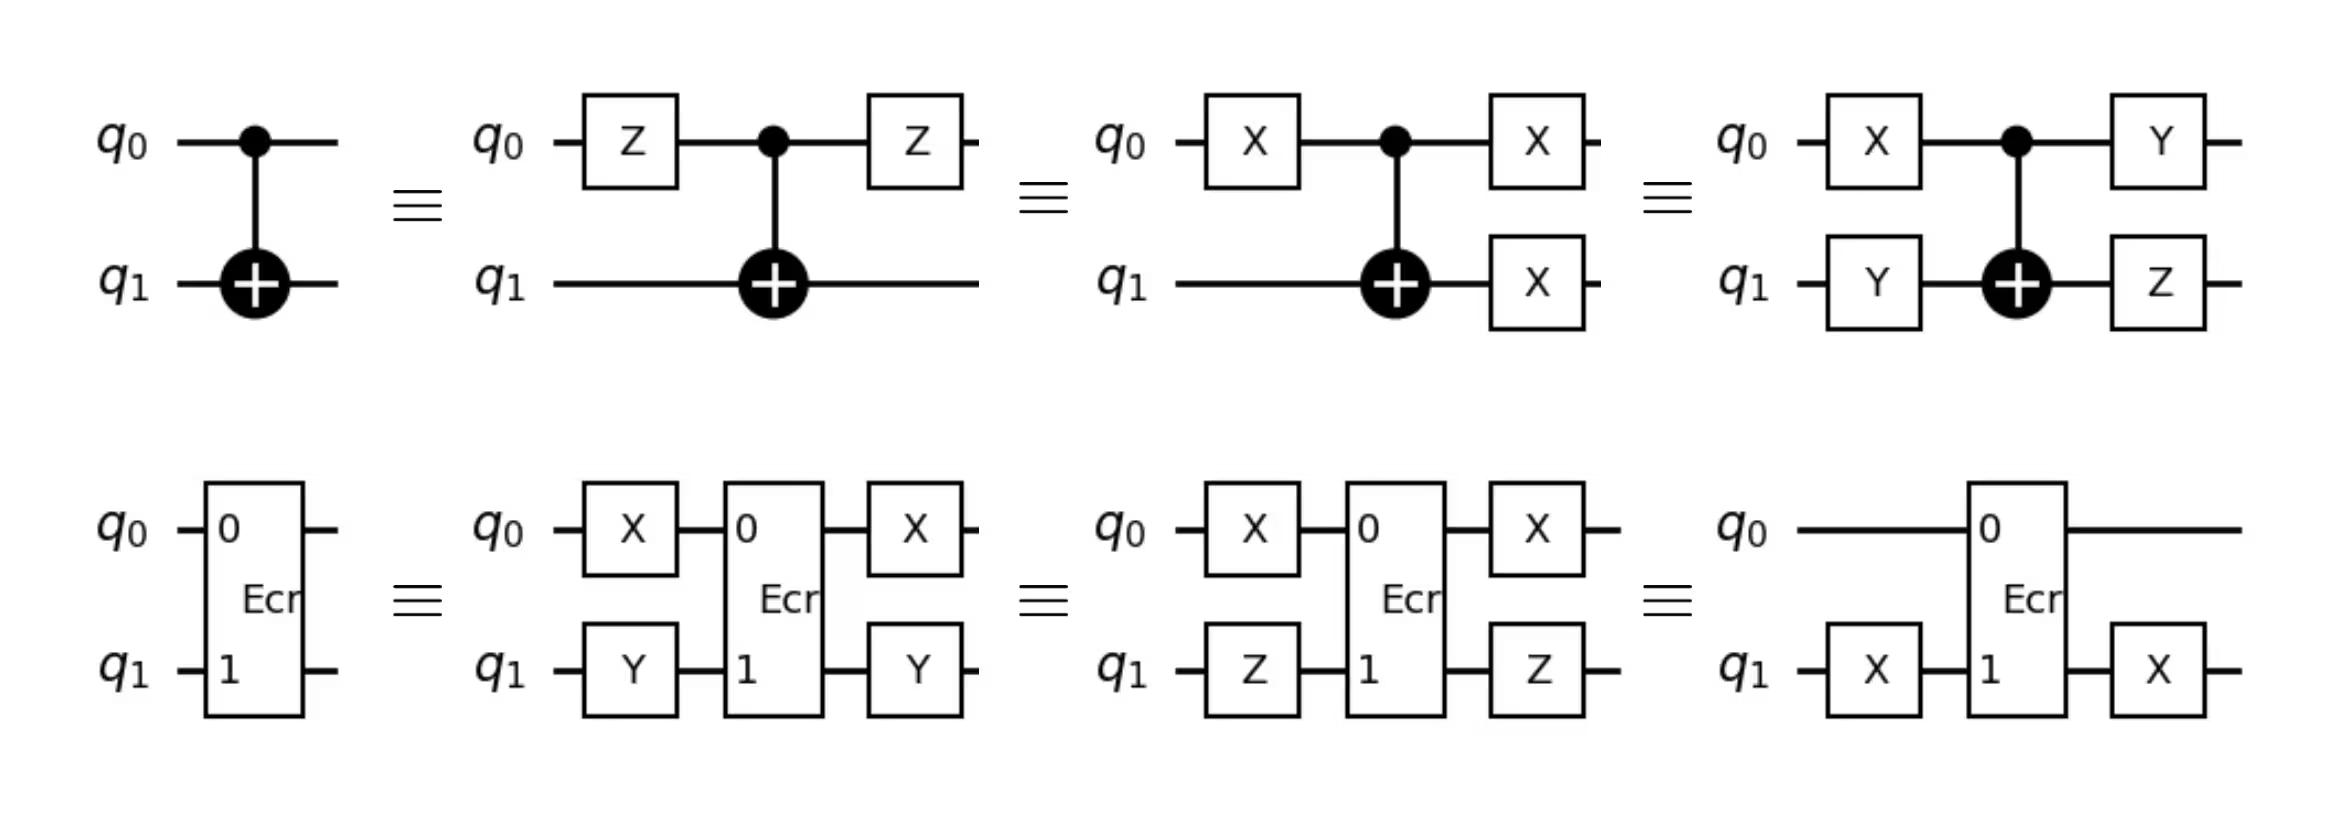
Скручування Паулі можна ввімкнути так:
- Власний прохід скручування Паулі у Qiskit
- Параметри скручування, якщо використовуєш IBM Quantum Estimator або Sampler
Скручуване усунення помилок зчитування (TREX)
Скручуване усунення помилок зчитування (TREX) пом'якшує вплив помилок вимірювання при оцінці очікуваних значень спостережуваних операторів Паулі. Воно базується на понятті скручуваних вимірювань, що досягаються шляхом випадкової заміни гейтів вимірювання послідовністю з (1) гейта Паулі X, (2) вимірювання та (3) класичного перемикання біта. Як і при стандартному скручуванні гейтів, ця послідовність еквівалентна простому вимірюванню за відсутності шуму, як зображено на наступній діаграмі:

За наявності помилки зчитування скручування вимірювань має ефект діагоналізації матриці переносу помилок зчитування, що робить її легкою для інвертування. Коефіцієнт масштабування з діагонального каналу шуму вивчається шляхом тестування випадкових схем, ініціалізованих у нульовому стані. Це дозволяє сервісу усувати зміщення в очікуваних значеннях, спричинене шумом зчитування. Оцінка матриці переносу помилок зчитування потребує виконання додаткових калібрувальних схем, що вносить невеликі накладні витрати.
TREX можна ввімкнути так:
- Доповнення Qiskit Mitigation для Qiskit
- Параметр
measure_mitigation, якщо використовуєш IBM Quantum Estimator - Рівень стійкості, якщо використовуєш IBM Quantum Estimator
Екстраполяція до нульового шуму (ZNE)
Екстраполяція до нульового шуму (ZNE) — це техніка пом'якшення помилок при оцінці очікуваних значень спостережуваних операторів. Хоча вона часто покращує результати, вона не гарантує отримання незміщеного результату.
ZNE складається з двох етапів:
-
Підсилення шуму: Оригінальна квантова схема виконується кілька разів при різних рівнях шуму.
-
Екстраполяція: Ідеальний результат оцінюється шляхом екстраполяції шумних очікуваних значень до межі нульового шуму.
Обидва етапи — підсилення шуму та екстраполяція — можуть бути реалізовані різними способами. IBM Quantum Compute реалізує підсилення шуму за допомогою «цифрового складання гейтів», що означає заміну двокубітних гейтів еквівалентними послідовностями гейта та його оберненого. Наприклад, заміна унітарного на дасть коефіцієнт підсилення шуму 3. Для екстраполяції можна вибрати одну з кількох функціональних форм, включаючи лінійну або експоненційну апроксимацію. На зображенні нижче ліворуч зображено цифрове складання гейтів, а праворуч — процедуру екстраполяції.
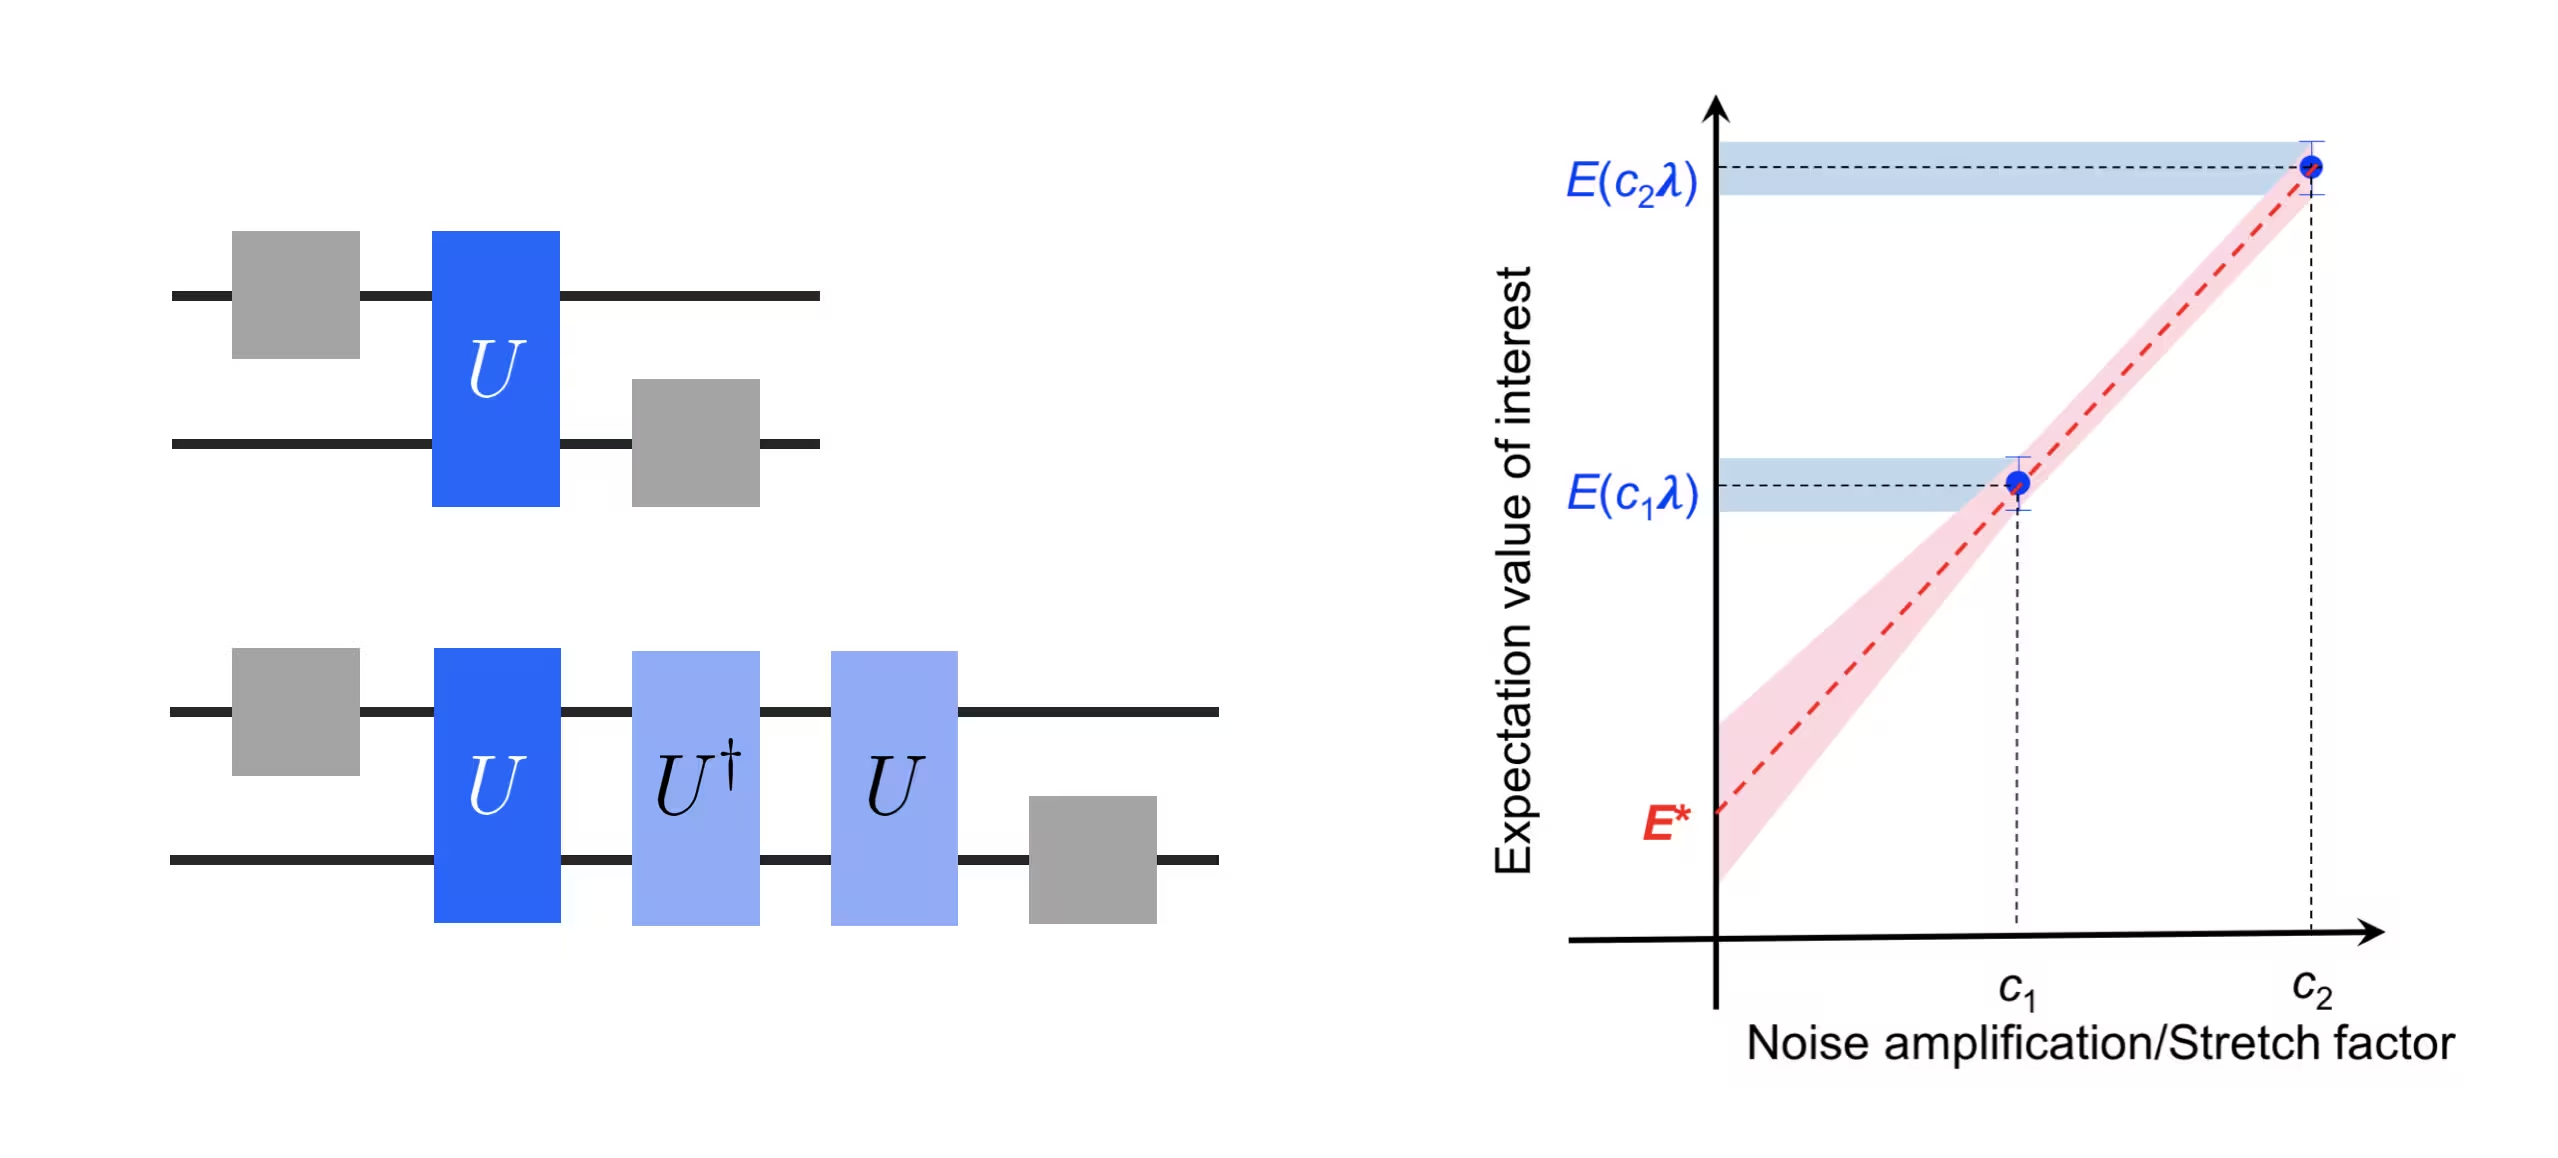
Накладні витрати цього методу масштабуються з кількістю коефіцієнтів шуму. Налаштування за замовчуванням беруть зразок очікуваного значення при трьох коефіцієнтах шуму, що призводить до приблизно 3-кратних накладних витрат.
ZNE можна ввімкнути так:
- Доповнення Qiskit Mitigation для Qiskit
- Параметр
zne_mitigation, якщо використовуєш IBM Quantum Estimator - Рівень стійкості, якщо використовуєш IBM Quantum Estimator
Імовірнісне підсилення помилок (PEA)
Одним із головних викликів у ZNE є точне підсилення шуму, що впливає на цільову схему. Складання гейтів забезпечує простий спосіб виконання цього підсилення, але потенційно є неточним і може призводити до неправильних результатів. Дивись статтю "Scalable error mitigation for noisy quantum circuits produces competitive expectation values", зокрема стор. 4 додаткової інформації для деталей. Імовірнісне підсилення помилок забезпечує більш точний підхід до підсилення помилок через вивчення шуму.
PEA — це більш складна техніка, яка проводить попередні експерименти для реконструкції шуму, а потім використовує цю інформацію для виконання точного підсилення. Спочатку вона вивчає скручену модель шуму кожного шару заплутувальних гейтів у схемі перед їх виконанням. Після фази вивчення схеми виконуються при кожному коефіцієнті шуму, де кожен заплутувальний шар схем підсилюється шляхом імовірнісного введення однокубітного шуму, пропорційного відповідній вивченій моделі шуму. Дивись статтю "Evidence for the utility of quantum computing before fault tolerance" для отримання додаткової інформації.
PEA складається з трьох етапів:
- Навчання: Вивчається скручена модель шуму кожного шару заплутувальних гейтів у схемі.
- Підсилення шуму: Оригінальна квантова схема виконується кілька разів при різних коефіцієнтах шуму.
- Екстраполяція: Ідеальний результат оцінюється шляхом екстраполяції шумних очікуваних значень до межі нульового шуму.
Для експериментів у масштабі реальних задач PEA часто є найкращим вибором.
Оскільки PEA є технікою підсилення шуму для ZNE, потрібно також увімкнути ZNE. PEA і ZNE можна ввімкнути так:
- Доповнення Qiskit Mitigation для Qiskit
- Параметр
zne_mitigationзpeaяк підсилювачем, якщо використовуєш IBM Quantum Estimator
Якщо ти використовуєш новий клієнтський Estimator, представлений у qiskit-ibm-runtime v0.50.0, для використання PEA потрібне окреме завдання з вивчення шуму.
Див. Міграція з серверних на клієнтські Sampler та Estimator для отримання додаткової інформації.
Імовірнісне скасування помилок (PEC)
Імовірнісне скасування помилок (PEC) — це техніка пом'якшення помилок при оцінці очікуваних значень спостережуваних операторів. На відміну від ZNE, вона повертає незміщену оцінку очікуваного значення. Однак вона, як правило, несе більші накладні витрати.
У PEC ефект ідеальної цільової схеми виражається як лінійна комбінація шумних схем, які насправді можна реалізувати на практиці:
Вихідні дані ідеальної схеми можна потім відтворити, виконуючи різні шумні екземпляри схем, взяті з випадкового ансамблю, визначеного лінійною комбінацією. Якщо коефіцієнти утворюють розподіл імовірностей, їх можна використовувати безпосередньо як імовірності ансамблю. На практиці деякі коефіцієнти є від'ємними, тому вони утворюють квазіімовірнісний розподіл. Їх все одно можна використовувати для визначення випадкового ансамблю, але існують накладні витрати на вибірку, пов'язані з від'ємністю квазіімовірнісного розподілу, що характеризується величиною
Накладні витрати на вибірку є мультиплікативним коефіцієнтом для кількості вимірювань, необхідних для оцінки очікуваного значення з заданою точністю, порівняно з кількістю вимірювань, яка знадобилася б для ідеальної схеми. Вони масштабуються квадратично з , що, у свою чергу, масштабується експоненційно з глибиною схеми.
PEC можна ввімкнути так:
- Доповнення Qiskit Mitigation для Qiskit
- Параметр
pec_mitigation, якщо використовуєш IBM Quantum Estimator
Якщо ти використовуєш новий клієнтський Estimator, представлений у qiskit-ibm-runtime v0.50.0, для використання PEC потрібне окреме завдання з вивчення шуму.
Див. Міграція з серверних на клієнтські Sampler та Estimator для отримання додаткової інформації.
Наступні кроки
-
Ознайомся з навчальним посібником про поєднання параметрів пом'якшення помилок із примітивом Estimator.
-
Досліди інші параметри для примітивів IBM Quantum.
-
Вибери, в якому режимі виконання запустити своє завдання.