Управління продуктивністю: функція Qiskit від Q-CTRL Fire Opal
Дивись довідник API
Qiskit Functions — це експериментальна можливість, доступна лише користувачам IBM Quantum® Premium Plan, Flex Plan і On-Prem (через API IBM Quantum Platform). Вони перебувають у статусі попереднього релізу та можуть змінюватись.
Package versions
Код на цій сторінці розроблено з використанням таких вимог. Ми рекомендуємо використовувати ці версії або новіші.
qiskit[all]~=2.3.1
qiskit-ibm-runtime~=0.45.1
Огляд
Fire Opal Performance Management дозволяє будь-кому легко отримувати значущі результати від квантових комп'ютерів у масштабі, не будучи експертом з квантового заліза. Під час запуску схем із Fire Opal Performance Management автоматично застосовуються методи придушення помилок на основі ШІ, що дає змогу масштабувати більші задачі з більшою кількістю гейтів і кубітів. Такий підхід зменшує кількість вимірювань (shots), необхідних для отримання правильної відповіді, без жодних додаткових накладних витрат — що суттєво економить і час обчислень, і кошти.
Performance Management придушує помилки та підвищує ймовірність отримання правильної відповіді на зашумленому залізі. Іншими словами, він збільшує відношення сигнал/шум. На зображенні нижче показано, як підвищена точність завдяки Performance Management може зменшити потребу в додаткових вимірюваннях на прикладі 10-кубітного алгоритму Квантового перетворення Фур'є. Маючи лише 30 вимірювань, Q-CTRL досягає порогу впевненості 99%, тоді як налаштування за замовчуванням (QiskitRuntime Sampler, optimization_level=3 та resilience_level=1, ibm_sherbrooke) вимагають 170 000 вимірювань. Отримуючи правильну відповідь швидше, ти суттєво економиш обчислювальний час.
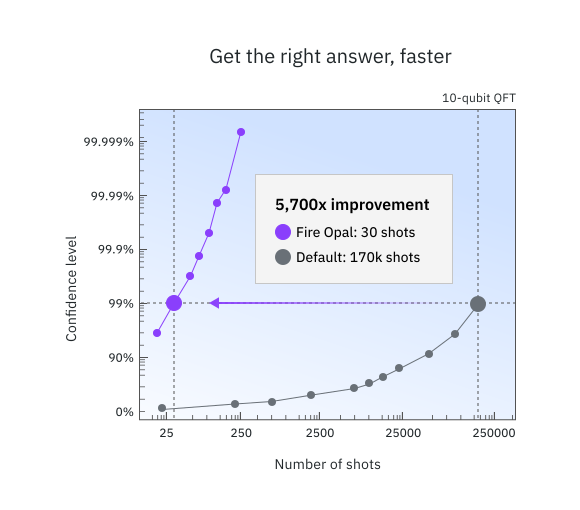
Функцію Performance Management можна використовувати з будь-яким алгоритмом, і нею легко замінити стандартні примітиви IBM Quantum. За лаштунками кілька методів придушення помилок працюють разом, запобігаючи виникненню помилок під час виконання. Усі методи конвеєра Fire Opal попередньо налаштовані та не залежать від алгоритму — ти завжди отримуєш найкращу продуктивність «з коробки».
Щоб отримати доступ до Performance Management, звернись до Q-CTRL.
Опис
Fire Opal Performance Management має два варіанти виконання, схожих на примітиви IBM Quantum, тому ти можеш легко замінити їх Q-CTRL Sampler і Estimator. Загальний робочий процес використання функції Performance Management такий:
- Визнач свою схему (і оператори у випадку Estimator).
- Запусти схему.
- Отримай результати.
Щоб зменшити апаратний шум, Fire Opal використовує низку методів придушення помилок на основі ШІ, зображених на малюнку нижче. У Fire Opal весь конвеєр повністю автоматизований і не потребує жодного налаштування.
Конвеєр Fire Opal усуває потребу в додаткових накладних витратах, таких як збільшений квантовий час виконання або додаткові фізичні кубіти. Зверни увагу, що класичний час обробки залишається чинником (орієнтовні значення наведено в розділі Бенчмарки, де «Загальний час» відображає як класичну, так і квантову обробку). На відміну від пом'якшення помилок, яке вимагає накладних витрат у формі вибірки, придушення помилок Fire Opal працює як на рівні гейтів, так і на рівні імпульсів, щоб усунути різні джерела шуму та запобігти виникненню помилок. Завдяки запобіганню помилкам усувається потреба в дорогій постобробці.
На зображенні нижче показані методи придушення помилок, автоматизовані Fire Opal Performance Management.
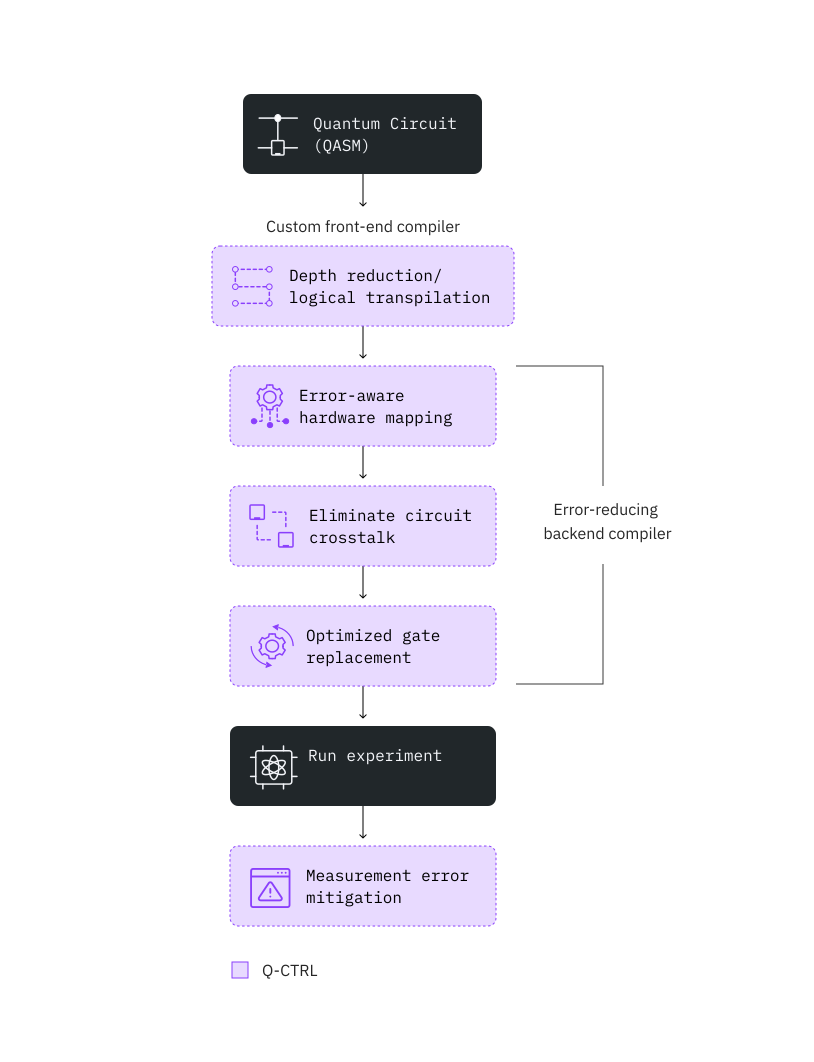
Функція пропонує два примітиви — Sampler і Estimator, — а їхні вхідні та вихідні дані розширюють реалізовану специфікацію примітивів IBM Quantum V2.
Бенчмарки
Опубліковані результати алгоритмічних бенчмарків демонструють значне покращення продуктивності для різних алгоритмів, зокрема Бернштейна–Вазірані, квантового перетворення Фур'є, пошуку Гровера, квантового алгоритму апроксимаційної оптимізації та варіаційного квантового eigensolver. У решті цього розділу наведено докладнішу інформацію про типи алгоритмів, які можна запускати, а також про очікувану продуктивність і час виконання.
Наступні незалежні дослідження демонструють, як Performance Management від Q-CTRL дає змогу проводити алгоритмічні дослідження рекордного масштабу:
- Parametrized Energy-Efficient Quantum Kernels for Network Service Fault Diagnosis — квантове навчання на ядрах до 50 кубітів
- Tensor-based quantum phase difference estimation for large-scale demonstration — квантова оцінка фази до 33 кубітів
- Hierarchical Learning for Quantum ML: Novel Training Technique for Large-Scale Variational Quantum Circuits — квантове завантаження даних до 21 кубіта
У таблиці нижче наведено приблизний орієнтир щодо точності та часу виконання за попередніми бенчмарками на ibm_fez. Продуктивність на інших пристроях може відрізнятися. Час використання розраховано виходячи з припущення про 10 000 вимірювань на схему. Зазначена «Кількість кубітів» — це не жорстке обмеження, а приблизні пороги, за яких можна очікувати надзвичайно стабільної точності розв'язку. Задачі більшого розміру також були успішно розв'язані, і тестування за цими межами заохочується.
| Приклад | Кількість кубітів | Точність | Міра точності | Загальний час (с) | Час використання (с) | Примітив (Режим) |
|---|---|---|---|---|---|---|
| Bernstein–Vazirani | 50Q | 100% | Відсоток успіху (частка запусків, у яких правильна відповідь є бітрядком із найбільшою кількістю підрахунків) | 10 | 8 | Sampler |
| Квантове перетворення Фур'є | 30Q | 100% | Відсоток успіху (частка запусків, у яких правильна відповідь є бітрядком із найбільшою кількістю підрахунків) | 10 | 8 | Sampler |
| Квантова оцінка фази | 30Q | 99.9998% | Точність знайденого кута: 1- abs(real_angle - angle_found)/pi | 10 | 8 | Sampler |
| Квантова симуляція: модель Ізінга (15 кроків) | 20Q | 99.775% | (визначено нижче) | 60 (на крок) | 15 (на крок) | Estimator |
| Квантова симуляція 2: молекулярна динаміка (20 часових точок) | 34Q | 96.78% | (визначено нижче) | 10 (на часову точку) | 6 (на часову точку) | Estimator |
Визначення точності вимірювання значення математичного сподівання — метрика визначається так:
де = ідеальне значення математичного сподівання, = виміряне значення математичного сподівання, = ідеальне максимальне значення, а = ідеальне мінімальне значення. — це просто середнє значення за кількома вимірюваннями.
Ця метрика використовується тому, що вона інваріантна до глобальних зсувів і масштабування діапазону досяжних значень. Іншими словами, незалежно від того, чи зміщуєш ти діапазон можливих значень математичного сподівання вгору чи вниз, або збільшуєш розкид, значення залишається стабільним.
Початок роботи
Fire Opal Performance Management використовує Qiskit v2.0.0, яка є рекомендованою версією. Підтримувані версії: Qiskit >=v2.0.0.
Автентифікуйся за допомогою свого API-ключа IBM Quantum Platform та вибери функцію Qiskit так. (Цей фрагмент коду припускає, що ти вже зберіг свій обліковий запис у локальному середовищі.)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
# This cell is hidden from users. It hides the "...You have imported samplomatic..." warning.
import warnings

warnings.filterwarnings("ignore", message=".*You have imported samplomatic*")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# verify that you have access to the function
catalog.list()
[QiskitFunction(qunova/hivqe-chemistry),
 QiskitFunction(global-data-quantum/quantum-portfolio-optimizer),
 QiskitFunction(algorithmiq/tem),
 QiskitFunction(qedma/qesem),
 QiskitFunction(multiverse/singularity),
 QiskitFunction(ibm/circuit-function),
 QiskitFunction(q-ctrl/optimization-solver),
 QiskitFunction(colibritd/quick-pde),
 QiskitFunction(q-ctrl/performance-management),
 QiskitFunction(kipu-quantum/iskay-quantum-optimizer)]
# Access Function
perf_mgmt = catalog.load("q-ctrl/performance-management")
Якщо ти хочеш використати бекенд, який ця функція наразі не підтримує, звернись до Q-CTRL, щоб додати підтримку.
Примітив Estimator
Приклад Estimator
Використовуй примітив Estimator з Fire Opal Performance Management, щоб визначити значення математичного сподівання для пари схема–спостережувана.
Крім пакетів qiskit-ibm-catalog і qiskit, для цього прикладу також потрібен пакет numpy. Якщо ти запускаєш цей приклад у ноутбуці з ядром IPython, можеш встановити цей пакет, розкоментувавши наступну комірку.
# %pip install numpy
1. Створи схему
Як приклад, згенеруй випадковий ермітовий оператор і спостережувану величину для передачі до функції Performance Management.
import numpy as np
from qiskit.circuit.library import iqp
from qiskit.quantum_info import random_hermitian, SparsePauliOp

n_qubits = 50

# Generate a random circuit
mat = np.real(random_hermitian(n_qubits, seed=1234))
circuit = iqp(mat)
circuit.measure_all()

# Define observables as a string
observable = SparsePauliOp("Z" * n_qubits)
# Create PUB tuple
estimator_pubs = [(circuit, observable)]
2. Запусти схему
Запусти схему та за бажанням визнач бекенд і кількість вимірювань.
# This cell is hidden from users
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend_name = service.least_busy().name
# Run the circuit using Estimator
qctrl_estimator_job = perf_mgmt.run(
    primitive="estimator",
    pubs=estimator_pubs,
    backend_name=backend_name,
)
Ти можеш використовувати знайомі API Qiskit Serverless, щоб перевірити статус свого робочого навантаження функції Qiskit:
qctrl_estimator_job.status()
'QUEUED'
3. Отримай результат
# Retrieve the counts from the result list
result = qctrl_estimator_job.result()
Результати мають той самий формат, що й результат Estimator:
import numpy

result_str = str(result)

with numpy.printoptions(threshold=200):
    print(
        f"The result of the submitted job had {len(result)} PUB "
        f"and has a value:\n {result[0]}\n"
    )

print("The associated PubResult of this job has the following DataBins:")
print(f"{result[0].data}\n")

print(f"And this DataBin has attributes: {result[0].data.keys()}")

print("The expectation values measured from this PUB are:")
print(f"{result[0].data.evs}")
The result of the submitted job had 1 PUB
The result of the submitted job had 1 PUB and has a value:
 PubResult(data=DataBin(evs=0.0195, stds=0.9998098569228051), metadata={'precision': None})

The associated PubResult of this job has the following DataBins:
DataBin(evs=0.0195, stds=0.9998098569228051)

And this DataBin has attributes: dict_keys(['evs', 'stds'])
The expectation values measured from this PUB are:
0.0195
Примітив Sampler
Приклад Sampler
Використовуй примітив Sampler з Fire Opal Performance Management для запуску схеми Бернштейна–Вазірані. Цей алгоритм, що використовується для знаходження прихованого рядка з виходів функції «чорного ящика», є поширеним алгоритмом для бенчмаркінгу, оскільки має єдину правильну відповідь. 1. Створи схему
Визнач правильну відповідь алгоритму — прихований бітрядок — і схему Бернштейна–Вазірані. Ти можеш регулювати ширину схеми, просто змінивши circuit_width.
import qiskit

circuit_width = 35
hidden_bitstring = "1" * circuit_width

# Create circuit, reserving one qubit for BV oracle
bv_circuit = qiskit.QuantumCircuit(circuit_width + 1, circuit_width)
bv_circuit.x(circuit_width)
bv_circuit.h(range(circuit_width + 1))
for input_qubit, bit in enumerate(reversed(hidden_bitstring)):
    if bit == "1":
        bv_circuit.cx(input_qubit, circuit_width)
bv_circuit.barrier()
bv_circuit.h(range(circuit_width + 1))
bv_circuit.barrier()
for input_qubit in range(circuit_width):
    bv_circuit.measure(input_qubit, input_qubit)

# Create PUB tuple
sampler_pubs = [(bv_circuit,)]
2. Запусти схему
Запусти схему та за бажанням визнач бекенд і кількість вимірювань.
# Run the circuit using Sampler
qctrl_sampler_job = perf_mgmt.run(
    primitive="sampler",
    pubs=sampler_pubs,
    backend_name=backend_name,
)
Перевір статус свого робочого навантаження функції Qiskit або отримай результати так:
# Print the ID so you can use it later, if necessary
print(qctrl_sampler_job.job_id)

qctrl_sampler_job.status()
60fe2fa1-a860-43e4-8615-c6ac4180f93b
'QUEUED'
3. Отримай результат
# Retrieve the job results
sampler_result = qctrl_sampler_job.result()
# Get results for the first (and only) PUB
pub_result = sampler_result[0]
counts = pub_result.data.c.get_counts()

print("Counts for the meas output register (limited to 30 results):")
for i, (bitstring, count) in enumerate(counts.items()):
    if i >= 50:
        print(f"  ... ({len(counts) - 30} more items)")
        break
    print(f"  {bitstring}: {count}")
Counts for the meas output register (limited to 30 results):
  11111111111111111111111111111111111: 1661
  11111111111111111111111111110111111: 60
  11111111111111111111111111111101111: 54
  11111111111111111111111111111110111: 54
  11111111111111011111111111111111111: 46
  11111111111111111110111111111111111: 44
  11111111111111111111111101111111111: 42
  11111111111111111111111110111111111: 42
  11111111111111110111111111111111111: 41
  11111111111111111111111111111111101: 39
  11111111111111111111101111111111111: 38
  11111111111111111111110111111111111: 38
  11111111111111111111111111101111111: 37
  11111111111111111111111111111111110: 36
  11111111111110111111111111111111111: 35
  11111111111111111111111111111011111: 32
  11111111111111101111111111111111111: 32
  01111111111111111111111111111111111: 27
  11111111111111111011111111111111111: 23
  11111111101111111111111111111111111: 22
  11111111111111111111111111111111011: 21
  11111111011111111111111111111111111: 20
  00000000000000011111111111111111111: 18
  11111111111111111111110101111111111: 18
  00000001111111111111111111111111111: 17
  11111111001111111111111111111111111: 16
  11101111111111111111111111111111111: 16
  11111111111101111111111111111111111: 16
  00000101111111111111111111111111111: 13
  11111111111111111111111011111111111: 13
  11111111111111111111111110101111111: 13
  11111111111111111101111111111111111: 12
  10111111111111111111111111111111111: 12
  11111111111111111111111110001111111: 12
  00000000000000000011111111111111111: 11
  11111111111111111111111111111110110: 10
  00000000000000000000000001111111111: 10
  11111111111011111111111111111111111: 9
  11111111111111101011111111111111111: 9
  00000000011111111111111111111111111: 8
  10101111111111111111111111111111111: 8
  00000000000000000000000001011111111: 8
  11111111111111111111111111111111001: 8
  00000111111111111111111111111111111: 7
  11111111111111111111111111111101110: 7
  11111111110111111111111111111111111: 7
  00000000000001011111111111111111111: 6
  00000000000000001111111111111111111: 6
  00000000000000000001011111111111111: 6
  11111111111111111111111111011111111: 6
  ... (1050 more items)
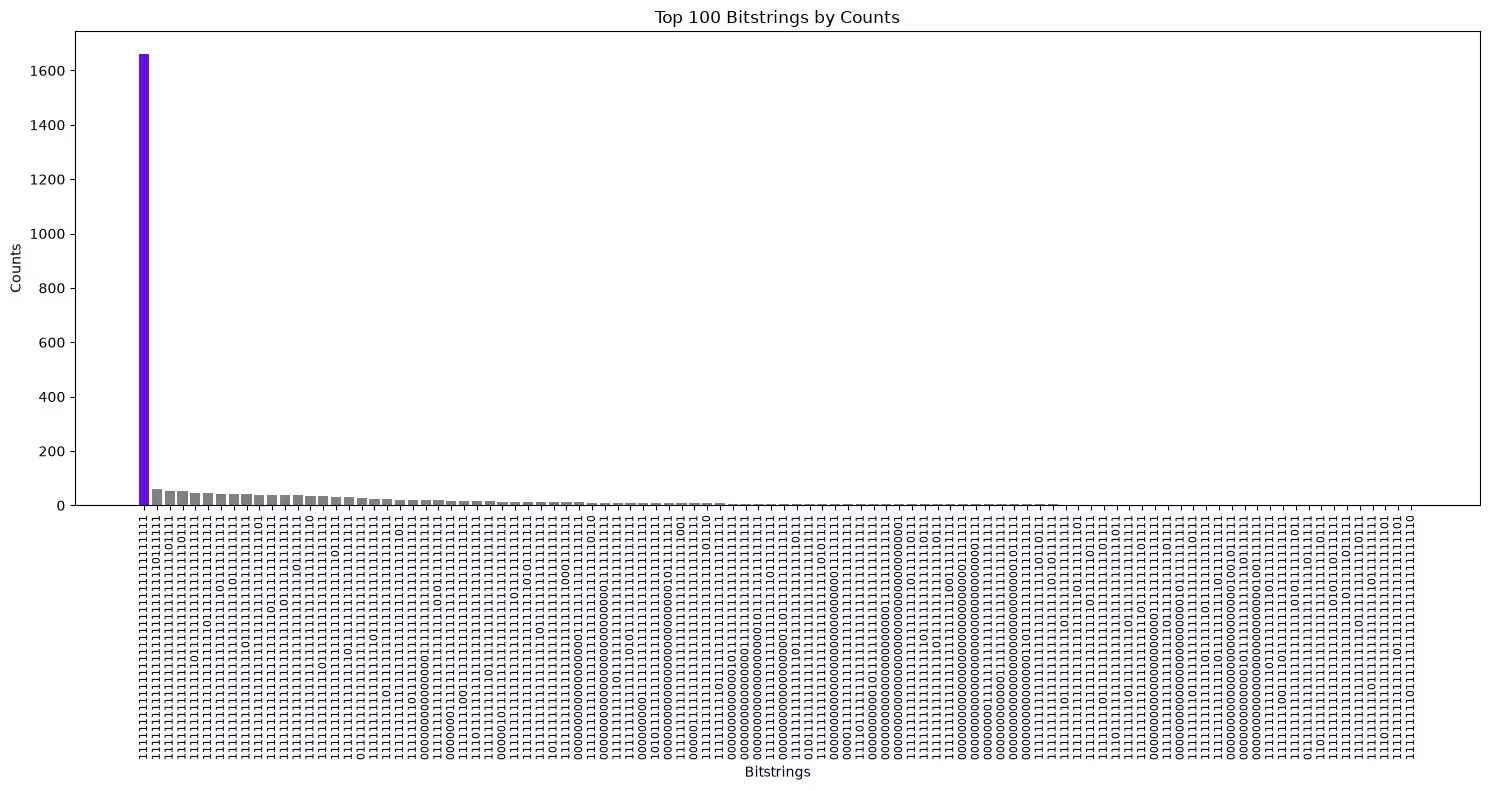
3. Побудуй графік найкращих бітрядків
Побудуй графік бітрядка з найбільшою кількістю підрахунків, щоб перевірити, чи є прихований бітрядок модою.
import matplotlib.pyplot as plt

def plot_top_bitstrings(counts_dict, hidden_bitstring=None):
    # Sort and take the top 100 bitstrings
    top_100 = sorted(counts_dict.items(), key=lambda x: x[1], reverse=True)[
        :100
    ]
    if not top_100:
        print("No bitstrings found in the input dictionary.")
        return

    # Unzip the bitstrings and their counts
    bitstrings, counts = zip(*top_100)

    # Assign colors: purple if the bitstring matches hidden_bitstring,
    # otherwise gray
    colors = [
        "#680CE9" if bit == hidden_bitstring else "gray" for bit in bitstrings
    ]

    # Create the bar plot
    plt.figure(figsize=(15, 8))
    plt.bar(
        range(len(bitstrings)), counts, tick_label=bitstrings, color=colors
    )

    # Rotate the bitstrings for better readability
    plt.xticks(rotation=90, fontsize=8)
    plt.xlabel("Bitstrings")
    plt.ylabel("Counts")
    plt.title("Top 100 Bitstrings by Counts")

    # Show the plot
    plt.tight_layout()
    plt.show()
Прихований бітрядок виділено фіолетовим, і він має бути бітрядком із найбільшою кількістю підрахунків.
plot_top_bitstrings(counts, hidden_bitstring)
Журнал змін
-
2026-02-20: Deprecation Notice - поле метаданих
provider_job_idsбуде застаріле через 30 днів у версії 0.13.0. Користувачі можуть отримати ідентифікатор завдання через методjob_id()сервісу виконання. -
2026-02-11: Ми тепер підтримуємо
ibm_miamiі додали метадані виконання доPubResult.
Отримати підтримку
З будь-якими питаннями або проблемами звернись до Q-CTRL.
Наступні кроки
-
Запроси доступ до Q-CTRL Performance Management.
-
Відвідай довідник API для цієї функції Qiskit.
-
Спробуй навчальний посібник Модель Ізінга з поперечним полем із Performance Management від Q-CTRL.
-
Спробуй навчальний посібник Квантова оцінка фази з Qiskit Functions від Q-CTRL
-
Ознайомся з кейс-стаді Mitsubishi Chemical Corp.
-
Ознайомся з кейс-стаді Redacted bank.
-
Ознайомся з кейс-стаді BlueQubit.