QESEM: функція Qiskit від Qedma
Дивись довідник API
Версії пакетів
Код на цій сторінці був розроблений з використанням наступних вимог. Ми рекомендуємо використовувати ці версії або новіші.
qiskit[all]~=2.5.0
qiskit-ibm-runtime~=0.47.0
Qiskit Functions є експериментальною можливістю, доступною лише для користувачів IBM Quantum® Premium Plan, Flex Plan та On-Prem (через IBM Quantum Platform API) Plan. Вони перебувають у стані попереднього випуску та можуть змінюватись.
Огляд
Хоча квантові процесори значно вдосконалилися за останні роки, помилки через шуми та недосконалості наявного обладнання залишаються центральною проблемою для розробників квантових алгоритмів. У міру того як галузь наближається до квантових обчислень у масштабі корисності, які не піддаються класичній верифікації, рішення для усунення шумів із гарантованою точністю стають дедалі важливішими. Щоб подолати цю проблему, Qedma розробила QESEM (Quantum Error Mitigation — пом'якшення квантових помилок), безперешкодно інтегровану в IBM Quantum Platform як функцію Qiskit.
За допомогою QESEM ти можеш запускати квантові схеми на зашумлених QPU та отримувати точні результати без похибок із мінімальними витратами часу QPU, близькими до фундаментальних меж. Для цього QESEM використовує набір патентованих методів, розроблених Qedma, для характеризації та зменшення помилок. Техніки зменшення помилок включають оптимізацію вентилів, транспіляцію з урахуванням шумів, придушення помилок (ES) та незміщене пом'якшення помилок (EM). Завдяки поєднанню цих методів на основі характеризації користувачі можуть отримувати надійні результати без похибок для загальних квантових схем великого об'єму, відкриваючи застосування, які неможливо реалізувати інакше.
Повний опис базових компонентів, а також демонстрацію у масштабі корисності наведено у статті Reliable high-accuracy error mitigation for utility-scale quantum circuits.
Опис
Ти можеш використовувати функцію QESEM від Qedma для легкого оцінювання та виконання своїх схем із придушенням і пом'якшенням помилок, досягаючи більших об'ємів схем і вищої точності. Щоб використовувати QESEM, ти надаєш квантову схему, набір спостережуваних величин для вимірювання, цільову статистичну точність для кожної з них та вибраний QPU. Перед запуском схеми на цільову точність ти можеш оцінити необхідний час QPU на основі аналітичного розрахунку, який не вимагає виконання схеми. Коли ти задоволений оцінкою часу QPU, можна виконати схему за допомогою QESEM.
Під час виконання схеми QESEM запускає протокол характеризації пристрою, адаптований до твоєї схеми, формуючи надійну модель шуму для помилок, що виникають у схемі. На основі характеризації QESEM спочатку реалізує транспіляцію з урахуванням шумів для відображення вхідної схеми на набір фізичних кубітів і вентилів, що мінімізує шум, який впливає на цільову спостережувану величину. Сюди входять вентили, доступні нативно (CX/CZ на пристроях IBM®), а також додаткові вентили, оптимізовані QESEM, що утворюють розширений набір вентилів QESEM. Потім QESEM запускає набір схем ES і EM на основі характеризації на QPU та збирає результати вимірювань. Вони класично постобробляються для отримання незміщеного математичного сподівання та смуги помилок для кожної спостережуваної величини, що відповідає запитаній точності.
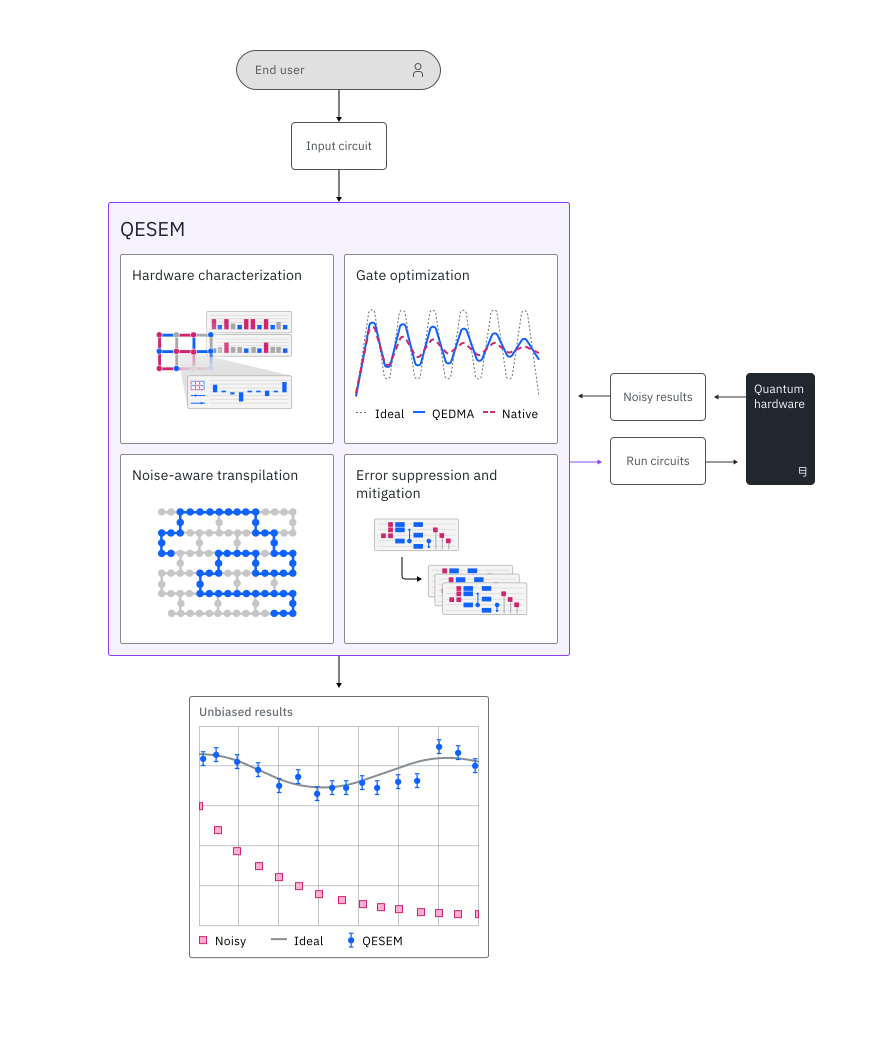 Доведено, що QESEM забезпечує високоточні результати для різноманітних квантових застосувань та для найбільших об'ємів схем, досяжних сьогодні. QESEM пропонує такі функції для користувачів, продемонстровані в розділі бенчмарків нижче:
- Гарантована точність: QESEM видає незміщені оцінки математичних сподівань спостережуваних величин. Його метод EM оснащений теоретичними гарантіями, які — разом із передовою характеризацією Qedma — забезпечують збіжність пом'якшення до виходу ідеальної схеми з точністю, заданою користувачем. На відміну від багатьох евристичних методів EM, схильних до систематичних помилок або зміщень, гарантована точність QESEM є ключовою для отримання надійних результатів у загальних квантових схемах та спостережуваних величинах.
- Масштабованість до великих QPU: Час QPU для QESEM залежить від об'ємів схем, але в іншому не залежить від кількості кубітів. Qedma продемонструвала QESEM на найбільших квантових пристроях, доступних сьогодні, включаючи IBM Quantum Eagle на 127 кубітів та Heron на 133 кубіти.
- Незалежність від застосування: QESEM продемонстровано для різноманітних застосувань, включаючи симуляцію гамільтоніана, VQE, QAOA та оцінку амплітуди. Користувачі можуть вводити будь-яку квантову схему та спостережувану величину для вимірювання та отримувати точні результати без похибок. Єдині обмеження диктуються специфікаціями обладнання та виділеним часом QPU, які визначають доступні об'єми схем та точність вихідних даних. На відміну від цього, багато рішень для зменшення помилок є специфічними для застосувань або включають неконтрольовані евристики, що робить їх непридатними для загальних квантових схем та застосувань.
- Розширений набір вентилів: QESEM підтримує вентилі з дробовими кутами та надає оптимізовані Qedma вентилі з дробовими кутами на пристроях IBM Quantum Heron та Eagle. Цей розширений набір вентилів уможливлює ефективнішу компіляцію та відкриває об'єми схем, більші в до 2 разів порівняно зі стандартною компіляцією CX/CZ.
- Мультибазисні спостережувані: QESEM підтримує вхідні спостережувані, складені з багатьох некомутуючих рядків Паулі, як-от загальні гамільтоніани. Вибір базисів вимірювання та оптимізація розподілу ресурсів QPU (вибірки та схеми) тоді виконуються автоматично QESEM для мінімізації необхідного часу QPU для запитаної точності. Ця оптимізація, що враховує надійність обладнання та частоти виконання, дає змогу запускати глибші схеми та отримувати вищу точність.
Бенчмарки
QESEM було протестовано на широкому спектрі випадків використання та застосувань. Наступні приклади допоможуть тобі оцінити, які типи робочих навантажень можна запускати за допомогою QESEM.
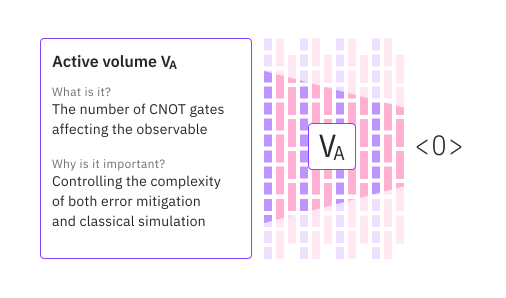
Ключовим показником якості для кількісної оцінки складності як пом'якшення помилок, так і класичної симуляції для заданої схеми та спостережуваної величини є активний об'єм: кількість вентилів CNOT, що впливають на спостережувану величину в схемі. Активний об'єм залежить від глибини та ширини схеми, від ваги спостережуваної величини та від структури схеми, яка визначає світловий конус спостережуваної величини. Докладніше дивись у доповіді на IBM Quantum Summit 2024. QESEM забезпечує особливо велику цінність у режимі великого об'єму, даючи надійні результати для загальних схем і спостережуваних величин.
| Застосування | Кількість кубітів | Пристрій | Опис схеми | Точність | Загальний час | Використання Runtime |
|---|---|---|---|---|---|---|
| Схема VQE | 8 | Eagle (r3) | 21 загальний шар, 9 базисів вимірювання, 1D ланцюжок | 98% | 35 хв | 14 хв |
| Kicked Ising | 28 | Eagle (r3) | 3 унікальні шари × 3 кроки, 2D топологія heavy-hex | 97% | 22 хв | 4 хв |
| Kicked Ising | 28 | Eagle (r3) | 3 унікальні шари × 8 кроків, 2D топологія heavy-hex | 97% | 116 хв | 23 хв |
| Троттеризована симуляція гамільтоніана | 40 | Eagle (r3) | 2 унікальні шари × 10 кроків Троттера, 1D ланцюжок | 97% | 3 год | 25 хв |
| Троттеризована симуляція гамільтоніана | 119 | Eagle (r3) | 3 унікальні шари × 9 кроків Троттера, 2D топологія heavy-hex | 95% | 6,5 год | 45 хв |
| Kicked Ising | 136 | Heron (r2) | 3 унікальні шари × 15 кроків, 2D топологія heavy-hex | 99% | 52 хв | 9 хв |
Точність тут вимірюється відносно ідеального значення спостережуваної величини: , де '' — абсолютна точність пом'якшення (задається вхідними даними користувача), а — спостережувана на ідеальній схемі. «Використання Runtime» вимірює використання бенчмарку в batch mode (сума використання окремих завдань), тоді як «загальний час» вимірює використання в session mode (астрономічний час експерименту), який включає додатковий класичний час та час зв'язку. QESEM доступний для виконання в обох режимах, щоб користувачі могли найкраще використовувати свої доступні ресурси.
Схеми Kicked Ising на 28 кубітів симулюють Дискретний часовий квазікристал, вивчений Shinjо та ін. (дивись arXiv 2403.16718 і Q2B24 Tokyo) на трьох з'єднаних петлях ibm_kawasaki. Параметри схеми, взяті тут: , з феромагнітним початковим станом . Вимірювана спостережувана величина — абсолютне значення намагніченості . Експеримент Kicked Ising у масштабі корисності було проведено на 136 найкращих кубітах ibm_fez; цей конкретний бенчмарк виконувався при кліффордовому куті , при якому активний об'єм повільно зростає з глибиною схеми, що — разом із високою достовірністю (fidelity) операцій пристрою — забезпечує високу точність при короткому часі виконання.
Схеми троттеризованої симуляції гамільтоніана призначені для моделі Ізінга в поперечному полі при дробових кутах: та відповідно (дивись Q2B24 Tokyo). Схему у масштабі корисності було запущено на 119 найкращих кубітах ibm_brisbane, тоді як експеримент на 40 кубітів виконувався на найкращому доступному ланцюжку. Точність повідомляється для намагніченості; високоточні результати отримано також для спостережуваних величин більшої ваги.
Схема VQE була розроблена спільно з дослідниками Центру технологій та застосувань квантових обчислень Deutsches Elektronen-Synchrotron (DESY). Цільовою спостережуваною величиною тут був гамільтоніан, що складається з великої кількості некомутуючих рядків Паулі, що підкреслює оптимізовану продуктивність QESEM для мультибазисних спостережуваних. Пом'якшення було застосовано до класично оптимізованого ансатцу; хоча ці результати ще не опубліковані, результати такої ж якості будуть отримані для різних схем із подібними структурними властивостями.
Початок роботи
Авторизуйся за допомогою свого ключа API IBM Quantum Platform та вибери функцію Qiskit QESEM так. (Цей фрагмент коду припускає, що ти вже зберіг свій обліковий запис у локальному середовищі.)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"qiskit": "qiskit", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import qiskit
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# verify that you have access to the function
catalog.list()
# load the function
qesem_function = catalog.load("qedma/qesem")
Приклади
Приклад завдання оцінки часу
Завдання оцінки часу корисне для оцінки часу QPU, необхідного для заданого pub та backend_name. backend_name також можна встановити на будь-який симуляторний бекенд, наприклад fake_fez.
QESEM використовує квазіймовірнісний метод EM на основі характеризації. Цей метод має накладні витрати часу QPU, які приблизно масштабуються як:
Де — активний об'єм схеми, — цільова точність, а — неточність (1 − точність) нативних вентилів.
Зауваж, що "estimate_time_only": "empirical" використовує кілька хвилин часу QPU, щоб оцінити час, необхідний для завдання (якщо бекенд — реальний пристрій; якщо це симулятор, час QPU не використовується). Зазвичай це займає близько 5 хвилин, але не більше 10 хвилин. Якщо неточність різко змінюється між емпіричним завданням оцінки часу та завданням пом'якшення, час QPU також зміниться різко.
Щоб розпочати, спробуй цей базовий приклад оцінювання необхідного часу QPU для запуску QESEM для заданого pub:
# This cell is hidden from users
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend_name = service.least_busy().name
backend_name = "fake_fez"

circ = qiskit.QuantumCircuit(5)
circ.cx(0, 1)
circ.cx(2, 3)
circ.cx(1, 2)
circ.cx(3, 4)

avg_magnetization = qiskit.quantum_info.SparsePauliOp.from_sparse_list(
    [("Z", [q], 1 / 5) for q in range(5)], num_qubits=5
)
other_observable = qiskit.quantum_info.SparsePauliOp.from_sparse_list(
    [("ZZ", [0, 1], 1.0), ("XZ", [1, 4], 0.5)], num_qubits=5
)

time_estimation_job = qesem_function.run(
    pubs=[(circ, [avg_magnetization, other_observable])],
    options={
        "estimate_time_only": "empirical",
    },
    backend_name=backend_name,  # example: "fake_fez", "ibm_fez"
)
time_estimate_result = (
    time_estimation_job.result()
)  # a list of results per pub (circuit)
Наступний фрагмент коду описує, як отримати різні метрики виконання із завдання оцінки часу (коли estimate_time_only встановлено):
pub_result = time_estimate_result[0]

print(
    f"The estimated QPU time for mitigation for this PUB is: {pub_result.metadata['time_estimation_sec']}"
)
print(
    f"The QPU time that this time estimation job took is (here it is 0 because we used fake_fez): {pub_result.metadata['total_qpu_time']}"
)
print(
    f"Gates fidelity measured during the experiment: {pub_result.metadata['gate_fidelities']}"
)
print(f"Total shots: {pub_result.metadata['total_shots']}")
print(f"Resource usage breakdown: {pub_result.metadata['resource_usage']}")
The estimated QPU time for mitigation for this PUB is: 300
The QPU time that this time estimation job took is (here it is 0 because we used fake_fez): 0
Gates fidelity measured during the experiment: {'CZ': 0.9951354916722668, 'ID1Q': 0.9991246627329172}
Total shots: 220000
Resource usage breakdown: {'RUNNING: MAPPING': {'CPU_TIME': 33.6066133165732, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 184.53575124032795, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: EXECUTING_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}}
Коли ввімкнено емпіричну оцінку часу, QESEM запускає невелику кількість circuits, щоб надати точнішу оцінку часу QPU. Результати мітигації з цих circuits доступні в полі empirical_estimation_mitigation_results завдання.
Оскільки ці результати отримані з обмеженої вибірки circuits, вони значно менш точні, ніж остаточні результати, отримані з повного завдання мітигації QESEM. Однак коли circuit невеликий або цільова точність низька, мітигація, виконана під час емпіричної оцінки часу, може виявитися достатньою для досягнення бажаної точності, і повне завдання мітигації може не знадобитися.
Поле empirical_estimation_mitigation_results — це список об'єктів PrimitiveResult для кожного вхідного параметра. Якщо circuit не параметризований, список матиме довжину 1.
empirical_estimation_mitigation_results = time_estimate_result[0].metadata[
    "empirical_estimation_mitigation_results"
][0]  # a list per parameter
print("Partial results for the observables:")

print(
    f"    Mitigated expectation values: {empirical_estimation_mitigation_results.data.evs}"
)
print(
    f"    Mitigated error bars: {empirical_estimation_mitigation_results.data.stds}"
)
print(
    f"    Number of shots used for mitigation: {empirical_estimation_mitigation_results.metadata['mitigation_shots']}"
)
transpiled_circ = empirical_estimation_mitigation_results.metadata[
    "transpiled_circ"
]
print(f"    Qubit mapping: {transpiled_circ['qubit_maps']}")
print(
    f"    Number of measurement bases: {transpiled_circ['num_measurement_bases']}\n"
)

# results per obs
emp_obs_results = empirical_estimation_mitigation_results.metadata["results"][
    0
]
# print(f"Results for each observable: {results}")
print("Results for each observable:")

for i, (obs_array, result_dict) in enumerate(emp_obs_results):
    # obs_array, result_dict = results
    print(f"Observable {i+1}: {obs_array}")
    print(
        f"    QESEM mitigated value: {result_dict['qesem']['value']} \u00b1 {result_dict['qesem']['error_bar']}"
    )
Partial results for the observables:
    Mitigated expectation values: [1.00347302 1.00693905]
    Mitigated error bars: [0.00304061 0.00714276]
    Number of shots used for mitigation: 180000
    Qubit mapping: [[[0, 136], [1, 143], [2, 142], [3, 141], [4, 140]]]
    Number of measurement bases: 2

Results for each observable:
Observable 1: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
    QESEM mitigated value: 1.003473015776871 ± 0.0030406128032204015
Observable 2: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
    QESEM mitigated value: 1.0069390542613554 ± 0.0071427606736885925
Приклад завдання мітигації QESEM
Наступний приклад виконує завдання QESEM:
sample_job = qesem_function.run(
    pubs=[(circ, [avg_magnetization, other_observable])],
    backend_name=backend_name,  # example: "ibm_fez"
    # options = {
    #     "estimate_time_only": "empirical",
    #     "default_precision": 0.2,  # Default precision is applied to all pubs that don't have a precision specified, see API reference for more details
    #     "max_execution_time": 3600,  # You can specify a maximum QPU time in seconds, see API reference for more details
    #     "transpilation_level": "standard",  # "minimal_with_layout_opt" for minimal transpilation, see API reference for more details
    #     "parallel_execution": True,  # True for parallel execution, see API reference for more details
    # },
)
Детальний опис кожного вхідного поля та опції дивись у довіднику API QESEM. Ти можеш використовувати знайомі API Qiskit Serverless для перевірки статусу робочого навантаження функції Qiskit або отримання результатів:
# Print the ID so you can use it later, if necessary
print(sample_job.job_id)
print(sample_job.status())
sample_result = sample_job.result()
3ac6b2df-15b0-4dc0-8f48-cf14bd20a1c8
DONE
Наступний фрагмент коду демонструє, як отримати результати пом'якшення та метрики виконання. Вони містять важливі дані, що дають змогу глибше зрозуміти, як різні параметри впливають на виконання QESEM. Це також може бути корисним при написанні статті на основі твоїх досліджень.
for pub_idx, pub_result in enumerate(
    sample_result
):  # each element in the list is a result for a different pub, here we sent only one pub
    print(f"\nPUB {pub_idx}:")
    print(
        f"  The QPU time that this job took is (here it is 0 because we used fake_fez): {pub_result.metadata['total_qpu_time']}"
    )
    print(
        f"  Gates fidelity measured during the experiment: {pub_result.metadata['gate_fidelities']}"
    )
    print(f"  Total shots: {pub_result.metadata['total_shots']}")
    print(
        f"  Number of shots used for mitigation: {pub_result.metadata['mitigation_shots']}"
    )
    print(
        f"  Resource usage breakdown: {pub_result.metadata['resource_usage']}"
    )
PUB 0:
  The QPU time that this job took is (here it is 0 because we used fake_fez): 0.0
  Gates fidelity measured during the experiment: {'CZ': 0.9953704216147041, 'ID1Q': 0.9991834123567518}
  Total shots: 446000
  Number of shots used for mitigation: 194000
  Resource usage breakdown: {'RUNNING: MAPPING': {'CPU_TIME': 32.52745003718883, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 257.850521848537, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: EXECUTING_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}}
У metadata["results"] результати групуються спочатку за екземпляром circuit, а потім за спостережуваною величиною.
print("Full QESEM mitigation results:")

for pub_idx, pub_result in enumerate(sample_result):
    print(f"\nPUB {pub_idx}:")

    print(f"  Mitigated expectation values: {pub_result.data.evs}")
    print(f"  Mitigated error bars: {pub_result.data.stds}")
    noisy_results = pub_result.metadata.get("noisy_results")
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")

    print("  Transpiled circuits:")
    for circ_idx, transpiled_circ in enumerate(
        pub_result.metadata["transpiled_circs"]
    ):
        print(f"    Circuit {circ_idx}:")
        # print(f"      Circuit: \n {transpiled_circ['circuit']}") # not printing it because it's long but you can see the transpiled circuit itself
        print(f"      Qubit mapping: {transpiled_circ['qubit_maps']}")
        print(
            f"      Measurement bases: {transpiled_circ['num_measurement_bases']}"
        )

    print("  Results for each observable:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"    Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            print(
                f"        QESEM mitigated value: {result_dict['qesem']['value']} ± {result_dict['qesem']['error_bar']}"
            )
            print(
                f"        Unmitigated value: {result_dict['unmitigated']['value']} ± {result_dict['unmitigated']['error_bar']}"
            )
Full QESEM mitigation results:

PUB 0:
  Mitigated expectation values: [1.00648343 1.00636289]
  Mitigated error bars: [0.00253812 0.00693586]
  Unmitigated expectation values: [0.98031429 0.96357143]
  Unmitigated error bars: [0.00124128 0.00578812]
  Transpiled circuits:
    Circuit 0:
      Qubit mapping: [[[0, 140], [1, 141], [2, 142], [3, 143], [4, 136]]]
      Measurement bases: 2
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 1.0064834305181962 ± 0.002538119914534849
        Unmitigated value: 0.9803142857142859 ± 0.0012412835813609938
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 1.0063628870614818 ± 0.006935859820870656
        Unmitigated value: 0.9635714285714285 ± 0.005788121870526659
Розбір основних результатів:
mitigated: повністю пом'якшене очікуване значення QESEM.unmitigated: сирий результат з фізичним шумом без пом'якшення помилок.
Результати евристичної екстраполяції QESEM
У стандартному запуску QESEM з одним значенням precision типу float результати також включають автоматично доступні точки масштабування шуму, які використовуються для евристики QESEM. Ці точки обчислюються без додаткових ресурсів QPU.
Масштаб 1.0 відображає рівень шуму фізичного пристрою з мітигацією зчитування (REM), тоді як масштаб 2.0 — це доповняльна точка з підсиленим шумом, також з REM. Ці точки використовуються для отримання результату qesem_heuristic.
-
qesem_heuristic: оцінка у стилі ZNE, обчислена з доступних даних масштабування шуму. Наразі використовується експоненційна екстраполяція. -
noise_scaling.results_with_REM: очікувані значення при різних масштабах шуму, усі з пом'якшенням зчитування (REM).
Тонка, але важлива деталь полягає в тому, що результат масштабу 1.0 не є тим самим, що й результат unmitigated. Обидва відповідають рівню шуму фізичного пристрою, але точка масштабу 1.0 включає мітигацію зчитування, тоді як unmitigated — ні.
print("QESEM heuristic results:")

for pub_idx, pub_result in enumerate(sample_result):
    print(f"\nPUB {pub_idx}:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"  Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"    Observable {obs_idx}: {obs_array}")
            qesem_heuristic = result_dict["qesem_heuristic"][0]
            print("      QESEM heuristic:")
            print(
                f"        Value: {qesem_heuristic['value']} ± {qesem_heuristic['error_bar']}"
            )
            print(
                f"        Extrapolation: {qesem_heuristic['extrapolation']}"
            )
            print(
                f"        Scale factors: {qesem_heuristic['scale_factors']}"
            )
            noise_scaling = result_dict["noise_scaling"]
            print("      Noise scaling results:")
            print(
                f"        Scaling method: {noise_scaling['scaling_method']}"
            )
            print("        Results with Readout mitigation (REM):")
            for rem_result in sorted(
                (
                    item
                    for item in noise_scaling["results_with_REM"]
                    if item["scale"] != 0.0
                ),
                key=lambda item: item["scale"],
            ):
                print(
                    f"          Scale factor {rem_result['scale']}: {rem_result['value']} ± {rem_result['error_bar']}"
                )
QESEM heuristic results:

PUB 0:
  Circuit 0:
    Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
      QESEM heuristic:
        Value: 1.0008161638888535 ± 0.0038859458884403964
        Extrapolation: exponential
        Scale factors: [1.0, 2.0]
      Noise scaling results:
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 1.0: 0.9918395459270772 ± 0.0012565417579355634
          Scale factor 2.0: 0.982943441922748 ± 0.0028919278067695018
    Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
      QESEM heuristic:
        Value: 0.9960853148925298 ± 0.013811635038961175
        Extrapolation: exponential
        Scale factors: [1.0, 2.0]
      Noise scaling results:
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 1.0: 0.9902860583785115 ± 0.005921236914723409
          Scale factor 2.0: 0.984520565414274 ± 0.006909522262347639
Наступні приклади зосереджені на вхідних даних та результатах, специфічних для функцій, тому вони не виводять повні метрики виконання щоразу. Метадані верхнього рівня, показані раніше, такі як total_qpu_time, gate_fidelities, total_shots, mitigation_shots та resource_usage, доступні і для цих завдань.
Деякі змінні з попередніх прикладів, включно з бекендом, спостережуваними величинами та параметрами базового circuit, повторно використовуються нижче для стислості.
Усі наступні приклади також можна запустити з емпіричною оцінкою часу. Щоб увімкнути це, передай "estimate_time_only": "empirical" в опціях функції.
Приклад параметризованого circuit
Багато алгоритмів обчислюють один і той самий circuit при кількох значеннях параметрів. Надсилання параметризованого circuit як одного завдання QESEM дозволяє QESEM спільно використовувати характеризацію та калібрування між екземплярами circuit, що може зменшити накладні витрати часу QPU порівняно з виконанням окремих завдань.
Подання параметризованої схеми вимагає використання рівня транспіляції "minimal_with_layout_opt".
Схеми, подані на цьому рівні, мають бути вже виражені за допомогою базових вентилів бекенду, залежно від бекенду. На цьому рівні QESEM зберігає подану структуру максимально близькою до вхідної схеми, враховує бар'єри під час шарування (групування операцій у шари паралельних двокубітних вентилів) і все ще автоматично обробляє апаратне відображення на високоточні кубіти та зв'язність пристрою.
На практиці це означає, що тобі слід транспілювати circuits до базових gates цільового бекенду перед поданням. Простий приклад транспіляції базових gates показано нижче.
QESEM наразі підтримує лише одну спостережувану величину на набір параметрів. Два рядки параметрів нижче об'єднані (zipped) з двома спостережуваними величинами: перший рядок вимірюється за допомогою avg_magnetization, а другий — за допомогою other_observable.
# Transpile to the backend basis gates only. With minimal_with_layout_opt, QESEM handles hardware mapping/connectivity and observable layout internally.
from qiskit_ibm_runtime.fake_provider import FakeFez

backend = FakeFez()
basis = backend.operation_names
print(basis)

param0 = qiskit.circuit.Parameter("param0")
param1 = qiskit.circuit.Parameter("param1")
parametrized_circ = qiskit.QuantumCircuit(5)
parametrized_circ.rx(param0, 0)
parametrized_circ.rx(param1, 1)
parametrized_circ.cx(0, 1)
parametrized_circ.cx(2, 3)
parametrized_circ.cx(1, 2)
parametrized_circ.cx(3, 4)

parametrized_circ = qiskit.transpile(
    parametrized_circ, basis_gates=basis, optimization_level=1
)
parametrized_parameter_values = [[0.5, 0.1], [0.0, 0.6]]
parametrized_observables = [avg_magnetization, other_observable]

parametrized_job = qesem_function.run(
    pubs=[
        (
            parametrized_circ,
            parametrized_observables,
            parametrized_parameter_values,
            0.1,
        )
    ],
    backend_name=backend_name,
    options={
        "max_execution_time": 300,
        "transpilation_level": "minimal_with_layout_opt",
    },
)
print(parametrized_job.job_id)
print(parametrized_job.status())
d1b0e29b-196c-4896-aec6-44a268ebd874
DONE
parametrized_result = parametrized_job.result()
print("Parameterized circuit QESEM results:")

for pub_idx, pub_result in enumerate(parametrized_result):
    print(f"\nPUB {pub_idx}:")
    print(f"  Mitigated expectation values: {pub_result.data.evs}")
    print(f"  Mitigated error bars: {pub_result.data.stds}")
    noisy_results = pub_result.metadata["noisy_results"]
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")
    print("  Results for each parameter value:")
    for param_idx, param_results in enumerate(pub_result.metadata["results"]):
        print(
            f"    Parameter set {param_idx}: {parametrized_parameter_values[param_idx]}"
        )
        for obs_idx, (obs_array, result_dict) in enumerate(param_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            print(
                f"        QESEM mitigated value: {result_dict['qesem']['value']} ± {result_dict['qesem']['error_bar']}"
            )
            print(
                f"        Unmitigated value: {result_dict['unmitigated']['value']} ± {result_dict['unmitigated']['error_bar']}"
            )
Parameterized circuit QESEM results:

PUB 0:
  Mitigated expectation values: [0.92392021 0.82517653]
  Mitigated error bars: [0.00565281 0.00616016]
  Unmitigated expectation values: [0.9028     0.78771429]
  Unmitigated error bars: [0.00335142 0.00925413]
  Results for each parameter value:
    Parameter set 0: [0.5, 0.1]
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 0.923920210615709 ± 0.005652811570890183
        Unmitigated value: 0.9028 ± 0.0033514176105045447
    Parameter set 1: [0.0, 0.6]
      Observable 0: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 0.8251765289285893 ± 0.006160161743353999
        Unmitigated value: 0.7877142857142858 ± 0.009254130564027902
Приклад multi-pub
Виконання multi-pub корисне, коли ти хочеш запустити кілька пов'язаних circuits в одному завданні QESEM. Як і параметризоване виконання, це може зменшити накладні витрати, оскільки QESEM може спільно використовувати характеризацію та калібрування між екземплярами circuit, замість того щоб повторювати це в окремих завданнях.
Це особливо корисно для circuits зі спільною структурою шарів, таких як робочі навантаження типу Trotter, де різні circuits повторно використовують ті самі унікальні шари. У такому випадку спільне виконання може зменшити витрати на характеризацію порівняно з незалежними завданнями QESEM.
Завдання multi-pub вимагають "transpilation_level": "minimal_with_layout_opt". Як і в прикладі з параметризацією, circuits слід транспілювати до базових gates цільового бекенду перед поданням. Потім QESEM внутрішньо обробляє зв'язність пристрою, розташування та відображення на високоточні кубіти.
Кожен PUB нижче містить один circuit і ті самі дві спостережувані величини, використані раніше в ноутбуці, тож повернутий PrimitiveResult містить один PubResult на кожен вхідний circuit.
У прикладі нижче використовуються два прості circuits Trotter з однаковим шаблоном шарів: circ_a має один шар Trotter, а circ_b повторює той самий шаблон шару двічі. Це робить спільну структуру явною.
def make_trotter_circuit(num_qubits, num_layers, zz_angle=0.2, x_angle=0.1):
    trotter_circ = qiskit.QuantumCircuit(num_qubits)
    for _ in range(num_layers):
        for q in range(num_qubits):
            trotter_circ.rx(x_angle, q)
        trotter_circ.barrier()
        for q in range(0, num_qubits - 1, 2):
            trotter_circ.rzz(zz_angle, q, q + 1)
        trotter_circ.barrier()
        for q in range(1, num_qubits - 1, 2):
            trotter_circ.rzz(zz_angle, q, q + 1)
        trotter_circ.barrier()
    return trotter_circ

circ_a = make_trotter_circuit(num_qubits=5, num_layers=1)
circ_b = make_trotter_circuit(num_qubits=5, num_layers=2)
multi_pubs = [
    (
        qiskit.transpile(qci, basis_gates=basis, optimization_level=1),
        [avg_magnetization, other_observable],
    )
    for qci in [circ_a, circ_b]
]

multi_circ_job = qesem_function.run(
    pubs=multi_pubs,
    backend_name=backend_name,
    options={
        "max_execution_time": 300,
        "transpilation_level": "minimal_with_layout_opt",
        "default_precision": 0.1,
    },
)
print(multi_circ_job.job_id)
print(multi_circ_job.status())
e34565b8-7262-4133-a120-de42ce624a99
DONE
multi_circ_result = multi_circ_job.result()
print("Multi-pub QESEM results:")

for pub_idx, pub_result in enumerate(multi_circ_result):
    print(f"\nPUB {pub_idx}:")
    print(f"  Mitigated expectation values: {pub_result.data.evs}")
    print(f"  Mitigated error bars: {pub_result.data.stds}")
    noisy_results = pub_result.metadata["noisy_results"]
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")
    print("  Results for each observable:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"    Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            print(
                f"        QESEM mitigated value: {result_dict['qesem']['value']} ± {result_dict['qesem']['error_bar']}"
            )
            print(
                f"        Unmitigated value: {result_dict['unmitigated']['value']} ± {result_dict['unmitigated']['error_bar']}"
            )
Multi-pub QESEM results:

PUB 0:
  Mitigated expectation values: [0.99502406 1.02209332]
  Mitigated error bars: [0.00483819 0.00707488]
  Unmitigated expectation values: [0.96934286 0.97271429]
  Unmitigated error bars: [0.00124855 0.00617294]
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 0.9950240647925642 ± 0.004838188086259301
        Unmitigated value: 0.9693428571428573 ± 0.0012485470362492692
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 1.0220933230604674 ± 0.007074884384355636
        Unmitigated value: 0.9727142857142859 ± 0.006172939375512439

PUB 1:
  Mitigated expectation values: [0.98850017 1.02555188]
  Mitigated error bars: [0.0077912  0.01672652]
  Unmitigated expectation values: [0.93682857 0.95371429]
  Unmitigated error bars: [0.00156245 0.00665735]
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 0.988500171577252 ± 0.007791203181151346
        Unmitigated value: 0.9368285714285716 ± 0.001562451883089579
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 1.02555188098689 ± 0.016726524388086233
        Unmitigated value: 0.9537142857142858 ± 0.006657345655544263
Приклад квазіймовірнісного налаштування помилок (QET)
Квазіймовірнісне налаштування помилок (QET) запитує очікувані значення при вибраних коефіцієнтах масштабування шуму. Це корисно для власних досліджень масштабування шуму та робочих процесів екстраполяції нульового шуму (Zero-Noise Extrapolation). Масштаб 1.0 — це фізичний рівень шуму, значення між 0.0 та 1.0 частково зменшують шум, а значення вище 1.0 посилюють шум.
Щоб використовувати QET з функцією Qiskit, передай словник як точність PUB. Словник зіставляє кожен запитаний масштаб шуму з його цільовою точністю. Повернуті результати масштабних коефіцієнтів зберігаються в noise_scaling.results_with_REM і включають пом'якшення зчитування. Тому точка масштабу 1.0 не ідентична непом'якшеному значенню, оскільки 1.0 включає пом'якшення зчитування, а unmitigated — ні.
Коли запитується масштаб, QESEM також повертає доповняльний масштаб навколо 1.0 без додаткового використання QPU. Наприклад, запит 0.5 також може повернути 1.5, а запит 1.3 може повернути 0.7. Точність доповняльного масштабу не гарантована.
noise_scale_precision = {0.5: 0.15, 1.3: 0.2}

qet_job = qesem_function.run(
    pubs=[
        (
            circ,
            [avg_magnetization, other_observable],
            None,
            noise_scale_precision,
        )
    ],
    backend_name=backend_name,
    options={"max_execution_time": 300},
)
print(qet_job.job_id)
print(qet_job.status())
8195fa58-f037-4651-8715-36ce1cdc5521
DONE
qet_result = qet_job.result()
print("QET noise-scaling results:")

for pub_idx, pub_result in enumerate(qet_result):
    print(f"\nPUB {pub_idx}:")
    noisy_results = pub_result.metadata["noisy_results"]
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")
    print("  Results for each observable:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"    Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            noise_scaling = result_dict["noise_scaling"]
            print(
                f"        Scaling method: {noise_scaling['scaling_method']}"
            )
            print("        Results with Readout mitigation (REM):")
            for rem_result in sorted(
                (
                    item
                    for item in noise_scaling["results_with_REM"]
                    if item["scale"] != 0.0
                ),
                key=lambda item: item["scale"],
            ):
                print(
                    f"          Scale factor {rem_result['scale']}: {rem_result['value']} ± {rem_result['error_bar']}"
                )
QET noise-scaling results:

PUB 0:
  Unmitigated expectation values: [0.97822857 0.96171429]
  Unmitigated error bars: [0.00123812 0.00672958]
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 0.5: 0.9938730340199383 ± 0.0032116907357568275
          Scale factor 0.7: 0.9963976191853445 ± 0.00036300258869586616
          Scale factor 1.0: 0.9898115079506586 ± 0.0012525947426560995
          Scale factor 1.3: 0.9864667065580341 ± 0.002633221613518526
          Scale factor 1.5: 0.9838755527197551 ± 0.002948417797996015
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 0.5: 1.0006538544450332 ± 0.002121742014777343
          Scale factor 0.7: 1.0004159801523036 ± 0.0021671375357823794
          Scale factor 1.0: 0.9898058846339917 ± 0.00690183710903159
          Scale factor 1.3: 0.9948946719997267 ± 0.002146532859610311
          Scale factor 1.5: 0.9927220368192772 ± 0.0020875057190323882
Отримання повідомлень про помилки
Якщо статус твого робочого навантаження — ERROR, використай job.result(), щоб отримати повідомлення про помилку таким чином:
# Get the result and truncate for readability
result = sample_job.result()
result_str = str(result)
max_length = 500  # Adjust this value as necessary

if len(result_str) > max_length:
    truncated = (
        result_str[:max_length]
        + f"... (truncated {len(result_str) - max_length} characters)"
    )
else:
    truncated = result_str

print(truncated)
PrimitiveResult([PubResult(data=DataBin(evs=np.ndarray(<shape=(2,), dtype=float64>), stds=np.ndarray(<shape=(2,), dtype=float64>), shape=(2,)), metadata={'gate_fidelities': {'CZ': 0.9979444718552628, 'ID1Q': 0.9991994239814883}, 'total_shots': 498600, 'mitigation_shots': 223400, 'transpiled_circs': [{'circuit': 'OPENQASM 3.0;\ninclude "stdgates.inc";\nbit[76] c0;\nqubit[76] q0;\nrx(0) q0[54];\nrx(0) q0[59];\nrx(0) q0[75];\nrz(pi/2) q0[54];\nrz(pi/2) q0[59];\nrz(pi/2) q0[75];\nrx(pi/2) q0[54];\nr... (truncated 3771 characters)
Отримання підтримки
Команда підтримки Qedma готова допомогти! Якщо ти зіткнувся з будь-якими проблемами або маєш запитання щодо використання функції Qiskit QESEM, не соромся звертатися. Наш досвідчений та доброзичливий персонал підтримки готовий допомогти тобі з будь-якими технічними питаннями чи запитами.
Ти можеш написати нам на support@qedma.com для отримання допомоги. Будь ласка, включи якомога більше деталей про проблему, з якою зіткнувся, щоб допомогти нам надати швидку та точну відповідь. Ти також можеш зв'язатися зі своїм персональним контактним представником Qedma POC електронною поштою або телефоном.
Щоб допомогти нам надати підтримку ефективніше, надай таку інформацію, коли звертаєшся до нас:
-
Детальний опис проблеми
-
Ідентифікатор завдання
-
Будь-які відповідні повідомлення про помилки або коди
Ми прагнемо надавати швидку та ефективну підтримку, щоб забезпечити найкращий можливий досвід роботи з нашою функцією Qiskit.
Ми завжди намагаємося покращити наш продукт і вітаємо твої пропозиції! Якщо у тебе є ідеї щодо того, як ми можемо покращити наші послуги або функції, які ти хотів би побачити, надсилай свої думки на support@qedma.com.
Наступні кроки
-
Відвідай довідник API для цієї функції Qiskit.
-
Спробуй посібник Simulate 2D tilted-field Ising with the QESEM function.
-
Ознайомся з Aharonov, D., et al. (2025). Syndrome aware mitigation of logical errors. arXiv preprint arXiv:2508.10997.