Придушення та формування помилок
Придушення помилок може означати будь-яку методику, яка передбачає та намагається уникнути певних типів шуму й помилок. Найпростіше пояснити це на конкретних прикладах, але варто пам'ятати, що ці методи не обмежуються прикладами, наведеними тут, і постійно досліджуються нові методи. Іноді неможливо придушити помилки, але можна вплинути на те, як вони накопичуються. Якщо ми можемо змусити помилки накопичуватися повільніше, це можна описати як придушення загальної помилки, але точніше це слід розглядати як формування шуму. У цьому уроці ми розглянемо канонічні приклади придушення помилок (динамічне розщеплення) та формування/шейпінгу шуму (твірлінг Паулі).
Відео до цього уроку буде опубліковано протягом наступних кількох днів і буде вбудовано тут.
Динамічне розщеплення
Почнімо з дуже простого стану на одному кубіті та введемо просту модель шуму. Цього недостатньо, щоб повністю пояснити динамічне розщеплення, але це дає нам наочний приклад. Припустімо, у нас є кубіт, підготовлений у стані суперпозиції за допомогою вентиля Адамара:
Цей стан візуалізовано на сфері Блоха, як показано нижче зліва. В ідеальному випадку за відсутності шуму цей кубіт залишався б у цьому стані до виконання наступної операції. Однак з попереднього уроку ми знаємо, що це не те, що ми спостерігаємо. Шум спричиняє деградацію квантової інформації.
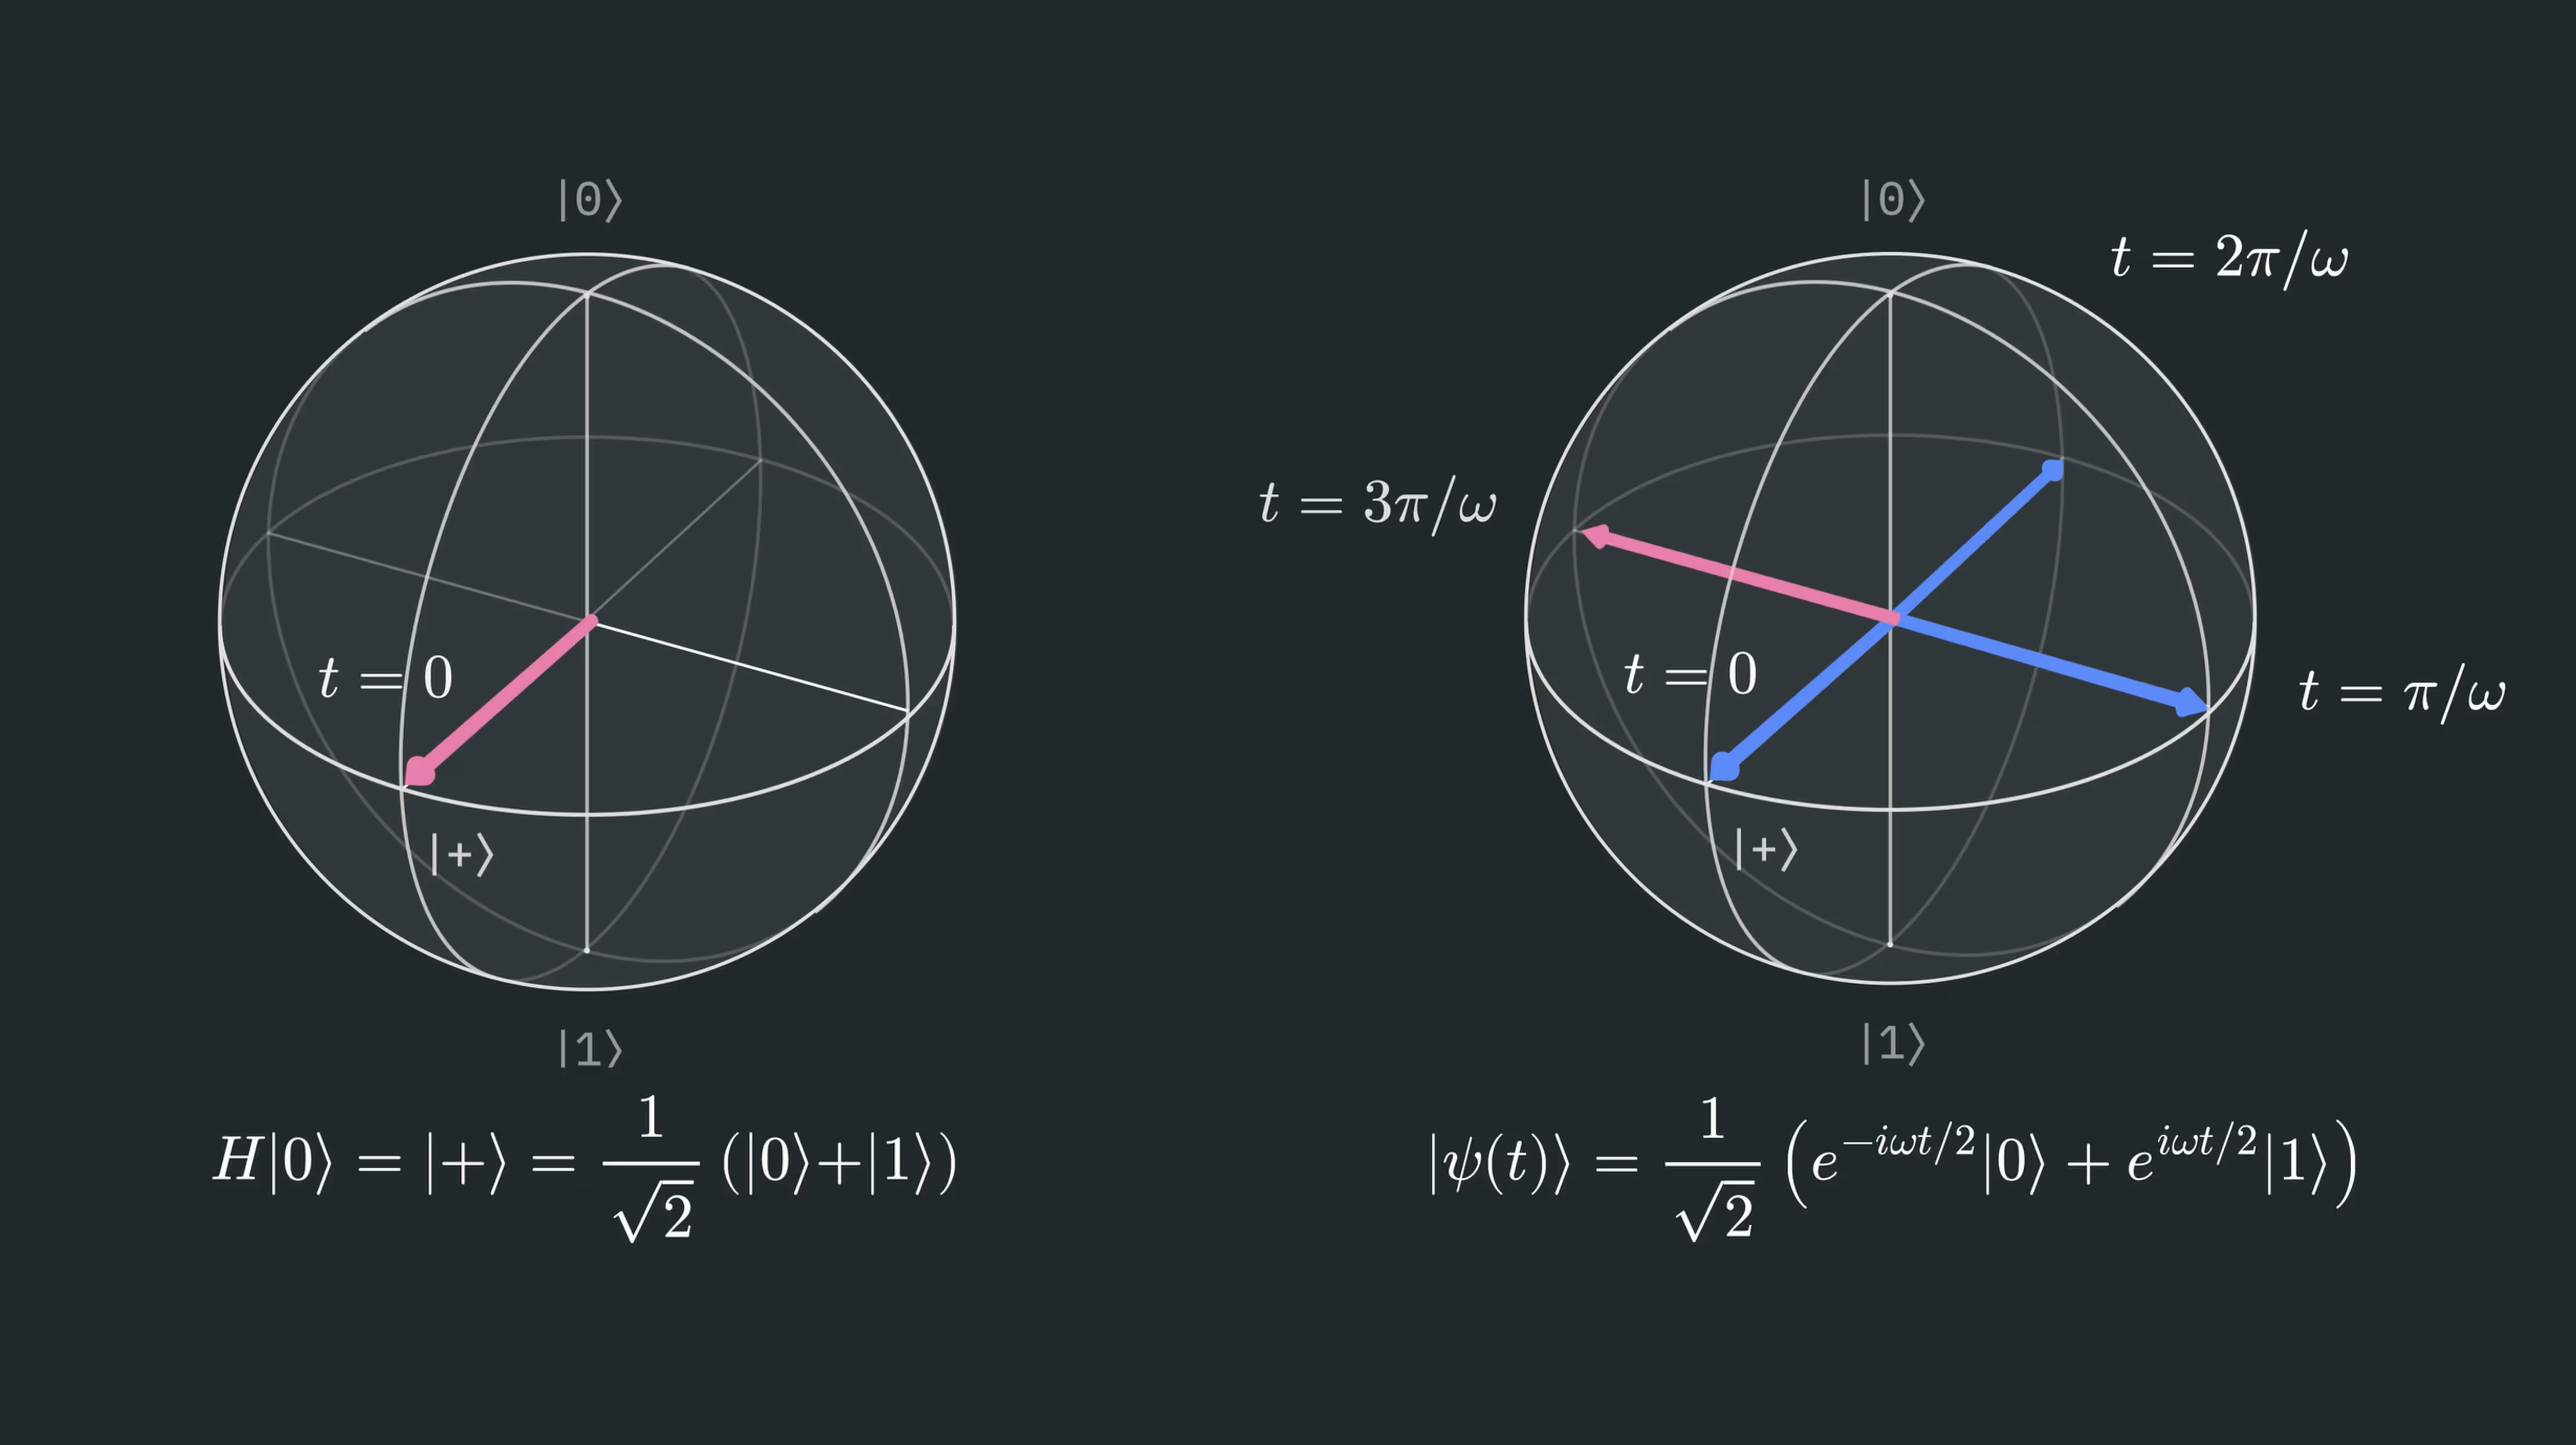
Шум або взаємодія з навколишнім середовищем можуть спричинити зміну відносної фази між базисними станами. Тобто ймовірності та не змінюються, оскільки абсолютні значення їхніх коефіцієнтів не змінюються. Натомість змінюються фази амплітуд, що змінює їхні дійсну та уявну складові. Щоб зробити цю дискусію конкретнішою, розгляньмо один тип взаємодії, який може це спричинити: зв'язок із магнітним полем, орієнтованим у напрямку Z: .
Розгляньмо, що відбувається зі станом з плином часу:
Тут ми скористалися тим фактом, що магнітне поле в напрямку Z спричиняє прецесію навколо осі Z із частотою , яка залежить від ефективного магнітного моменту та напруженості магнітного поля. Деталі менш важливі, ніж той факт, що ця взаємодія спричиняє еволюцію навколо осі Z, що призводить до протилежного накопичення фази для двох обчислювальних базисних станів. Застосовуючи цей оператор до кожного члена в , ми отримуємо наступне:
Ця залежна від часу фаза відповідає прецесії навколо осі Z у картині сфери Блоха. Це показано у правій половині наведеного вище рисунка.
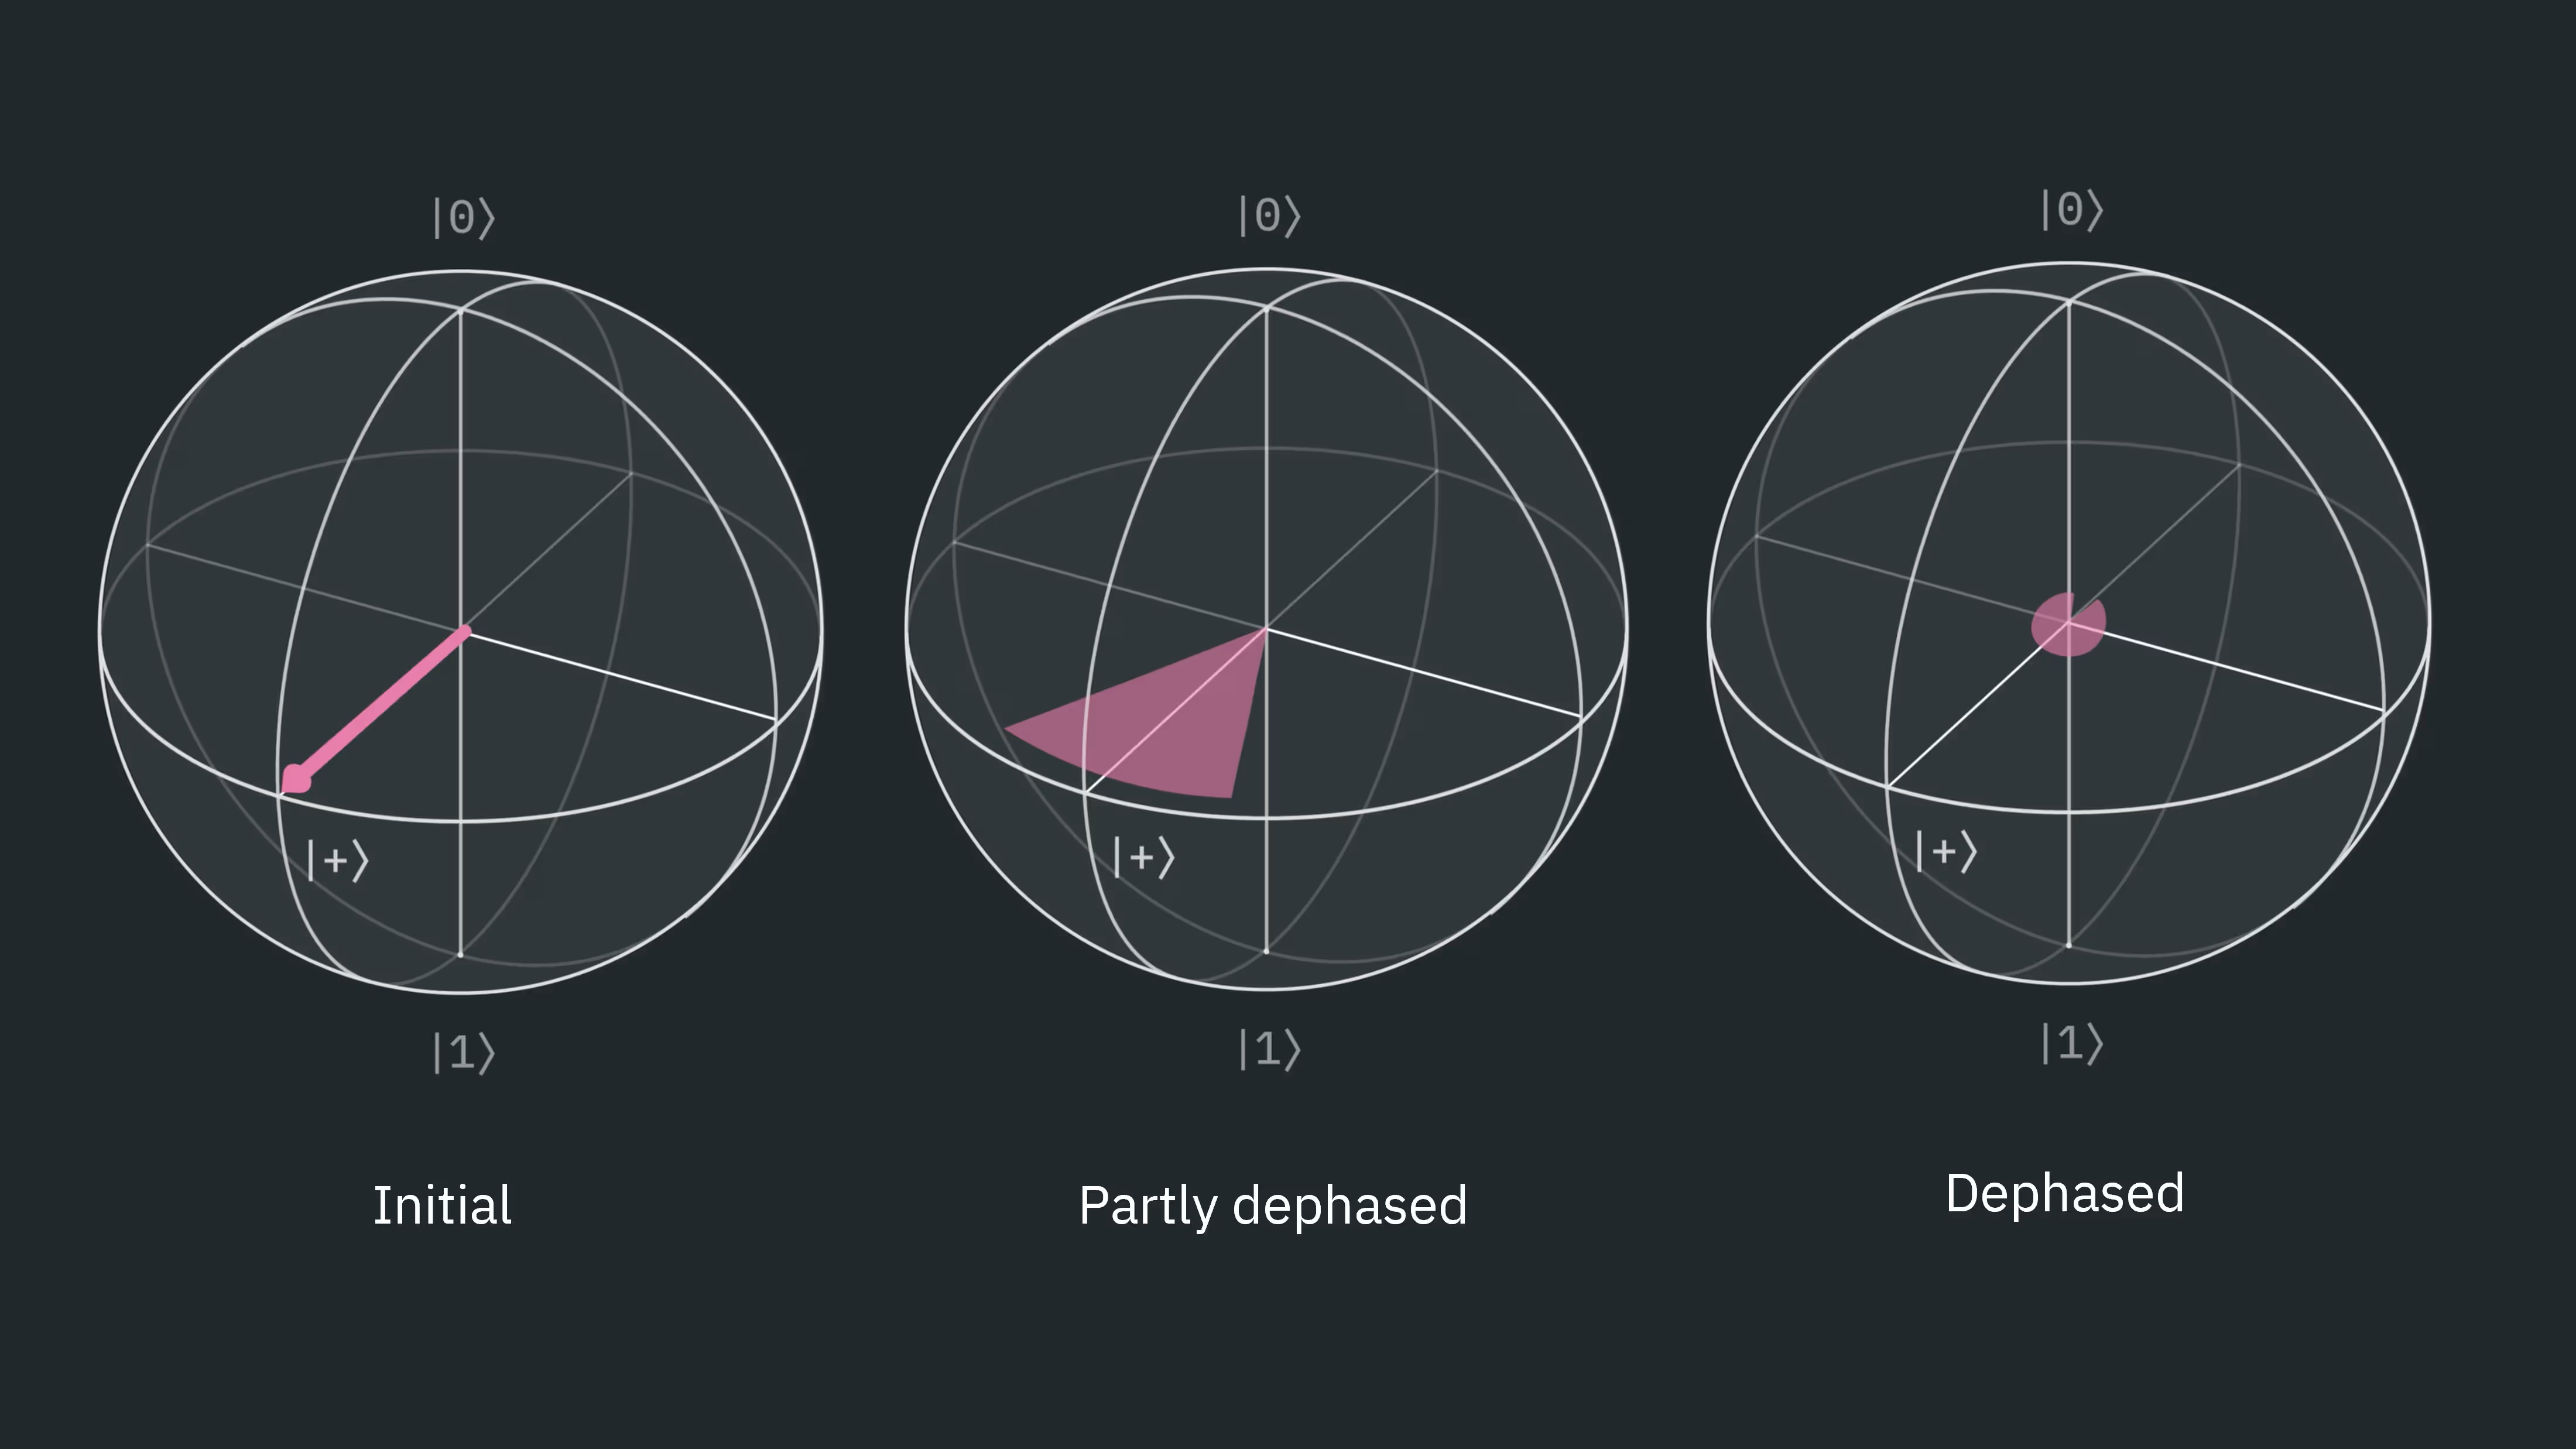
Якби ми знали, що ця взаємодія відбувається контрольовано, ми могли б її передбачити. Щоб змоделювати цей тип шуму, ми натомість розглядаємо розподіл можливих напруженостей магнітного поля, кожна з яких трапляється з певною класичною ймовірністю (інші джерела шуму потрібно було б моделювати інакше). Нам потрібно розглянути, що відбувається, коли існує ненульова класична ймовірність того, що стан взагалі не повернувся, а також певна ймовірність того, що він повернувся на невелику величину або навіть на велику. Цей розподіл можливих поворотів є причиною розмиття стану на наведеній нижче картині сфери Блоха. Якщо такого дефазувального шуму більше, фаза буде менш чітко визначеною. У межі сильної дефазації кубіт стає повністю дефазованим, що відповідає втраті квантової когерентності, збереженої у стані.
Звісно, в експерименті ми не знаємо, який випадковий зв'язок відбудеться. Що ми можемо з цим зробити?
Припустімо, що взаємодія з навколишнім середовищем залишається приблизно сталою протягом часового інтервалу . Розгляньмо, що станеться, якщо ми дотримаємося такого припису:
-
Дозволити фазі змінюватися протягом часу
-
Застосувати вентиль X до кубіта
-
Дозволити тій самій взаємодії з навколишнім середовищем відбуватися протягом ще одного часу
-
Застосувати другий вентиль X
Після початкової часової еволюції ми матимемо саме той стан, що показано вище. Застосовуючи перший вентиль X, отримуємо:
Тепер, коли минає другий інтервал , відбувається та сама взаємодія. Але тепер амплітуди пов'язані з протилежними власними станами Z, тобто знак повороту навколо осі Z змінився. Дозволивши системі еволюціонувати ще протягом , ми отримуємо стан:
І підставляючи , маємо:
Застосування останнього вентиля X у цьому випадку нічого не змінює, але загалом воно необхідне:
Ми відновили початковий квантовий стан, включно з його відносною фазою. Цей процес є особливо простим прикладом динамічного розщеплення.
У ширшому сенсі динамічне розщеплення (ДР) полягає у вставлянні кількох однокубітних вентилів для зменшення впливу взаємодій із системами поза кубітом (розщеплення його з навколишнім середовищем). Повне повернення всіх можливих історій фази до початкового стану, як показано вище, дещо ідеалізоване, але все ж є можливим сценарієм. Обговорімо, коли ДР корисне та які застереження існують.
Перевірте своє розуміння
У тексті вище ми покроково розглянули вплив послідовності ДР XX на початковий стан . Перевірте, чи ті самі кроки, наведені вище, також повертають стан до його початкового стану за тих самих припущень про повільно змінюване магнітне поле вздовж напрямку z.
Відповідь
Після початкової часової еволюції ми матимемо саме той стан, що показано вище. Застосовуючи перший вентиль X, отримуємо:
Тепер, коли минає другий інтервал , відбувається та сама взаємодія. Але тепер амплітуди пов'язані з протилежними власними станами Z, тобто знак повороту навколо осі Z змінився. Дозволивши системі еволюціонувати ще протягом , ми отримуємо стан:
І підставляючи , маємо
Застосовуючи останній вентиль X, маємо:
Коли використовувати ДР
Перше і найочевидніше застереження полягає в тому, що в нашому розгляді ми припускали чисто дефазувальний канал. Реальні взаємодії зазвичай спричиняють суміш дефазації та інших механізмів помилок. У розгляді вище ми обрали застосування саме вентилів X. Це називається послідовністю XX у динамічному розщепленні. Ця конкретна послідовність підходить для чисто дефазувальних помилок. Але існують й інші послідовності, які можуть бути ширше застосовними, наприклад XY4 (показана на схемі кола нижче) та складніша XY8.

Ще одне застереження полягає в тому, що динамічне розщеплення додає однокубітні вентилі, які можуть додавати однокубітні помилки через недосконалість вентилів або навіть перехресні завади. Ці рівні однокубітних помилок зазвичай значно нижчі за помилки багатокубітних вентилів, тому зазвичай це не є серйозною проблемою, але про це варто пам'ятати, якщо багато кубітів застосовують ДР багато разів протягом вашого кола.
ДР корисне, коли зовнішня взаємодія встигає вплинути на стан кубіта. Оскільки кубіти ретельно добре ізольовані, а зовнішні взаємодії мають бути слабкими, цей тип шуму найпомітніший, коли кубіт простоює протягом тривалих періодів. За коротких часів простою ефект ДР може полягати в додаванні помилок однокубітних вентилів при придушенні дуже малої кількості шуму; вірність вашого кола може навіть знизитися.
Головний висновок: використовуйте динамічне розщеплення, коли кубіти простоюють протягом достатньо тривалих періодів, і звертайте увагу на тип послідовності ДР, що використовується.
Динамічне розщеплення за допомогою Qiskit
Дослідімо використання ДР, розглянувши випадок кількох кубітів, підготовлених у стані , які потім простоюють протягом тривалого часу. За відсутності помилок підготовка багатокубітного стану з подальшим застосуванням вентиля Адамара перед вимірюванням (таким чином вимірюючи в базисі X) завжди повинна давати 0. За наявності шуму результат вимірювання дорівнюватиме 0 лише частину часу, а не зі 100% ймовірністю. Ми обчислюємо середнє очікуване значення X для кількох кубітів. Тобто нас цікавить таке:
де з оператором X на -й позиції справа, а — стан усієї системи.
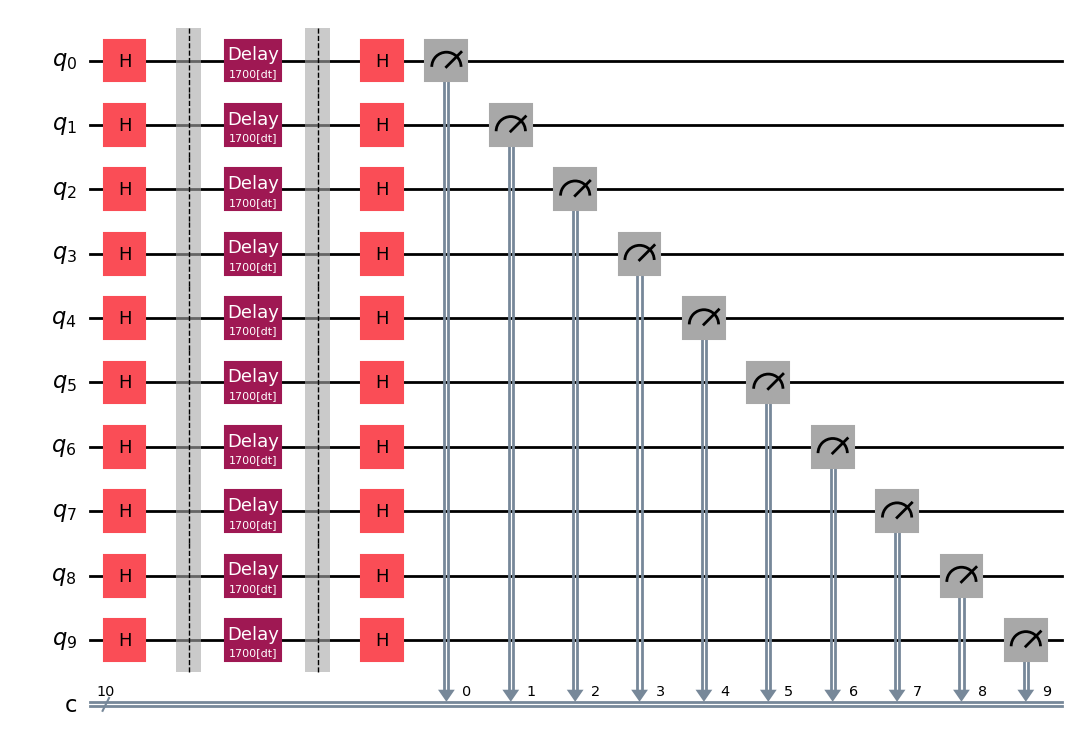
Це коло містить навмисні затримки, що дещо штучно для бенчмарку. Однак для реальних кіл дуже поширено мати кубіти, які простоюють протягом частини виконання. Це можна розглядати як спрощену модель складнішого кола, в якому деякі кубіти простоюють протягом частини обчислення. Цей тип бенчмаркінгу, заснований на еволюції станів , часто називають бенчмаркінгом Ремзі.
Почнімо із завантаження необхідних пакетів і налаштування сервісу.
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-aer qiskit-ibm-runtime
# Load key packages

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit
import numpy as np

# --------- Configuration ----------

service = QiskitRuntimeService()  # assumes credentials are saved
backend = service.backend("ibm_fez")  # adjust if needed
Тепер визначимо кілька допоміжних функцій. Спочатку ми хочемо розглянути питання про тривалі часи простою. Що саме означає "тривалий" у цьому контексті? Ми могли б просто вказати час простою в мікросекундах. Однак корисно знати, скільки двокубітних вентилів можна було б виконати протягом того самого інтервалу. Це робить часи простою більш безпосередньо показовими для глибини кола, яку можна було б виконати протягом того самого періоду. Перша допоміжна функція отримує двокубітний вентиль, рідний для бекенду, і визначає тривалість цього вентиля.
Друга функція просто створює коло Ремзі (з кубітами у стані ), реалізує затримку, повертає за допомогою вентиля H, а потім вимірює. Пригадаймо, що вентиль Адамара (H) відображає у , тому вимірювання у базисі Z після вентиля Адамара відповідає тому, що кубіт перебував у стані безпосередньо перед вентилем Адамара.
Наша остання функція перетворює необроблені підрахунки результатів вимірювання 0 та 1 на очікуване значення X.
from typing import Tuple
from qiskit.providers import Backend
from numpy.typing import NDArray

# --------- Utilities ----------
def detect_twoq_gate_and_duration(
    backend: Backend, pair: tuple[int, int] = (0, 1)
) -> Tuple[str, float]:
    props = backend.properties()
    candidates = ["cx", "ecr", "cz"]
    for name in candidates:
        try:
            dur = props.gate_length(name, list(pair))
            if dur is not None:
                return name, dur
        except Exception:
            pass
    raise RuntimeError(
        "Could not find a two-qubit gate duration among cx/ecr/cz on this backend."
    )

def make_multiqubit_ramsey_circuit(n: int, delay_dt_ticks: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q)
    qc.barrier()

    for i in range(n):
        qc.delay(delay_dt_ticks, q[i], unit="dt")
    qc.barrier()

    qc.h(q)
    qc.measure(q, c)
    return qc

def counts_to_x_expectations(counts: dict[str, int], n: int) -> NDArray[np.float64]:
    total = sum(counts.values())
    if total == 0:
        return np.zeros(n)

    p0 = np.zeros(n, dtype=float)
    for bitstring, cnt in counts.items():
        bits_rev = bitstring[::-1]
        for i in range(n):
            if bits_rev[i] == "0":
                p0[i] += cnt
    p0 /= total
    return 2.0 * p0 - 1.0
Тепер вкажемо деталі нашого тесту, зокрема кількість кубітів та послідовність вентилів, яка використовуватиметься в ДР (у цьому разі XX). Особливо зверніть увагу, що ми встановлюємо рівень оптимізації на нуль. На практиці ви часто обиратимете вищий рівень оптимізації; тут ми використовуємо рівень 0, щоб забезпечити видимість ефектів помилок, на які націлене ДР. Нарешті, ми визначаємо характерний час для двокубітних вентилів на цьому бекенді та виводимо деякі відповідні часи.
n_qubits = 10  # number of qubits to test in parallel
shots = 4096
opt_level = 0  # we want to ignore optimization for now
num_steps = 6  # number of delay points
gates_per_step = 20  # "equivalent 2q gates" per step
dd_sequence = "XX"  # "XX" for your request; you might try "XY4" too

# --------- Derive timing: dt and 2q gate time ----------
dt = backend.dt  # seconds per dt
twoq_name, t2q = detect_twoq_gate_and_duration(backend, (0, 1))  # seconds
delay_unit_dt = int(round(t2q / dt))  # dt ticks equivalent to one 2q gate

print(f"Backend: {backend.name}")
print(f"dt = {dt*1e9:.3f} ns per tick")
print(f"Using 2q gate '{twoq_name}' with duration ~ {t2q*1e9:.1f} ns")
print(f"One 2q gate ≈ {delay_unit_dt} dt ticks")
Backend: ibm_fez
dt = 4.000 ns per tick
Using 2q gate 'cz' with duration ~ 68.0 ns
One 2q gate ≈ 17 dt ticks
Тепер побудуємо наші кола та транспілюємо їх для обраного нами бекенда.
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

equiv_gates_list = [
    j * gates_per_step for j in range(num_steps)
]  # e.g., 0, 100, 200, ...
delay_dt_list = [int(round(delay_unit_dt * m)) for m in equiv_gates_list]
delay_us_list = [(dt * d) * 1e6 for d in delay_dt_list]  # for printing/plotting

circuits = []
for delay_dt in delay_dt_list:
    qc = make_multiqubit_ramsey_circuit(n_qubits, delay_dt)
    qc_isa = pm.run(qc)  # ISA-level scheduling/placement; DD is handled at runtime
    circuits.append(qc_isa)

print("Delay sweep (approx microseconds):", [f"{t:.2f}" for t in delay_us_list])
Delay sweep (approx microseconds): ['0.00', '1.36', '2.72', '4.08', '5.44', '6.80']
Нам варто візуалізувати принаймні одне коло, щоб переконатися, що ми закодували наше коло з бажаними станами та затримками. Можливо, простіше візуалізувати коло до транспіляції qc, або ж перевірити транспільоване qc_isa.
qc.draw("mpl")
Виконання
Нарешті ми готові виконати на апаратному забезпеченні. Ми використовуємо Sampler для отримання багатьох вимірювань кожного кубіта, і ми використаємо його двічі: один раз із явно вимкненим ДР, і один раз із увімкненим ДР та з використанням послідовності вентилів XX.
# --------- Run: NO DD ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = False

job = sampler.run(circuits)
res_nodd = job.result()
job_id = job.job_id()  # job id for dd off/false
print("job number for no dd is ", job_id)

# --------- Run: WITH DD (XX) ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = (
    dd_sequence  # "XX" first; you can try "XY4" too
)
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_dd = job.result()
job_id = job.job_id()  # job id for dd on/XX
print("job number for dd using XX is ", job_id)
Ми можемо витягти підрахунки з різних кіл.
# --------- Extract counts per circuit ----------

from typing import Iterable, Any

def extract_counts_list(res: Iterable[Any]) -> list[dict[str, int]]:
    counts_list: list[dict[str, int]] = []

    for r in res:  # each r corresponds to one circuit
        counts: dict[str, int] = r.data.c.get_counts()
        counts_list.append(counts)

    return counts_list

counts_list_nodd = extract_counts_list(res_nodd)
counts_list_dd = extract_counts_list(res_dd)
Постобробка
Тепер у нас є підрахунки з вимірювання, але ми хочемо перетворити їх на очікуване значення X, а потім усереднити ці очікувані значення для всіх використаних нами кубітів, щоб дізнатися про збереження інформації про фазу. Для цього ми використовуємо нашу функцію counts_to_x_expectations, визначену раніше.
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.

xexp_nodd = []
xexp_dd = []
contrast_nodd = []
contrast_dd = []

for counts in counts_list_nodd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_nodd.append(x_vec)
    contrast_nodd.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

for counts in counts_list_dd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_dd.append(x_vec)
    contrast_dd.append(float(np.mean(np.abs(x_vec))))

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1 in zip(equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD  :", np.round(np.abs(xexp_dd[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.954,  DD(XX)= 0.961
Delay ~   20 * cz  (~   1.36 µs):  NoDD= 0.827,  DD(XX)= 0.927
Delay ~   40 * cz  (~   2.72 µs):  NoDD= 0.793,  DD(XX)= 0.900
Delay ~   60 * cz  (~   4.08 µs):  NoDD= 0.729,  DD(XX)= 0.876
Delay ~   80 * cz  (~   5.44 µs):  NoDD= 0.661,  DD(XX)= 0.854
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.586,  DD(XX)= 0.826

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.05  0.744 0.712 0.867 0.844 0.234 0.473 0.755 0.59  0.587]
DD  : [0.583 0.89  0.921 0.88  0.908 0.832 0.893 0.773 0.807 0.773]
Нарешті, побудуймо графік наших результатів.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With DD", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
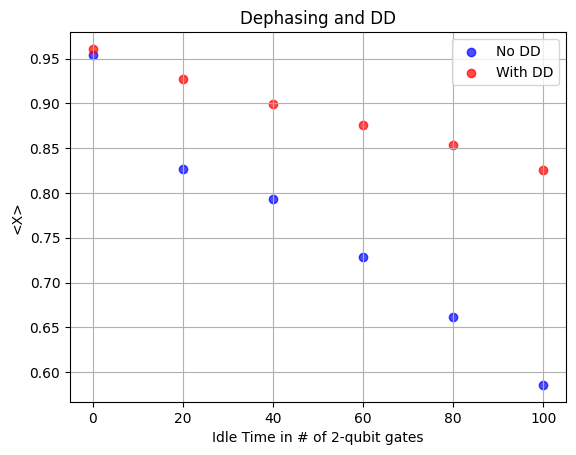
Як бачите, без явної затримки очікувані значення справді близькі до 1, що ми й очікували б, якби вся інформація про фазу була збережена. Якби вся інформація про фазу була втрачена, не було б переваги для остаточного повороту давати , а не , і середнє очікуване значення наближалося б до нуля. У даних ми бачимо, що зі збільшенням часів затримки середнє очікуване значення X зменшується, наближаючись до нуля. Зверніть увагу, що ДР тут виявилося дуже ефективним; очікувані значення з ДР зазвичай більш ніж на 20% кращі (ближчі до 1), ніж значення без ДР. Але також зверніть увагу, що перша точка даних із затримкою відповідає затримці, приблизно еквівалентній 100 операціям двокубітних вентилів. Це підкреслює те, що ДР найкорисніше, коли кубіти простоюють протягом відносно тривалих періодів.
Перевірте своє розуміння
Якщо ми застосуємо ДР з використанням XY4 до того самого кола, що й раніше, чи очікуєте ви результатів, що будуть значно кращими, значно гіршими чи приблизно такими самими, як ДР з використанням XX? Поясніть.
Відповідь
Приблизно такими самими, можливо, трохи гіршими. У колі, яке ми використовували, стани були повернуті в площину XY. Цей стан зберігає інформацію переважно у своїй фазі, що робить його особливо чутливим до дефазувальних помилок, а не до релаксації T1. XY4 міг би допомогти з ширшим спектром помилок, але XX уже оптимізовано для допомоги колу, яке ми використовуємо. XY4 міг би бути так само хорошим, але не додав би нічого суттєвого, або той факт, що XY4 містить більше вентилів, може дозволити додатковим помилкам вентилів зробити результати трохи гіршими.
В останньому результаті використовувалася найпростіша послідовність вентилів ДР XX. Подивімося, як реалізувати складнішу послідовність, XY4. Ми визначимо Sampler у наступному розділі.
# --------- Run: WITH DD (XY4) ----------
dd_sequence = "XY4"

sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = dd_sequence
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_xy4 = job.result()
job_id = job.job_id()  # job id for dd on/XY4
print("job number for dd using Xy4 is ", job_id)
job number for dd using Xy4 is d6k6ti860irc7395d3hg
# --------- Extract counts per circuit ----------

counts_list_xy4 = extract_counts_list(res_xy4)
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.
xexp_xy4 = []
contrast_xy4 = []

for counts in counts_list_xy4:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_xy4.append(x_vec)
    contrast_xy4.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1, c2 in zip(
    equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd, contrast_xy4
):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD XX :", np.round(np.abs(xexp_dd[-1]), 3))
print("DD XY4 :", np.round(np.abs(xexp_xy4[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.968,  DD(XY4)= 0.968
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.612,  DD(XY4)= 0.839
Delay ~  200 * cz  (~  13.60 µs):  NoDD= 0.462,  DD(XY4)= 0.705
Delay ~  300 * cz  (~  20.40 µs):  NoDD= 0.339,  DD(XY4)= 0.580
Delay ~  400 * cz  (~  27.20 µs):  NoDD= 0.225,  DD(XY4)= 0.481
Delay ~  500 * cz  (~  34.00 µs):  NoDD= 0.204,  DD(XY4)= 0.393

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.002 0.208 0.447 0.034 0.286 0.306 0.322 0.044 0.163 0.232]
DD XX : [0.433 0.669 0.526 0.516 0.572 0.284 0.303 0.055 0.365 0.208]
DD XY4 : [0.38  0.662 0.521 0.538 0.621 0.252 0.353 0.038 0.239 0.073]
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD using XX sequence
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With XX", alpha=0.7
)

## Add values with DD using XY4 sequence
ax.scatter(
    equiv_gates_list,
    contrast_xy4,
    c="black",
    linestyle="-",
    label="With XY4",
    alpha=0.7,
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>_av")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
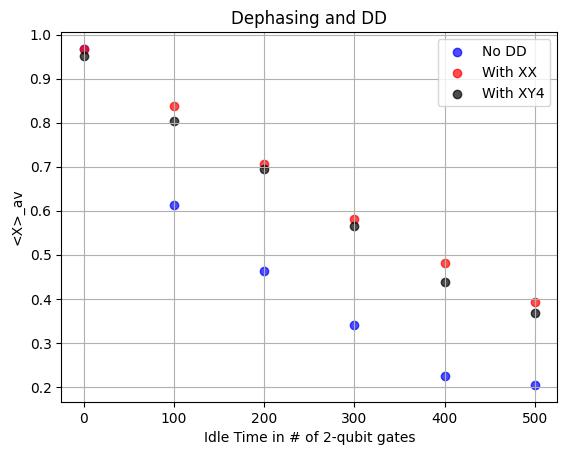
Тут ми бачимо, що XY4 помітно не відрізняється від XX. Він може бути дуже трохи гіршим через додаткові вентилі в послідовності XY4, але важливіше те, що ми вже пояснили, чому XX мав би бажаний ефект у збереженні фази саме для стану на кшталт . Немає підстав вважати, що для такого початкового стану інша послідовність покращила б результати.
Перевірте своє розуміння
Перевірте, що послідовність XY4 залишає стан незмінним з точністю до глобальної фази.
Відповідь
Твірлінг Паулі
Почнімо із зауваження, що твірлінг Паулі часто використовується не як методика придушення помилок, а як методика формування помилок: він змушує шум/помилки поводитися інакше, іноді передбачуваніше, щоб уможливити інші методи. Хоча твірлінг Паулі не запобігає помилкам, він може запобігти їхньому когерентному накопиченню.
У квантовому колі складаються кілька різних джерел помилок. Помилки можуть складатися по-різному, зокрема когерентно та некогерентно. Когерентне накопичення помилок означає, що шум або недосконалі реалізації, як правило, спрямовують помилки в одному напрямку через кілька шарів і вентилів. Прикладом може бути когерентний надмірний поворот при застосуванні вентиля повороту.
Розгляньмо ідеальний вентиль повороту, наприклад , який повертає навколо осі X точно на . Звісно, реалізація вентиля не є ідеальною, і фактичний поворот для однієї реалізації може становити , і навіть може бути так, що завжди має той самий знак і, можливо, подібну величину при багатьох застосуваннях . Таким чином, повторне застосування вентилів повороту може призвести до когерентного накопичення цих численних надмірних поворотів (або недостатніх поворотів), .
Некогерентне накопичення помилок є протилежним: помилки у випадкових напрямках із випадковими знаками, так що помилки в різних шарах не завжди інтерферують адитивно, а іноді скасовуються або складаються в квадратурі. Очевидно, що некогерентні помилки накопичуються повільніше з точки зору загального впливу на стан кубіта. Спрощена схема цього показана на рисунку нижче. Це спрощення. Реальні квантові помилки не обмежені двовимірним декартовим простором; не всі внески помилок матимуть однакову величину, і є більше складностей. Але інтуїція такої картини корисна: когерентні помилки, як правило, накопичуються швидше за некогерентні.
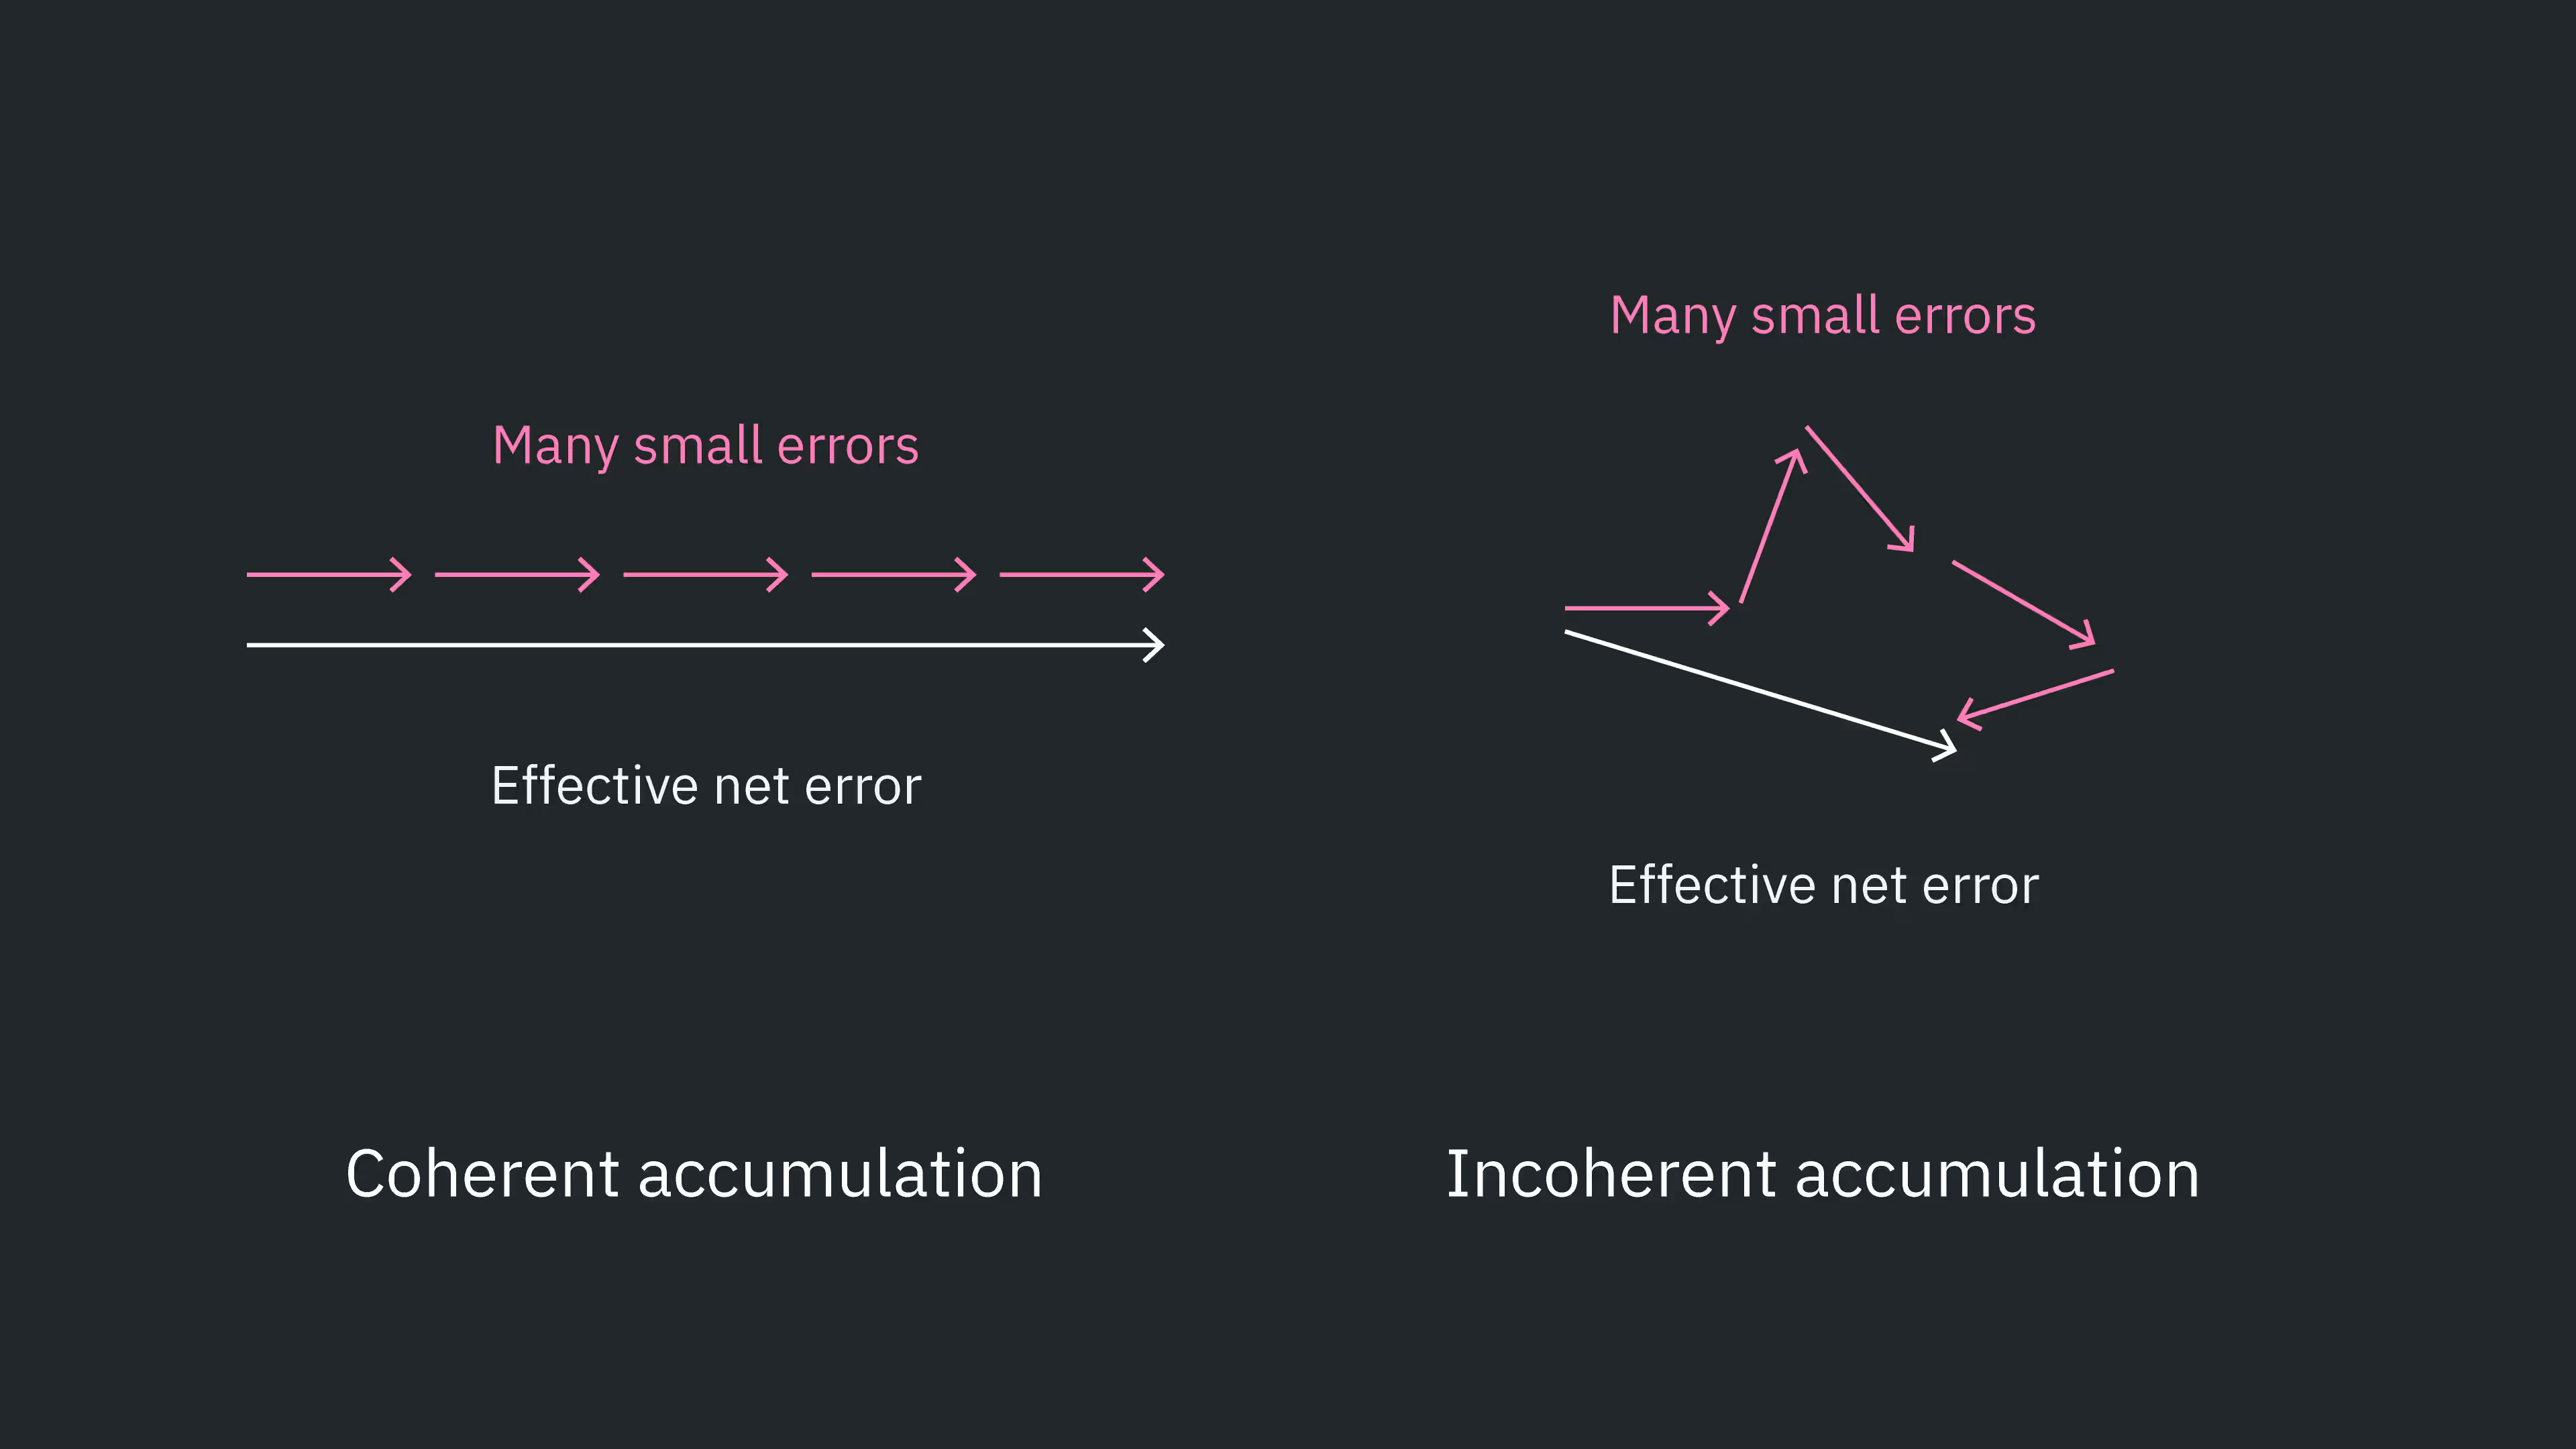
Часто можна отримати результати з вищою вірністю, перетворивши когерентне накопичення помилок на некогерентне. Основний спосіб досягти цього називається твірлінг Паулі.
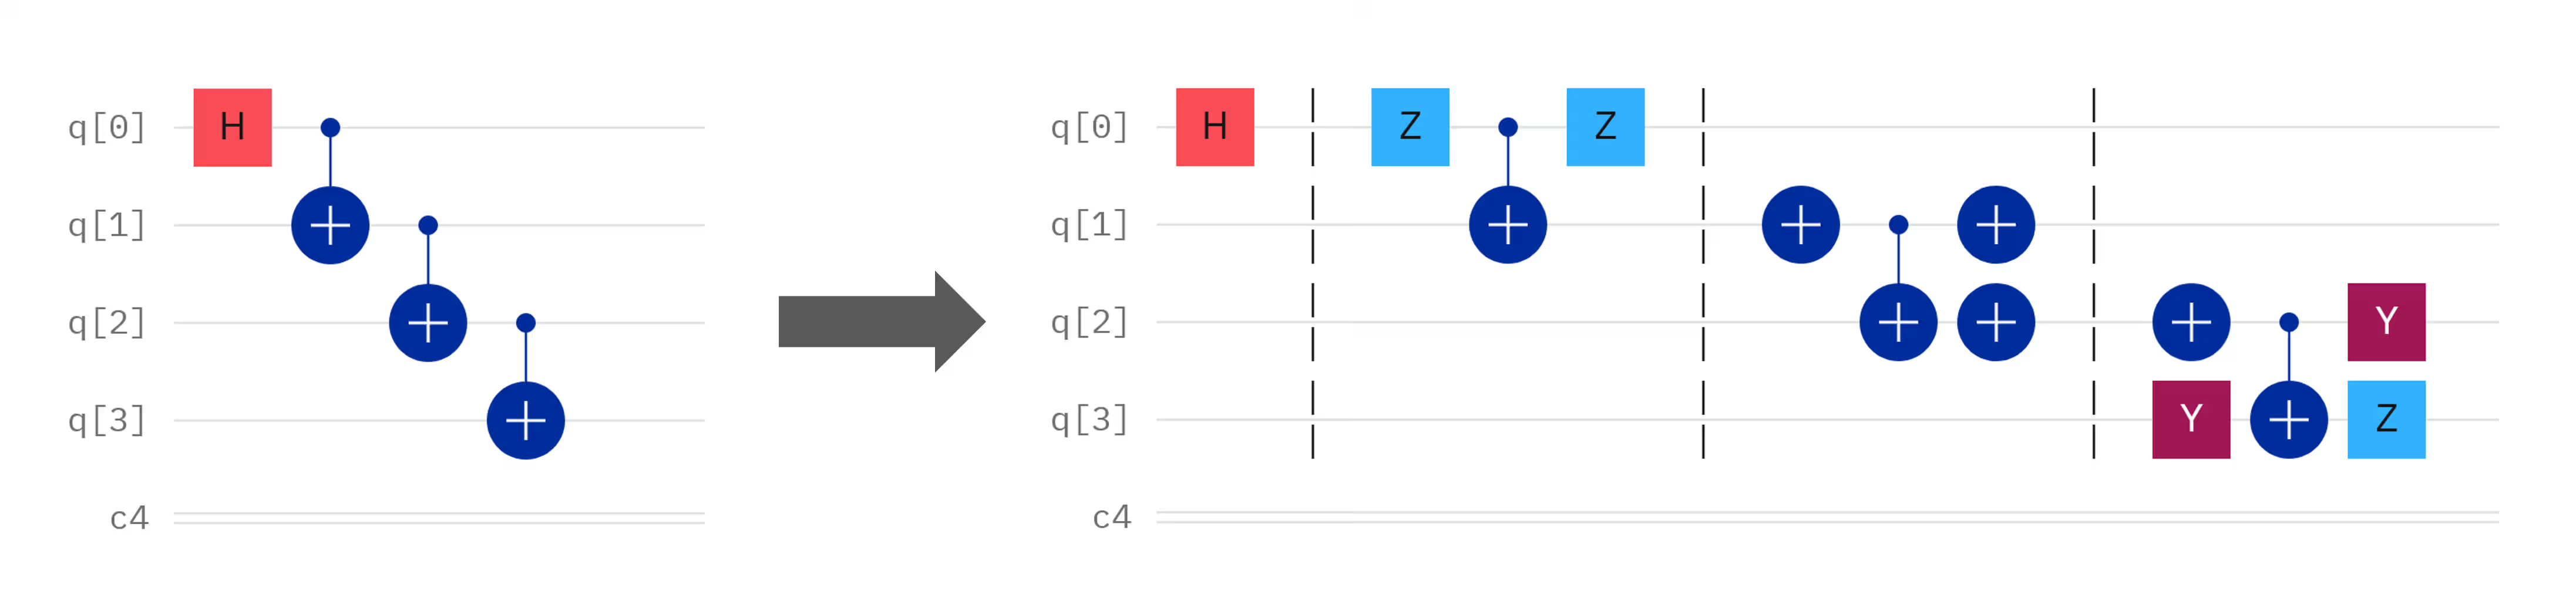
Твірлінг Паулі означає додавання комбінацій вентилів Паулі до і після бажаної операції вентиля таким чином, щоб . Тут та — не окремі оператори Паулі, а набори операторів Паулі, які часто діють на кілька кубітів. Іноді можна зустріти твердження, що дія додаткових вентилів Паулі "еквівалентна тотожності". Але це неточно і потенційно вводить в оману. Вентилі Паулі розділені , і мета полягає в тому, щоб залишити логічну дію всіх вентилів рівною . Іноді називають "корисним навантаженням", щоб відрізнити цю задуману операцію від вентилів, доданих для придушення. Деякі приклади твірлінгу Паулі навколо вентиля CNOT показані нижче.

Розгляньмо лише один приклад, щоб перевірити, що твірлінг залишає логічний ефект корисного навантаження незмінним. Без втрати загальності нехай двокубітні стани, що включають та , будуть такими:
Як завжди, ми використовуємо угоду про порядок кубітів . Застосування вентиля CX з як цільовим дає
Тепер розгляньмо третє показане коло, яке використовує вентилі X для твірлінгу Паулі. Ми могли б просто перемножити матриці й перевірити, що вони дають матрицю CNOT. Альтернативно, ми можемо відстежити операцію на довільному квантовому стані через коло, як робимо нижче. Стани в різних точках кола позначено літерами a-d.

Це точно , який ми отримали раніше без твірлінгу. Дійсно, ця твірльована послідовність вентилів залишає логічну дію корисного навантаження незмінною. Однак, якщо різні допустимі послідовності твірлінгу обираються випадково від шару до шару, когерентне накопичення помилок можна перетворити на фактично стохастичне (некогерентне) накопичення помилок. Щоб було зрозуміло, не обирається один шаблон твірлінгу для використання протягом усього кола. Натомість для різних шарів обираються різні допустимі послідовності твірлінгу. Приклад із багатьма шарами заплутування може виглядати так.
Перевірте своє розуміння
Перевірте, що твірлінг Паулі на четвертій панелі рисунка вище також залишає логічний ефект CNOT незмінним.
Відповідь
Дотримуючись прикладу вище, покажемо, що дія на будь-який довільний двокубітний стан еквівалентна операції CNOT. Ми посилатимемося на позначені точки на цій схемі.

Це еквівалентно дії CNOT із кубітом 0 як керуючим і кубітом 1 як цільовим.
Чи можете ви придумати послідовність твірлінгу Паулі для вентиля CNOT, яка не показана вище?
Відповідь
Так, існує багато інших. Одним із прикладів є перед CNOT, і та після CNOT.
Коли використовувати твірлінг Паулі
У тому вигляді, як подано тут, твірлінг Паулі застосовується лише до багатокубітних вентилів. Застосування подібного протоколу до однокубітних вентилів вимагало б іншої логіки і загалом не є корисним на практиці. Сам твірлінг Паулі використовує кілька однокубітних вентилів (вентилі Паулі). Додаткові вентилі Паулі, ймовірно, внесли б більше помилок, ніж було б виграно від рандомізації будь-якого когерентного накопичення помилок. Рівні помилок, пов'язані з двокубітними вентилями, значно більші за ті, що пов'язані з однокубітними вентилями. Крім того, деякі однокубітні вентилі є не-кліффордовими, які не можна повністю твірлювати. Ось чому Qiskit включає опції твірлінгу Паулі, які автоматично твірлюють навколо двокубітних вентилів, а не навколо однокубітних.
Це малося на увазі на рисунку вище: твірлінг Паулі було реалізовано навколо вентилів CX, але не навколо вентиля Адамара.
Розгляньмо два приклади твірлінгу Паулі в дії.
Твірлінг Паулі для придушення когерентного накопичення
Щоб спостерігати, як твірлінг Паулі може перетворити когерентне накопичення помилок на повільніше некогерентне накопичення, нам потрібне коло та спостережувана величина, які функціонують як стрес-тест когерентних помилок. Єдина мета — зробити видимим когерентне накопичення двокубітних помилок, а потім показати, як твірлінг Паулі перетворює це когерентне накопичення на стохастичний розпад.
Вентилі CNOT (або CZ) є поширеним джерелом когерентних помилок. Найпростіший експеримент, який ми можемо провести в цьому випадку, — це ініціалізувати стан (скажімо, ), застосувати шари парних вентилів CNOT (використовуючи той факт, що два CNOT дають тотожність) і перевірити, як помилки накопичуються зі збільшенням кількості шарів, як з твірлінгом Паулі, так і без нього.
Спостережувана величина, що нас цікавить, — це на одному кубіті, яку ми будуємо як функцію кількості повторень пар CNOT.
# --- Imports ---

import numpy as np
from qiskit import QuantumCircuit
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
# Build the circuit with CX/CX identity per layer

def identity_cx_pairs(layers: int) -> QuantumCircuit:
    q = QuantumRegister(2, "q")
    c = ClassicalRegister(1, "c")  # we only measure q0
    qc = QuantumCircuit(q, c, name=f"N={layers}")

    # |+> on q0
    qc.h(q[0])

    for _ in range(layers):
        qc.barrier()
        qc.cx(q[0], q[1])
        qc.cx(q[0], q[1])

    # Measure in X basis: H then measure q0

    qc.h(q[0])
    qc.measure(q[0], c[0])

    return qc
Оскільки ми повернули наш базис перед вимірюваннями, вимірювання відповідає тому, що стан перебував у безпосередньо перед останнім вентилем Адамара, і аналогічно для та . Тому наше очікуване значення можна просто обчислити як різницю підрахунків і підрахунків .
# Compute <X> from SamplerV2 counts

def x_expect_from_counts(counts: dict[str, int]) -> float:
    shots = sum(counts.values())
    p0 = counts.get("0", 0) / shots
    p1 = counts.get("1", 0) / shots
    return p0 - p1  # <X> = P(0) - P(1) after H,measure
Ми обираємо розумну кількість шарів CNOT, протягом яких дозволяємо помилці накопичуватися, будуємо наші кола, а потім транспілюємо їх.
# Choose the number of layers for the experiment
N_layers_list = [0, 1, 2, 3, 4, 5]

circuits = [identity_cx_pairs(n) for n in N_layers_list]

# Transpile to backend ISA so that primitives run native instructions
pm = generate_preset_pass_manager(backend=backend, optimization_level=0)
isa_circuits = [pm.run(c) for c in circuits]
Пам'ятайте, що кожен шар складається з більш ніж одного двокубітного вентиля. Відстежуйте транспільовану двокубітну глибину за допомогою наведеної нижче функції.
# We can check the 2-qubit depths of any of our circuits like this:
print(
    "two-qubit depth",
    isa_circuits[5].decompose().depth(lambda instr: len(instr.qubits) > 1),
)
two-qubit depth 15
# Configure two Samplers: (A) no twirling, (B) gate twirling
#    - No DD, no measurement twirling in both (to isolate gate twirling)
# ------------------------------
shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
Тепер запустимо завдання.
# Run both jobs; extract counts; compute <X>

# Helper to run a sampler and compute <X> per circuit
def run_and_x_expect(sampler: Sampler, circ_list: list[QuantumCircuit]) -> list[float]:
    job = sampler.run(
        circ_list
    )  # shots taken from options.default_shots unless overridden
    result = job.result()
    # For SamplerV2, use join_data().get_counts() to combine registers if needed
    exp_vals = []
    for pub in result:
        counts = pub.join_data().get_counts()
        exp_vals.append(x_expect_from_counts(counts))
    return exp_vals

x_no_twirl = run_and_x_expect(sampler_no_twirl, isa_circuits)
x_twirl = run_and_x_expect(sampler_twirl, isa_circuits)

# ------------------------------
# 6) Print a small table
# ------------------------------
print("\nN_layers   <X> (no twirl)   <X> (gate twirl)")
for n, a, b in zip(N_layers_list, x_no_twirl, x_twirl):
    print(f"{n:7d}   {a:14.6f}   {b:14.6f}")
N_layers   <X> (no twirl)   <X> (gate twirl)
      0         0.984375         0.987549
      1         0.934326         0.936523
      2         0.844238         0.892822
      3         0.712158         0.879395
      4         0.592529         0.844971
      5         0.449463         0.785156
Нарешті, візуалізуємо ці результати.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using XX
ax.scatter(
    N_layers_list, x_no_twirl, c="blue", linestyle="-", label="No twirl", alpha=0.7
)

## Add values with XY4
ax.scatter(N_layers_list, x_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7)

# Add labels and plot
ax.set_xlabel("CX layers")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Pauli twirling")
ax.grid(True)

plt.show()
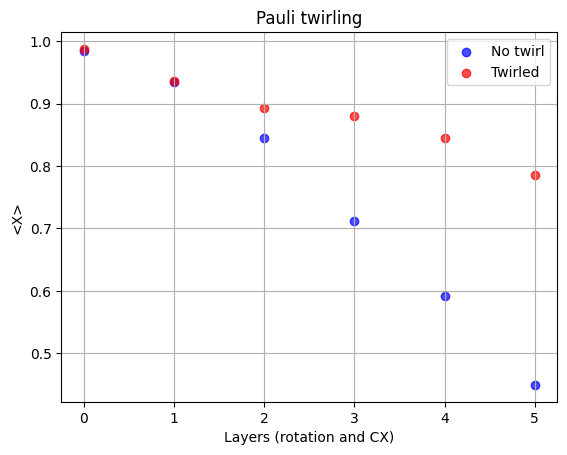
Ми чітко бачимо, що твірльоване коло дає очікуване значення, ближче до ідеального . Цей приклад виконав своє призначення, але перейдімо до чогось кориснішого: твірлінгу при виробництві сильно заплутаних станів.
Твірлінг Паулі в підготовці GHZ-стану
Попередній приклад показав переконливий аргумент на користь твірлінгу Паулі в руйнуванні когерентного накопичення помилок, пов'язаних із вентилями CNOT. Виробництво GHZ-стану використовує багато вентилів CNOT для отримання сильно заплутаних станів, корисних для багатьох застосувань квантових обчислень. Дослідімо, як твірлінг Паулі допомагає в цьому контексті, на прикладі GHZ-станів зростаючого розміру.
# Imports if not already loaded in previous cells
# from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
# from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit

# Define a GHZ circuit building function, so that we can build GHZ states of increasing size.

def ghz_circuit(n: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q[0])
    for i in range(n - 1):
        qc.cx(q[i], q[i + 1])

    qc.barrier()

    qc.measure(q, c)
    return qc

# Build a test state with 10 qubits to remind ourselves of GHZ structure.

num_qubits = 10

qc_ghz = ghz_circuit(num_qubits)
qc_isa = pm.run(qc_ghz)
qc_ghz.draw("mpl")
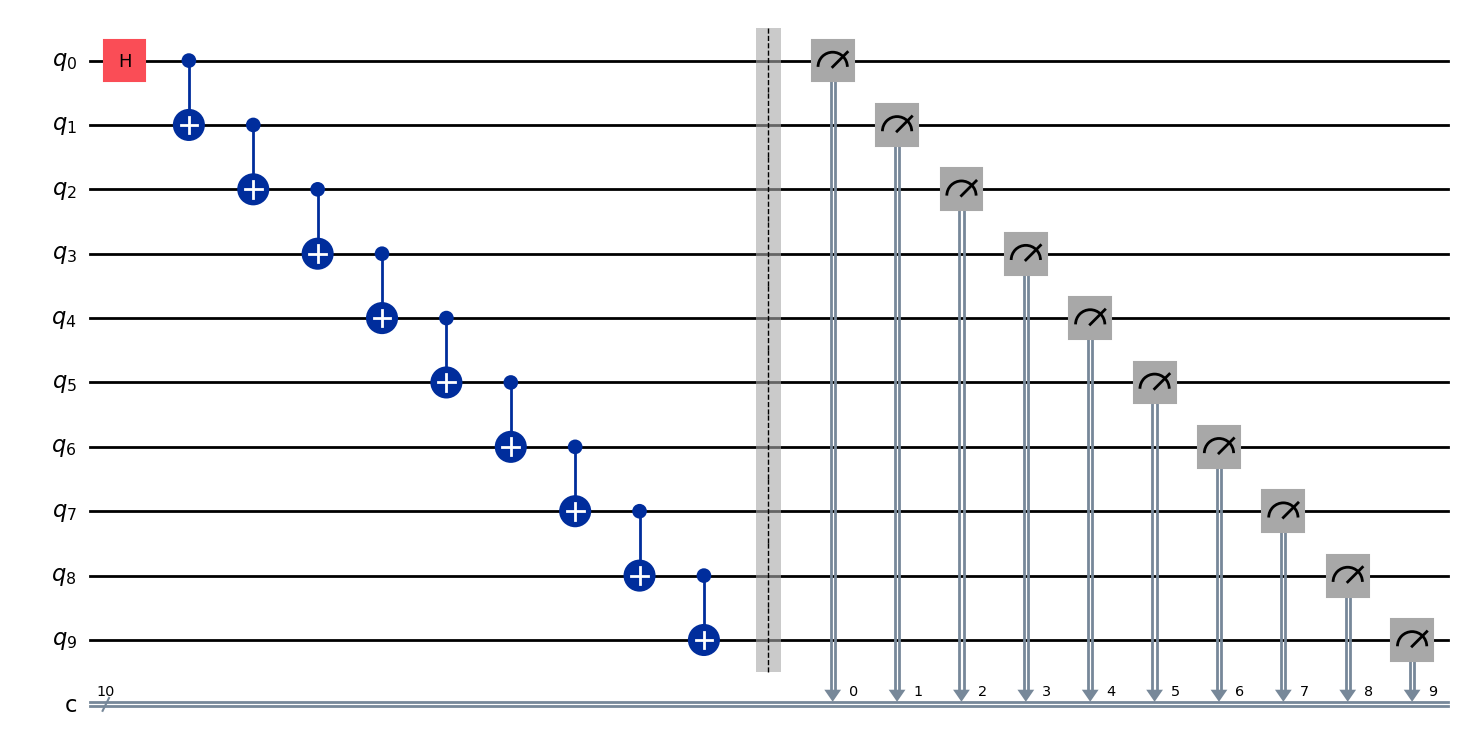
Тепер побудуємо наші кола та транспілюємо їх. У цьому випадку в нас немає штучно повторюваних вентилів, які зводяться до тотожності. Тож ми можемо дозволити менеджеру проходів зробити для нас трохи більше оптимізації. Ми встановимо рівень три.
# Set up a pass manager

opt_level = 3
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

# Build GHZ circuits of increasing size.

nmin = 5
nmax = 15
circuits = []
for n in range(nmin, nmax):
    qc = ghz_circuit(n)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
Ми бачимо, що оптимізатор відобразив наше абстрактне коло на кубіти 123, 124, 136, 142 та 143.
circuits[0].draw("mpl")
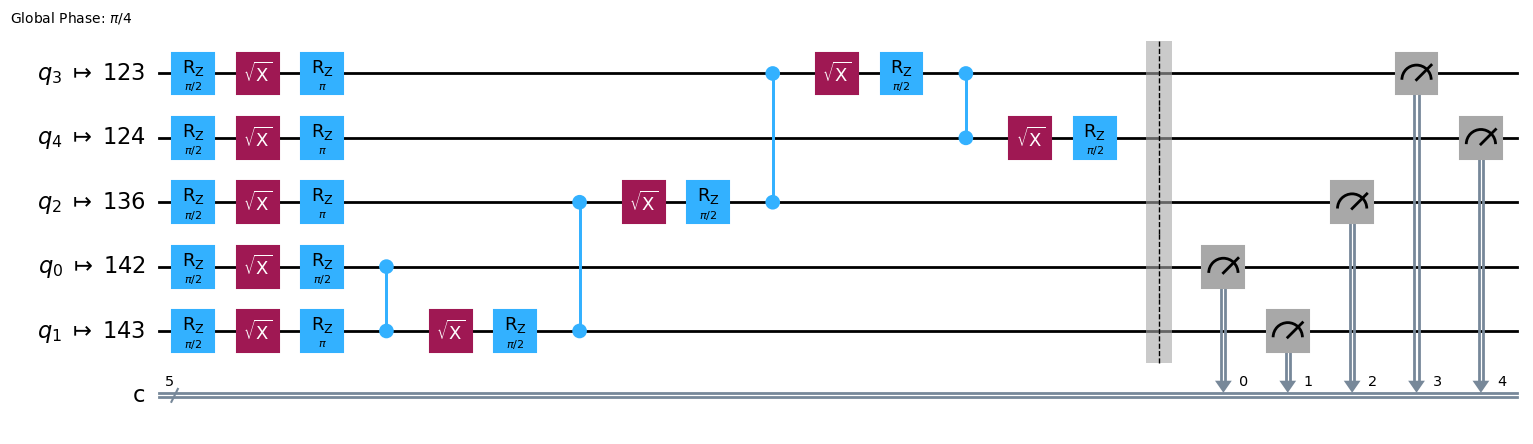
Щоб зрозуміти чому, погляньмо на карту розташування нашого бекенда (на цьому зображенні — ibm_fez, але ви можете провести еквівалентний аналіз на будь-якому бекенді).
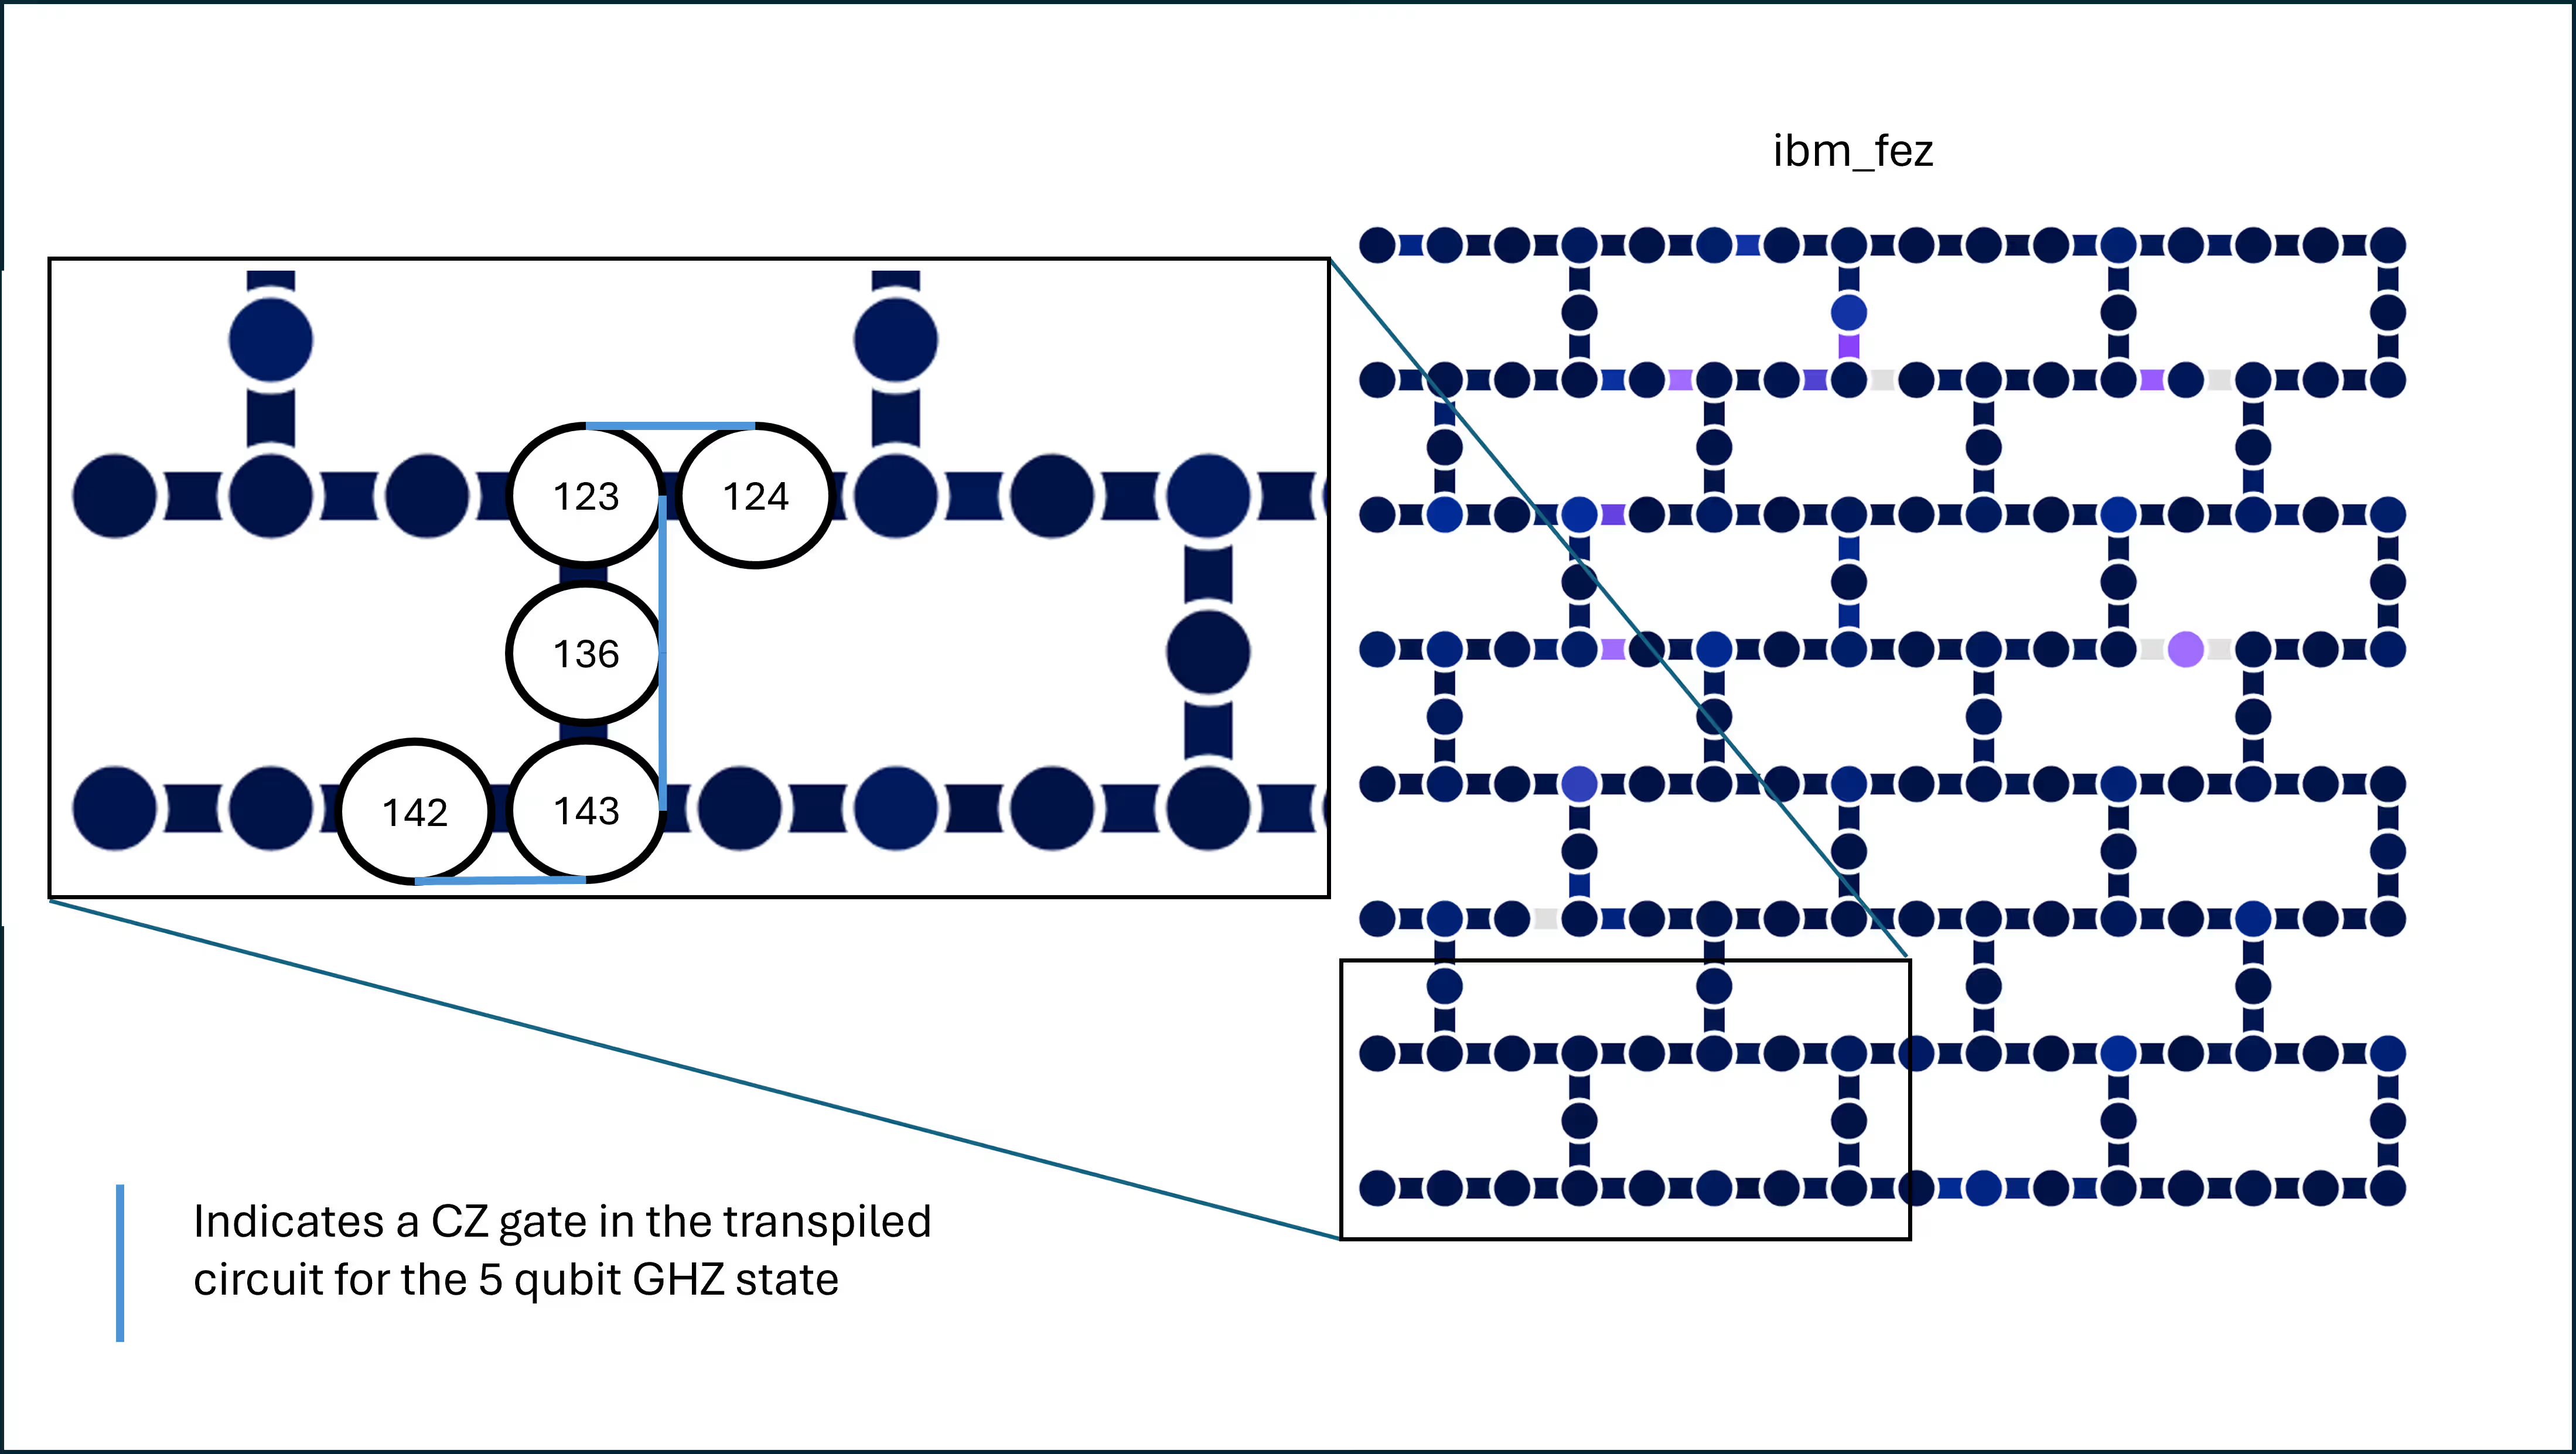
Ми бачимо, що кубіти було обрано у вигляді ланцюжка, щоб мінімізувати вентилі обміну (swap) і, отже, глибину кола. Крім того, кожен вентиль CZ, реалізований у колі, знаходиться між сусідніми кубітами. Нарешті, усі п'ять кубітів мають відносно низькі рівні помилок, включно з рівнями помилок присвоєння зчитування. Ви можете перевірити ці рівні помилок для будь-якого бекенда на сторінці Обчислювальні ресурси. Знайти таке розташування нескладно для простого лінійного ланцюжка, але зі зростанням складності задач оптимізація розташування кола стає складнішою та ціннішою.
Тепер налаштуємо наш примітив Sampler. Ми вимикаємо інші інструменти придушення/пом'якшення, щоб зосередитися на твірлінгу Паулі.
# Configure two Samplers: (A) no twirling, (B) gate twirling
# No DD, no measurement twirling in both (to isolate gate twirling)

shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
Нарешті, запускаємо наші завдання. За бажанням ви можете вивести номери ID завдань для подальшого отримання.
job = sampler_twirl.run(circuits)
res_ghz_twirl = job.result()
job_id = job.job_id()  # job id for twirling on/true
print("job number for twirling the ghz prep is ", job_id)

job = sampler_no_twirl.run(circuits)
res_ghz_no_twirl = job.result()
job_id = job.job_id()  # job id for twirling off/false
print("job number for NO twirling the ghz prep is ", job_id)
job number for twirling the ghz prep is  d7h967bjne2c7393s0b0
job number for NO twirling the ghz prep is  d7h96f7b91ec73aufing
Ми витягуємо підрахунки кожного обчислювального базисного стану, виміряного для всіх кіл, як із твірлінгом, так і без нього.
# --------- Extract counts per circuit ----------
def extract_counts_list(res):
    counts_list = []
    for r in res:  # each r corresponds to one circuit
        # r.data.<classical_register_name>.get_counts()
        counts = r.data.c.get_counts()
        counts_list.append(counts)
    return counts_list

counts_list_ghz_twirl = extract_counts_list(res_ghz_twirl)
counts_list_ghz_no_twirl = extract_counts_list(res_ghz_no_twirl)
print(counts_list_ghz_twirl[0])
print(counts_list_ghz_twirl[4])
{'11111': 3440, '11101': 87, '00000': 3434, '10111': 87, '00001': 168, '10011': 4, '11000': 102, '00011': 39, '01111': 93, '00111': 111, '01000': 90, '11110': 235, '00110': 6, '00010': 75, '11011': 30, '11100': 42, '10000': 82, '00101': 7, '10001': 2, '11001': 6, '11010': 5, '01010': 3, '01110': 7, '00100': 14, '10101': 1, '10110': 8, '01001': 6, '10100': 1, '01101': 4, '01011': 1, '10010': 2}
{'111111111': 2683, '000000000': 2976, '111000000': 53, '110000000': 74, '111111100': 47, '111011111': 76, '111111110': 195, '111111000': 67, '000000010': 66, '011111110': 10, '011110001': 1, '101110111': 7, '101011111': 9, '111110111': 87, '111100000': 96, '111011000': 2, '010000000': 60, '111111010': 3, '100000000': 110, '111111011': 32, '000000111': 51, '000100000': 84, '000011111': 82, '000000001': 176, '100000010': 6, '111100001': 3, '000000011': 36, '101111111': 98, '100000011': 2, '001111111': 75, '000001000': 60, '000011101': 4, '110111111': 38, '111111101': 72, '111100100': 3, '000100010': 1, '001011101': 1, '000000110': 8, '110000011': 1, '000111111': 48, '000000100': 23, '000001111': 65, '010000101': 2, '000100001': 8, '111110000': 51, '010001111': 1, '111000111': 2, '111000001': 2, '000111100': 1, '011111111': 116, '111110001': 1, '000011110': 10, '000010000': 23, '000101111': 3, '000101110': 1, '011110111': 4, '010000111': 7, '111101111': 36, '001000000': 40, '010100000': 3, '101111110': 8, '110111000': 5, '000000101': 8, '010000010': 4, '000110001': 2, '110111110': 4, '111100010': 2, '111010111': 2, '000001110': 5, '111110101': 3, '001110000': 4, '101100000': 5, '001111110': 8, '100000001': 5, '111011110': 3, '111110100': 5, '110001011': 1, '001110111': 4, '000010110': 2, '111001111': 2, '000011000': 5, '010111110': 1, '000101000': 4, '101000000': 4, '100111111': 4, '111110011': 2, '000101100': 1, '101111100': 2, '111011100': 1, '001111011': 3, '011111011': 3, '110100000': 5, '000001011': 3, '111110110': 5, '111111001': 5, '000001001': 8, '010000001': 5, '011111101': 2, '001010111': 1, '011101110': 1, '110110110': 1, '001111100': 3, '100001000': 3, '001000011': 1, '001011111': 6, '110000010': 2, '110010000': 1, '010011111': 2, '111101101': 3, '101110000': 1, '111100111': 6, '010111111': 5, '110110000': 2, '011011111': 2, '110011111': 1, '110000111': 6, '001000001': 2, '001100000': 3, '101101111': 1, '000111110': 5, '111011101': 2, '100100000': 2, '101111101': 3, '001001111': 1, '001010000': 2, '111001000': 1, '011110000': 2, '011101111': 3, '000001100': 1, '110101000': 1, '011000000': 4, '111101000': 3, '110000001': 4, '000010111': 4, '011111100': 1, '111000010': 1, '101011000': 1, '101111000': 2, '001101111': 1, '010001100': 1, '000100011': 1, '111110010': 1, '111101110': 1, '100001111': 1, '100011011': 1, '010110111': 1, '001110110': 2, '100000100': 1, '001000110': 1, '100011111': 2, '010010001': 1, '111010110': 1, '011110110': 1, '000111000': 2, '000100111': 1, '011010000': 1, '001111000': 2, '100010000': 1, '011111000': 2, '110111100': 2, '110110111': 1, '110001000': 1, '000110111': 1, '000101011': 1, '000110000': 1, '011100000': 3, '001000010': 1, '001001000': 1, '001000111': 1, '001111101': 3, '111101011': 1, '111010000': 1, '100000101': 1, '000010010': 1, '001011110': 1, '000011011': 1, '111101100': 1}
Ми знаємо, що ідеальний розподіл GHZ-стану — це такий, у якому половина знімків повертає , а інша половина повертає . Побудуймо це для порівняння.
ideal_dist = []
for n in range(nmin, nmax):
    ideal_dist.append({"0" * n: int(shots / 2), "1" * n: int(shots / 2)})
Тепер ми використовуємо вірність Хеллінгера як міру якості нашого остаточного стану.
from qiskit.quantum_info import hellinger_fidelity

num_qubits = []
fidelities_twirl = []
fidelities_no_twirl = []
for n in range(len(ideal_dist)):
    num_qubits.append(nmin + n)
    fidelities_twirl.append(hellinger_fidelity(counts_list_ghz_twirl[n], ideal_dist[n]))
    fidelities_no_twirl.append(
        hellinger_fidelity(counts_list_ghz_no_twirl[n], ideal_dist[n])
    )
Нарешті побудуємо графік наших результатів.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using no twirling
ax.scatter(
    num_qubits,
    fidelities_no_twirl,
    c="blue",
    linestyle="-",
    label="No twirl",
    alpha=0.7,
)

## Add values with twirling
ax.scatter(
    num_qubits, fidelities_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Qubits in GHZ state")
ax.set_ylabel("Hellinger fidelity")
ax.legend()
ax.set_title("Pauli twirling in GHZ states")
ax.grid(True)

plt.show()
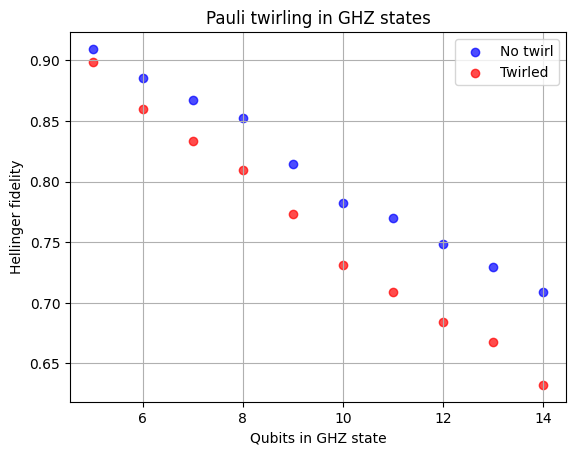
Результати з використанням твірлінгу Паулі не кращі (і навіть трохи гірші), ніж без твірлінгу. Що сталося?
Сталися дві речі. По-перше, твірлінг Паулі не зменшує загальну кількість шуму — натомість він переформовує когерентні, систематичні помилки на стохастичні помилки паулі-типу, так що зростання помилок стає передбачуваним і придатним до моделювання. Ніколи не було обіцянки зменшення помилок, за винятком особливих випадків.
По-друге, у GHZ-колах деякі когерентні помилки можуть частково скасовуватися або діяти як нешкідливі фазові зсуви через симетрію конструкції GHZ; твірлінг усуває цей випадковий захист і замінює його некорельованим стохастичним шумом Паулі, тому вірність GHZ дещо погіршується при твірлінгу.
Це друге твердження потребує деякого пояснення. Твердження полягає не в тому, що GHZ-кола захищені від усіх видів когерентного накопичення помилок, а лише від деяких видів — і що в цих випадках твірлінг руйнує цей захист. Зокрема, розгляньмо когерентний надмірний поворот, пов'язаний із вентилями CX. Назвемо реальний вентиль CX із надмірним поворотом :
де — будь-який добуток операторів Паулі, наприклад , , , тощо. Для загальних станів будь-які з цих надобертань можуть впливати на статистику вимірювань (а отже, і на міри точності стану). Проте підмножина з них залишає незмінними багато стандартних спостережуваних GHZ, зокрема оператори на кшталт та . У контексті підготовки стану GHZ відповідні помилки надобертання цього типу будуть такими:
Підготовка цілого -кубітного стану GHZ виглядала б так:
Після підготовки стану GHZ ідеальний стан такий:
Цей стан є одночасним власним станом великого набору операторів Паулі, зокрема таких:
з власним значенням . Як наслідок, оператор виду діє на стан GHZ як множення на фазовий множник , що не впливає на стандартні спостережувані GHZ, такі як парність, колективний або заселеності обчислювального базису. Отже, хоча помилки надобертання є когерентними та систематичними, вони фактично невидимі для вимірювань, які використовуються для оцінки точності GHZ. У цьому сенсі схема GHZ має випадковий захист когерентності: певні когерентні помилки CX комутують зі структурою підготовлюваного стану і тому не погіршують виміряну продуктивність.
Паулі-твірлінг докорінно змінює цю ситуацію. Твірлінг не зберігає когерентну помилку надобертання як детермінований процес . Натомість він перетворює когерентний канал помилок на ефективний стохастичний канал Паулі. Як наслідок, канал помилок тепер містить такі члени, як , , та , які не комутують зі стабілізаторами GHZ.
Коли трапляються ці стохастичні помилки Паулі, вони створюють реальні збої інверсії біта та інверсії фази на окремих кубітах або парах кубітів. Ці помилки виводять стан за межі підпростору стабілізатора GHZ, зменшують інтерференцію між та і безпосередньо знижують точність GHZ та сигнали парності багатьох кубітів. Іншими словами, Паулі-твірлінг усуває когерентну структуру помилки, але водночас усуває й скасування на основі симетрії, яке раніше робило ці помилки нешкідливими. Результатом є дещо гірший стан GHZ — не тому, що твірлінг додає шум, а тому, що він перетворює здебільшого нешкідливу когерентну помилку на справді шкідливі стохастичні помилки.
Цей приклад підкреслює важливий урок: Паулі-твірлінг не є універсальною стратегією покращення. Він найкорисніший, коли когерентні помилки накопичуються в схемі таким чином, що це руйнує необхідну точність. У високосиметричних схемах, як-от підготовка стану GHZ, деякі когерентні помилки природно узгоджені зі стабілізаторами стану, і навмисна рандомізація може усунути цей випадковий захист.
Поєднання методів
У принципі можна поєднати Паулі-твірлінг з динамічним розв'язанням (DD). Ми не використовували DD у цьому випадку з двох причин: по-перше, у цій схемі не повинно бути надзвичайно довгих періодів простою. По-друге, стани GHZ зберігають більшу частину своєї інформації не в однокубітній фазовій когерентності, особливо якщо ми спостерігаємо точність лише за кількістю бітових рядків, а не за фазою між бажаними бітовими рядками та .
Якби ми розширили підготовку GHZ до 100+ кубітів, то затримки у вимірюванні перших/ранніх кубітів справді могли б бути достатньо довгими, щоб DD стало корисним. Це особливо справедливо, якщо врахувати транспільовану глибину схеми.
Паулі-твірлінг у структурі відлуння RTZ
Наш останній приклад Паулі-твірлінгу в контексті зменшення накопичення когерентних помилок використовує схему з шарами комбінацій X-CZ-X-CZ. Це добре відома послідовність вентилів, яку часто використовують для скасування членів когерентної помилки ZZ у двокубітних вентилях, навіть без твірлінгу. Але з твірлінгом ми можемо зменшити або рандомізувати інші форми накопичення когерентних помилок.
Почнемо з визначення функції для побудови схем, подібних до RTZ, з різною кількістю шарів.
from qiskit import QuantumCircuit

def rtz_echo_circuit(n_qubits: int, depth: int) -> QuantumCircuit:
    """
    Construct an RTZ echo-style circuit.

    Args:
        n_qubits: Number of qubits in the circuit.
        depth: Number of repeated echo layers.

    Returns:
        A QuantumCircuit implementing the echo sequence with measurements.
    """
    q = QuantumRegister(n_qubits, "q")
    c = ClassicalRegister(n_qubits, "c")
    qc = QuantumCircuit(q, c)

    for _ in range(depth):
        qc.h(q)

        for i in range(0, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.x(q)

        for i in range(1, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.h(q)

    qc.measure(q, c)
    return qc
Тепер побудуємо схеми зі зростаючою кількістю шарів, аж до певної розумної загальної транспільованої двокубітної глибини.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

circuits = []
qcs = []
depths = list(range(3, 27, 4))
n_qubits = 10

opt_level = 0
pm = generate_preset_pass_manager(
    optimization_level=opt_level,
    backend=backend,
    initial_layout=[0, 1, 2, 3, 4, 5, 6, 7, 8, 9],
)

for d in depths:
    qc = rtz_echo_circuit(n_qubits, d)
    qcs.append(qc)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
# We can check the 2-qubit depths of any of our circuits like this:
two_qubit_depths = []
for n in range(len(circuits)):
    two_qubit_depths.append(
        circuits[n].decompose().depth(lambda instr: len(instr.qubits) > 1)
    )
print(two_qubit_depths)
[6, 14, 22, 30, 38, 46]
qcs[0].draw("mpl")
# circuits[0].draw("mpl")
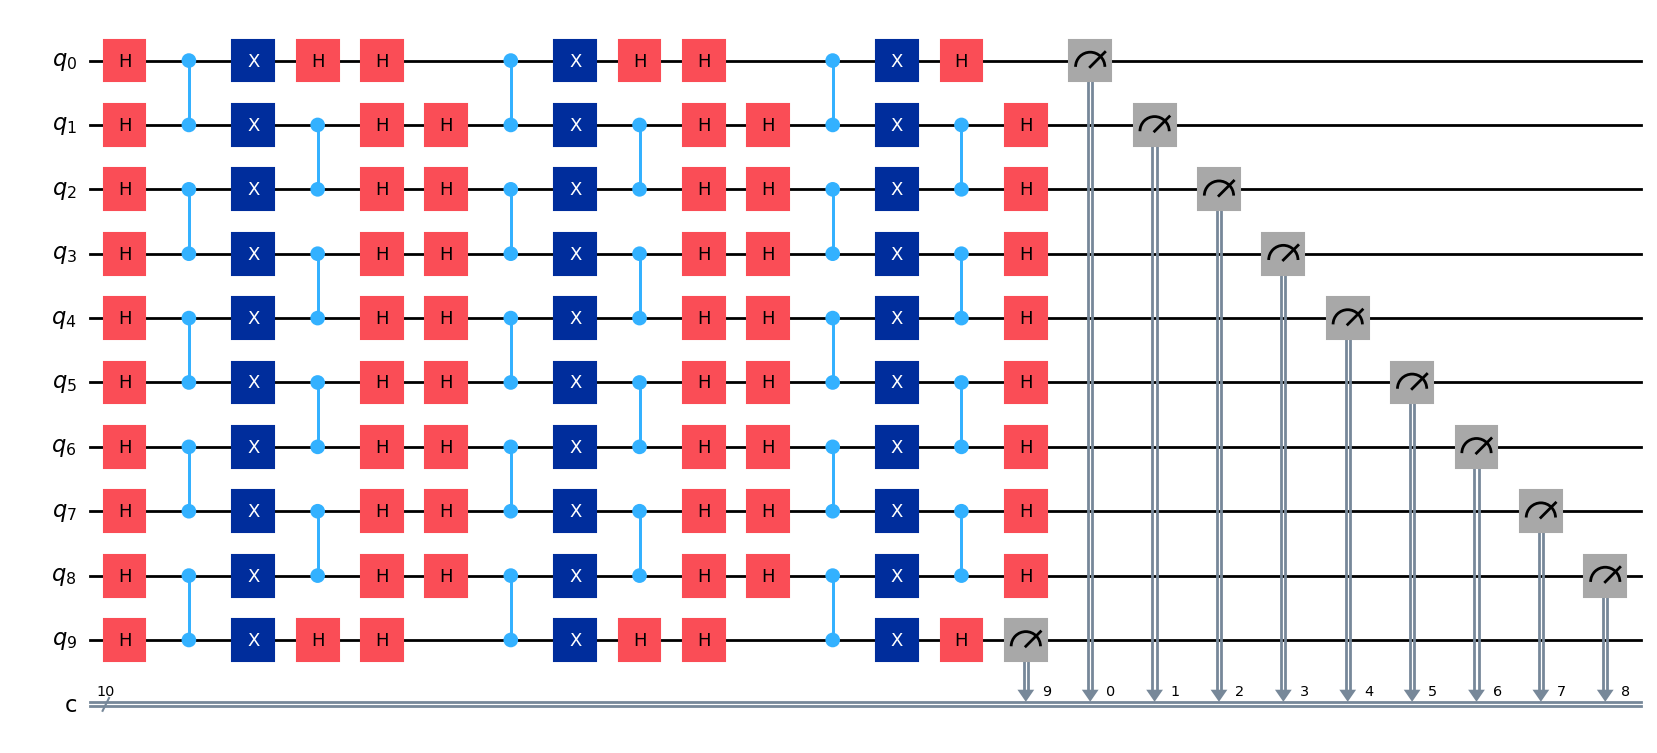
На верхній межі деякі з них досить глибокі. Використаємо AerSimulator без моделі шуму, щоб отримати ідеальні стани в кінці кожної з цих схем. Потім ми зможемо порівняти наші результати з реальних квантових комп'ютерів, використовуючи точність Хелінгера.
from qiskit_aer import AerSimulator

sim = AerSimulator()
ideal_results = sim.run(circuits, shots=8192).result()
ideal_counts = ideal_results.get_counts()
Тепер визначимо SamplerV2 з твірлінгом та без нього.
from qiskit_ibm_runtime import SamplerV2 as Sampler

shots = 8192

# --- No Twirling ---
sampler_no = Sampler(mode=backend)
sampler_no.options.twirling.enable_gates = False
sampler_no.options.twirling.enable_measure = False
sampler_no.options.default_shots = shots

# --- With Twirling ---
sampler_tw = Sampler(mode=backend)
sampler_tw.options.twirling.enable_gates = True
sampler_tw.options.twirling.enable_measure = False
# sampler_tw.options.twirling.num_randomizations = "auto"
sampler_tw.options.twirling.num_randomizations = 32
sampler_tw.options.twirling.strategy = "active-circuit"
sampler_tw.options.default_shots = shots
Тепер запустимо наші завдання.
# Each job took 17 sec (34 sec total) on ibm_fez. Your times might vary.

job_no = sampler_no.run(circuits)
job_tw = sampler_tw.run(circuits)

res_no = job_no.result()
res_tw = job_tw.result()
Отримаємо підрахунки з кожного запуску на реальному квантовому комп'ютері.
counts_no = [r.data.c.get_counts() for r in res_no]
counts_tw = [r.data.c.get_counts() for r in res_tw]
Тепер знайдемо точність Хелінгера, порівнюючи кожен із цих запусків із результатами AerSimulator без шуму.
from qiskit.quantum_info import hellinger_fidelity

f_no = [hellinger_fidelity(counts_no[i], ideal_counts[i]) for i in range(len(circuits))]

f_tw = [hellinger_fidelity(counts_tw[i], ideal_counts[i]) for i in range(len(circuits))]
Тепер візуалізуємо наші результати.
import matplotlib.pyplot as plt

plt.figure(figsize=(8, 5))
plt.plot(two_qubit_depths, f_no, "o-", label="No Twirling")
plt.plot(two_qubit_depths, f_tw, "o-", label="With Twirling")
plt.xlabel("Two-qubit transpiled depth")
plt.ylabel("Hellinger Fidelity")
plt.title("RTZ Echo Circuit: Twirling vs No Twirling")
plt.legend()
plt.grid(True)
plt.show()
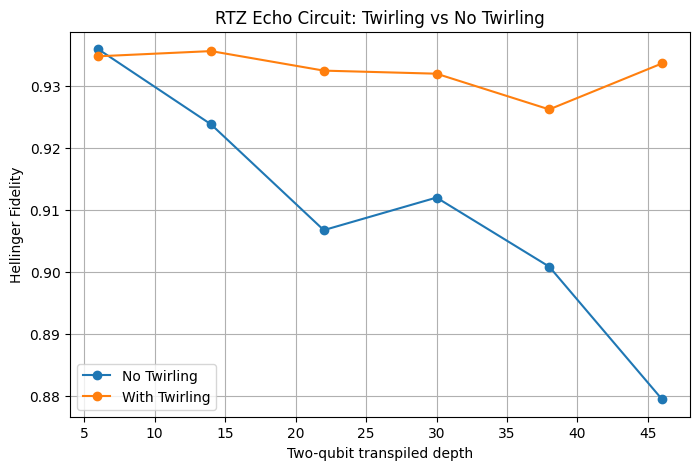
Протягом цього уроку ми розглянули випадки, коли Паулі-твірлінг використовується для обмеження накопичення когерентних помилок — контекст, у якому його можна описати як придушення помилок. Однак Паулі-твірлінг часто корисніший як інструмент для зміни поведінки помилок, що перетворює когерентні помилки на форму, яку легше передбачити та змоделювати. Корисність цього стане більш очевидною в контексті методів пом'якшення помилок, таких як екстраполяція до нульового шуму (ZNE), які покладаються на достатньо передбачуване масштабування шуму. Це обговорюється в наступному уроці.