Шум і помилки
Цей урок познайомить вас із квантовим шумом та помилками, включаючи багато джерел їх виникнення, проводячи аналогії з класичними помилками. Розуміння типів помилок, які можуть виникати, і здатність моделювати шум за допомогою квантових каналів, буде критично важливим для розуміння наступних уроків. Дійсно, більшість методів обробки помилок вимагають, щоб ми знали щось про тип шуму або помилок, які прагнемо зменшити чи виправити.
Це відео дає огляд шуму та помилок і наводить кілька обчислювальних результатів. Текст нижче додає більше деталей і досліджує деякі типи помилок за допомогою Qiskit.
Причини
Класичний шум і помилки
Щоб зрозуміти квантові помилки та шум, почнемо з класичного аналога. Помилки виникають у класичних комп'ютерах з різних причин, зокрема через численні механізми накопичення паразитного заряду, одиничні збої (single-event upsets) та повільну деградацію матеріалів. Деякі з цих механізмів (не всі) мають аналоги в квантових обчисленнях і будуть корисними для розуміння квантових помилок і шуму. Ми коротко розглянемо декілька з них, а потім перейдемо до квантових аналогів.
Тепловий шум:
У міру нагрівання компонентів комп'ютера тепловий рух атомів і носіїв заряду змінює питомий опір матеріалу (зазвичай збільшуючи його). Це означає, що опір у схемі може змінюватися. Хоча це трапляється рідко, це може призвести до паразитного логічного переходу в транзисторі. Хоча незначні коливання неминучі, належне охолодження компонентів є ключовим для уникнення цих ефектів.
Теплове пошкодження та деградація:
Повторюване нагрівання та охолодження матеріалів може спричинити дуже повільну міграцію провідних елементів (металів). У найкращому випадку це змінює опір або ємність (або обидва) елементів схеми та призводить до неточності часових характеристик роботи схеми. У найгіршому випадку це призводить до короткого замикання або жорсткої несправності. Знову ж таки, належний контроль температури є ключовим для запобігання цьому типу деградації.
Радіаційно-індуковані ефекти (одиничні збої, SEU):
Іноді високоенергетичні частинки можуть іонізувати атоми всередині процесора та спричинити паразитний заряд. Якщо це трапляється в неправильному місці та в неправильний час, це може призвести до логічних помилок. Джерелом цих високоенергетичних частинок (включно з електромагнітним випромінюванням і нейтронами) зазвичай є високоенергетичні взаємодії у верхніх шарах атмосфери. Тому такі збої частіше трапляються у високогірних середовищах, зокрема в космосі. Ця проблема вирішується за допомогою кодів, що виправляють помилки, та радіаційно-стійкої конструкції.
Електромагнітні перешкоди:
Помилки також можуть бути спричинені зовнішніми електромагнітними (ЕМ) полями від комутації силових ліній, радіопередавачів або інших компонентів системи. Це відрізняється від високоенергетичного випромінювання в попередньому явищі. Тут блукаючі часозалежні ЕМ поля індукують струм і напругу в обчислювальних компонентах (на відміну від іонізації конкретного атома в одній події). Оскільки часова залежність полів є визначальним фактором індукованих напруг, цей тип перешкод особливо важливий у високочастотних системах. Ці помилки можна побороти за допомогою екранування та заземлення, серед іншого.
Перехресні завади між з'єднаннями:
Ємнісний або індуктивний зв'язок між сусідніми провідниками, особливо в наномасштабних інтегральних схемах, може призводити до паразитних сигналів. Це пов'язано з електромагнітними перешкодами, але відрізняється тим, що джерелом небажаного поля є інший компонент усередині схеми комп'ютера. Уявіть два дроти, розташовані дуже близько один до одного. Якщо в дроті A відбувається раптовий перехід (зміна напруги), це може індукувати струми в сусідньому дроті B. Точний напрямок і величина залежать від топології схеми; це може бути когерентний чистий потік заряду або щось ближче до вихрових струмів заряду. Але в деяких випадках це може призвести до небажаних логічних переходів. Ці ефекти перехресних завад можна пом'якшити за допомогою оптимального розташування елементів, екранування та контрольованого часу наростання сигналу.
Це не повний список, але його достатньо, щоб почати бачити паралелі з квантовими обчисленнями. Зауважте, що в усіх наведених вище типах небажаних взаємодій прояв шуму як логічної помилки може набувати лише форми перетворення 0 на 1 або 1 на 0. Це все, що дозволено у просторі станів класичних бітів.
Квантовий шум і помилки
У квантових обчисленнях шум і помилки часто обговорюються разом, але важливо розрізняти ці поняття. Квантовий шум означає базове фізичне збурення, що впливає на кубіти та квантові системи. Він включає всі форми небажаних взаємодій або флуктуацій з навколишнього середовища, недосконалого керування або апаратних дефектів, які спричиняють відхилення квантового стану від ідеального. Квантові помилки — це конкретні відхилення або збої в квантовій інформації, що виникають внаслідок квантового шуму. Квантові помилки є вимірюваними чи операційними проявами шуму, і до них належать перевороти бітів (bit-flips), перевороти фази (phase-flips), амплітудне затухання та інше. І шум, і помилки можуть відбуватися безперервним чином. Наприклад, поле, що використовується в квантовому вентилі, може відхилятися на 0,1%, 0,15% або будь-яку іншу частку. Це може призвести до неправильної фази кубіта, також на будь-яку неперервну величину. Але ви побачите, що на практиці, особливо у виправленні помилок, поширено розглядати помилки так, ніби вони дискретні: групуючи накопичені ефекти в дискретний переворот біта або одне обертання фази. Це корисно для виправлення помилок і їх характеризації, але це не означає, що вплив шуму на кубіт є виключно дискретним набором помилок.
Існує багато типів шуму, що впливають на квантові комп'ютери. Деякі можуть призводити до кількох типів помилок, тоді як інші пов'язані з конкретними проявами помилок. Повний список виходить за межі цього уроку; ось частковий список, релевантний для решти цього курсу, деякі пункти якого мають паралелі з класичним обчислювальним шумом.
Thermal:
Два обчислювальні базисні стани і кубіта розділені дуже малою кількістю енергії. Точне значення, звісно, залежить від квантового обладнання. Для твердотільних кубітів (трансмонів з фіксованою частотою), таких як ті, що використовуються IBM Quantum®, енергетичний розрив між цими станами має порядок Дж, або кілька мікроелектрон-вольт. Цей енергетичний масштаб можна пов'язати з частотою через або з характерною температурою. Оскільки температура пов'язана із середньою кінетичною енергією частинок у зразку, ми можемо використати сталу Больцмана, щоб отримати оцінку температури, за якої середні частинки матимуть достатньо енергії для здійснення переходу:
Щоб зменшити ймовірність того, що теплові взаємодії спричинять переходи з одного обчислювального базисного стану кубіта в інший, температура кубітів повинна підтримуватися значно нижче 100 мК, в ідеалі ближче до 15-25 мК. Будь-яке значне підвищення температури понад ці порогові значення призведе до повністю випадкового заселення станів і повної втрати квантової інформації.
Це аналогічно тепловим помилкам, які можуть виникати в класичних комп'ютерах, оскільки обидва мають теплове походження — але температурний масштаб, очевидно, інший, як і механізм втрати інформації.
Перехресні завади та перешкоди:
Перехресні завади (crosstalk) у квантових обчисленнях означають будь-який небажаний зв'язок або перешкоди між кубітами чи керуючими лініями, через які операція або сигнал, призначений для одного кубіта, ненавмисно впливає на інші. Це проявляється як помилки або кореляції між кубітами, які в ідеалі мають бути незалежними.
В архітектурах надпровідних кубітів, подібних до тих, що використовує IBM®, перехресні завади можуть виникати через витік мікрохвильових керуючих сигналів у сусідні кубіти, ненавмисний зв'язок між резонаторами зчитування або потокові перехресні завади між контурами кубітів.
Багато підходів до мінімізації перехресних завад закладені в конструкцію квантового комп'ютера, наприклад, розташування кубітів на відстані та забезпечення того, щоб сусідні кубіти мали різні робочі частоти. Існують також програмні підходи до пом'якшення помилок перехресних завад, які будуть розглянуті в наступних уроках.
Недосконалі операції вентилів:
Операції над кубітами виконуються за допомогою обладнання, яке має обмежену точність і може бути піддане шуму чи іншим джерелам неточності. Зокрема, для реалізації вентилів обертання використовуються мікрохвильові імпульси певної тривалості та з певною орієнтацією. Скажімо, наприклад, що мікрохвильовий імпульс має обернути на 0,30 радіана навколо осі . Існує обмежена точність орієнтації, що призводить до певної неточності осі обертання. Крім того, завжди існує фундаментальний компроміс між частотою імпульсу та його тривалістю. Дуже довгий імпульс може мати по суті синусоїдальну поведінку з практично єдиною частотою. Щоб сформувати короткий пакет, потрібна суперпозиція багатьох частот. Це той самий компроміс, що лежить в основі співвідношення невизначеності енергія-час, хоча точність вентилів ще не впирається в ці фундаментальні межі; є простір для покращення.
Шум, притаманний квантовій природі:
Цей останній тип шуму суттєво відрізняється від інших; він виникає не через помилки, а через саму природу квантової механіки. Припустимо, кубіт у квантовому стані вимірюється і колапсує до власного стану ( або ). У системі трансмона з фіксованою частотою кубіт дисперсійно пов'язаний з мікрохвильовим резонатором, резонансна частота якого злегка залежить від стану кубіта. Через резонатор пропускається мікрохвильовий зондувальний імпульс, і вихідний сигнал набуває залежного від стану фазового зсуву та зміни амплітуди. Потім цей сигнал підсилюється та вимірюється за допомогою класичної електроніки.
На квантовому рівні вимірювальний сигнал переноситься когерентним мікрохвильовим полем зі скінченною середньою кількістю фотонів. Через квантову природу електромагнітних полів квадратури поля демонструють внутрішні флуктуації. Ці флуктуації не залежать від технічних недосконалостей і виникають навіть для ідеального когерентного стану. Збільшення середньої кількості фотонів збільшує вимірювальний сигнал, але фундаментальний рівень шуму залишається скінченним, тому розрізнюваність результатів покращується лише як .
Таким чином, навіть якщо кубіт ідеально підготовлений, а вимірювальний ланцюг є ідеальним, сигнал зчитування, що відповідає певному стану кубіта, є не єдиним фіксованим значенням, а розподілом, який обмежує те, наскільки добре можна розрізнити результати. Це перекриття є фундаментальним джерелом невизначеності самого процесу вимірювання. На практиці, хоча технічний шум від підсилювачів та інших компонентів часто домінує, цей внутрішній квантовий шум встановлює нижню межу точності зчитування.
Невизначеність — це не помилка:
Усі ці джерела шуму відрізняються від фундаментальної невизначеності, пов'язаної з вимірюваннями квантових станів. Для порівняння, припустимо, що у нас є кубіт у квантовому стані:
Цей стан має 64% ймовірність бути виміряним у стані і 36% ймовірність бути виміряним у стані . Але одне вимірювання дасть лише або — тому одне вимірювання рідко скаже нам багато про стан до вимірювання. Потрібно багато вимірювань, щоб отримати детальну інформацію про стан. З десяти вимірювань ми можемо очікувати, що шість чи сім дадуть . Але не буде шокуючим, якщо перші десять вимірювань випадково дадуть (подібно до підкидання чесної монети та отримання «орла» десять разів поспіль: рідкісно, але цілком можливо). Якщо ми повторимо вимірювання 1000 разів і завжди отримаємо , це справді було б шокуючим.
Тому в наших знаннях про квантовий стан, отриманих на основі будь-якої скінченної кількості вимірювань, завжди присутня невизначеність. У міру повторення вимірювань наші знання про квантовий стан до вимірювання покращуються, але ніколи не стають ідеальними. Можна розмовно сказати, що в будь-якому результаті квантового вимірювання завжди є якась базова «помилка». Але це інше використання терміна «помилка», і краще описувати це як статистичну невизначеність. Процес збільшення знань про квантовий стан за допомогою багатьох вимірювань називається томографією квантового стану. Однак томографія квантового стану не обмежується вимірюваннями вздовж Z; вона зазвичай означає вимірювання вздовж ортогональних осей (таких як X, Y і Z) для визначення амплітуд і відносної фази. Докладніше про цей процес див. цей розділ у курсі Джона Ватруса про загальне формулювання квантової інформації, або для практичної реалізації див. цей урок з телепортації курсу про квантові обчислення корисного масштабу.
Спостереження помилок та їх накопичення
У цьому розділі ми використаємо реальні квантові комп'ютери, щоб спостерігати квантові помилки та їх накопичення за різних умов. На практиці зазвичай одночасно присутні багато джерел квантових помилок. Щоб спостерігати різні типи помилок у певною мірою ізольований спосіб, нам знадобляться схеми, розроблені саме для такої ізоляції. Схеми, що використовуються в застосуваннях квантових обчислень, виглядатимуть набагато складнішими.
Почнемо з помилок енергетичної релаксації.
Помилки енергетичної релаксації ()
Пригадаємо з нашого обговорення теплового шуму, що за будь-якої ненульової температури існує певна ймовірність того, що квантова система зазнає переходу між енергетичними власними станами. Релаксація () домінує, оскільки вона зумовлена спонтанним випромінюванням (незалежним від температури), тоді як низька температура пригнічує конкуруючий процес збудження. Чим довше кубіт залишається неактивним, тим більше часу в нього є для здійснення такого переходу. Ймовірність того, що кубіт, підготовлений у стані , залишається у стані після часу , задається формулою
Тут час — це експериментально визначений характерний час, який відрізняється для кожного кубіта і навіть може дещо змінюватися з часом. Квантові комп'ютери IBM® регулярно піддаються бенчмаркінгу, тому значення часу , які ви знайдете вказаними для кубітів на квантових комп'ютерах IBM, мають бути точними та актуальними. Велике значення означає, що кубіт залишається у підготовленому стані довше (у середньому). Типові значення відрізняються залежно від архітектури; кубіти в квантових комп'ютерах IBM часто мають час порядку 200-300 , і ви можете перевірити останні значення на сторінці Обчислювальні ресурси.
Характерний час вимірює дещо інше: втрату фазової інформації. Ми повернемося до цього пізніше.
Щоб спостерігати помилки енергетичної релаксації, ми підготуємо кубіти у стані , а потім навмисно залишимо їх неактивними на тривалий час. Це штучна частина. У реальних квантових робочих процесах у вас може бути кілька кубітів, що залишаються неактивними протягом тривалого часу, поки на інших кубітах виконуються процеси; тому кілька випадків таких періодів простою не є штучними.
Почнемо з імпортування деяких пакетів і вибору найменш завантаженого бекенду.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"cycler": "cycler", "matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_runtime import QiskitRuntimeService
import numpy as np
import matplotlib.pyplot as plt

# If your credentials are already saved locally
service = QiskitRuntimeService()

# To load an unsaved instance, uncomment the line below
# service = QiskitRuntimeService(channel = "ibm_quantum_platform", instance = "your crn here")

# To select the least-busy backend:
# backend = service.least_busy(simulator=False, operational=True)

# To specify the backend by name:
backend = service.backend("ibm_boston")

props = backend.properties()
print(backend)
<IBMBackend('ibm_boston')>
Тепер ми виберемо кубіт для роботи, у цьому випадку кубіт нуль. Ми можемо безпосередньо імпортувати властивості цього кубіта, включно з та .
qubit_idx = 0
qubit_props = props.qubit_property(qubit_idx)

t1 = qubit_props["T1"][0]  # * 1e6  # Convert seconds to µs
t2 = qubit_props["T2"][0]  # * 1e6  # Convert seconds to µs

# print(f"Qubit {qubit_idx}: T1={t1} µs, T2={t2} µs")
print(f"Qubit {qubit_idx}: T1={t1} s, T2={t2} s")
Qubit 0: T1=0.0002737016180018049 s, T2=0.00042784777605680494 s
Знання в одиницях мікросекунд є важливим, але у вас може не бути інтуїтивного відчуття того, що це означає. Зрештою, операції вентилів на квантових комп'ютерах виконуються дуже швидко. Справжнє питання: скільки ми можемо зробити на квантовому комп'ютері за цей час. З цією метою корисно співвіднести з іншими часовими масштабами, що використовуються в квантових обчисленнях — зокрема з такими:
-
час дискретизації — найменший такт годинника, за який на квантовому комп'ютері можуть бути реалізовані керуючі процеси.
-
часи однокубітних вентилів — час, необхідний для реалізації операції вентиля на одному кубіті. Це буде не єдине значення, а діапазон можливих чисел залежно від типу вентиля.
-
часи двокубітних вентилів — час, необхідний для реалізації операції вентиля на двох сусідніх кубітах. Це також може набувати діапазону значень, але зазвичай приблизно на порядок довше, ніж для однокубітного вентиля.
Перевіримо для нашого бекенду та відобразимо кілька правдоподібних діапазонів часів вентилів.
print(f"Using backend: {backend.name}")

# Access the backend target
target = backend.target

def get_gate_times(target, gate_name):
    results = []

    if gate_name not in target:
        return results  # gate not supported

    # target[gate_name] is a dict: {(qubits): InstructionProperties}
    for qubits, props in target[gate_name].items():
        if props.duration is not None:
            results.append({"qubits": qubits, "duration_ns": props.duration * 1e9})

    return results

# Query some gates
for gate in ["cz", "x"]:
    times = get_gate_times(target, gate)

    print(f"\nGate: {gate}")
    if times:
        for entry in times[:5]:
            print(f"  Qubits {entry['qubits']}: {entry['duration_ns']:.2f} ns")
    else:
        print("  Not available on this backend")
Using backend: ibm_boston

Gate: cz
  Qubits (0, 1): 68.00 ns
  Qubits (1, 0): 68.00 ns
  Qubits (1, 2): 68.00 ns
  Qubits (2, 1): 68.00 ns
  Qubits (2, 3): 88.00 ns

Gate: x
  Qubits (0,): 32.00 ns
  Qubits (1,): 32.00 ns
  Qubits (2,): 32.00 ns
  Qubits (3,): 32.00 ns
  Qubits (4,): 32.00 ns
Ці часи вентилів варіюватимуться від бекенду до бекенду. Ми жорстко закодуємо час двокубітного вентиля, отриманий з ibm_boston, що становить 68 нс.
dt = backend.configuration().dt
two_q_gate_time = 68e-9
print("The sampling time is : ", dt)
print("dts per T_1 : ", t1 / dt)
print("2-qubit characteristic time : ", two_q_gate_time)
print("The sampling time intervals per two-qubit gate : ", two_q_gate_time / dt)
print("2-qubit gates per T_1 : ", t1 / two_q_gate_time)
The sampling time is :  4e-09
dts per T_1 :  68425.40450045122
2-qubit characteristic time :  6.8e-08
The sampling time intervals per two-qubit gate :  17.0
2-qubit gates per T_1 :  4025.0237941441897
Майте на увазі, що тут не враховано жодні інші джерела помилок, а також їх придушення чи пом'якшення. Помилки не є єдиними помилками, що діють у квантовій системі, тому не варто надто хвилюватися через ці числа. Це просто означає, що за відсутності будь-якого придушення ми могли б правдоподібно реалізувати порядку тисяч двокубітних вентилів, перш ніж помилки почнуть домінувати. Інші помилки зазвичай домінуватимуть на набагато меншій глибині, і навпаки, помилки все ще можуть бути варті придушення за значно коротших часів, ніж ті, що потрібні для повного розмиття сигналу.
Ми почнемо з використання симулятора з моделлю шуму, а потім порівняємо результати з реальним обладнанням.
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, thermal_relaxation_error
from qiskit import QuantumCircuit
from qiskit.quantum_info import Pauli
from qiskit.transpiler import generate_preset_pass_manager
from qiskit_aer.primitives import EstimatorV2

pass_manager = generate_preset_pass_manager(backend=backend, optimization_level=0)
Визначимо крок часу для наших вимірювань, що відповідає верхній оцінці часу двокубітного вентиля. Потім ми побудуємо 50 схем з кроком, рівним цьому часовому кроку. Таким чином ми побачимо, що відбувається протягом часового масштабу, подібного до реалізації 80 двокубітних вентилів. Точність тут не є критичною, тому ми використаємо лише невелику кількість запусків (shots).
n_points = 50  # We will show 50 steps
delay_unit = 80  # The delay in units of two-qubit-time from above
shots = 100
Ми будуємо модель шуму для нашого симулятора, яка явно включає помилки теплової релаксації.
# Create noise model with thermal relaxation for delays
noise_model = NoiseModel()
error = thermal_relaxation_error(
    t1, t2, two_q_gate_time * delay_unit
)  # error model characterized by times in ns
noise_model.add_all_qubit_quantum_error(error, ["delay"])

sim = AerSimulator(noise_model=noise_model)
Тепер ми будуємо наші схеми та спостережувані величини. Вони надзвичайно прості. Схеми будуть просто складатися з підготовки кубіта у стані та реалізації затримок на дедалі більші періоди часу, використовуючи характерні часи вентилів і , визначені вище. Спостережуваними будуть просто , оскільки те, що ми хочемо знати, — це чи залишився кубіт у стані , чи розпався до . Хоча транспіляція не завжди необхідна для симуляторів, ми все ж транспілюємо наші схеми тут для подальшого використання на реальному бекенді.
observables = [Pauli("Z")] * n_points
circuits = []
obs = []
delay_times_sim = []
for i in range(n_points):
    qc = QuantumCircuit(1, 1)
    qc.x(0)
    if i > 0:
        for j in range(i):
            qc.delay(delay_unit * two_q_gate_time, 0, "s")
            j = j + 1
    qc_opt = pass_manager.run(qc)
    circuits.append(qc_opt)
    delay_times_sim.append(delay_unit * two_q_gate_time * i)
    observables_isa = observables[i].apply_layout(layout=qc_opt.layout)
    obs.append(observables_isa)
Ми запускаємо наше завдання за допомогою симулятора.
pubs = list(zip(circuits, obs))

# Create AerSimulator with noise model as backend
simulator = AerSimulator(noise_model=noise_model)

# Create SamplerV2 from the AerSimulator backend
estimator = EstimatorV2.from_backend(simulator)

# Run the sampler on the circuit, specify shots
job = estimator.run(pubs)
result = job.result()
Нарешті ми будуємо графік результатів.
# Optional: color palette similar to 'mpl', style = 'clifford'

from cycler import cycler

plt.rcParams["axes.prop_cycle"] = cycler(
    color=[
        "#4C78A8",  # muted blue
        "#72B7B2",  # teal
        "#54A24B",  # green
        "#9C89CC",  # purple
        "#B279A2",  # mauve
    ]
)

# Everything else stays at Matplotlib defaults

# Example data: assume result is a list of objects with structure result[i].data.evs.item()
# and delay_times is already defined as a list of floats.

# Extract y-values
y_sim_values = [(1 - r.data.evs.item()) / 2 for r in result]

# Use delay_times as x-values
x_sim_values = delay_times_sim

# Create the plot
plt.figure(figsize=(8, 5))
plt.plot(x_sim_values, y_sim_values, marker="o", linestyle="-", label="EV Data")

plt.xlabel("Idle Time (s)")
plt.ylabel("Probability of measuring |1>")
plt.title("T1 Decay")
plt.grid(True)
plt.show()
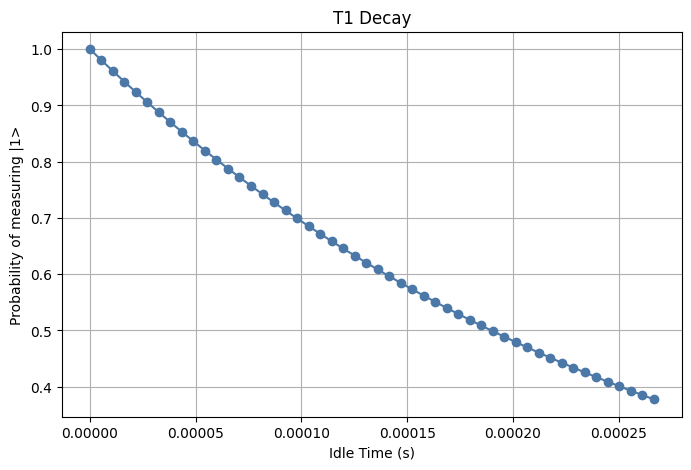
Експоненційний спад чітко видно, і за цей час він спадає до трохи менш ніж 40% ймовірності перебування у стані . Зауважте, що це точно узгоджується з моделлю: , де ми обрали максимальне такого ж порядку, як ; пригадайте, ми казали, що може відповідати 60 вентилям (або тому порядку величини), і тут відповідає 60 вентилям. Отже
Тепер запустимо ті самі схеми на реальному квантовому комп'ютері. Щоб охопити ту саму тривалість затримки з меншою кількістю завдань, ми збільшимо одиницю затримки та зменшимо кількість точок.
# This took 27 s on ibm_boston

from qiskit_ibm_runtime import EstimatorV2

# Explicitly use a pass manager with optimization level 0 so that we don't remove the delays
pass_manager = generate_preset_pass_manager(backend=backend, optimization_level=0)

# Use the same time parameters and shots
n_points = 10
delay_unit = 400
shots = 100

# Measure Pauli Z's as your observables
observables = [Pauli("Z")] * n_points
circuits = []
obs = []
delay_times = []
for i in range(n_points):
    qc = QuantumCircuit(1, 1)
    qc.x(0)
    if i > 0:
        qc.delay(delay_unit * two_q_gate_time * i, 0, "s")
    qc_opt = pass_manager.run(qc)
    circuits.append(qc_opt)
    delay_times.append(delay_unit * two_q_gate_time * i)
    observables_isa = observables[i].apply_layout(layout=qc_opt.layout)
    obs.append(observables_isa)

pubs = list(zip(circuits, obs))
estimator = EstimatorV2(mode=backend)
job = estimator.run(pubs=pubs)
result = job.result()

# To print the job id for later retrieval of data
# job_id = job.job_id()
# print(f"Job ID: {job_id}")
Тепер ми будуємо графік результатів.
fig, ax = plt.subplots()

# Convert from the expectation value of Z to the probability of a transition
y_real_values = [(1 - r.data.evs.item()) / 2 for r in result]

# Use delay_times as x-values
x_real_values = delay_times

# Exponential decay to match theoretical model
t_smooth = np.linspace(0, x_sim_values[19], 100)  # Smooth x-range covering your data
y_decay = np.exp(-t_smooth / (t1))  # y = exp(-t/t1)
ax.plot(t_smooth, y_decay, "k--", linewidth=1, label=f"Perfect Decay (t1={t1:3f} s)")

# Add simulator values
ax.scatter(x_sim_values, y_sim_values, label="Simulator", alpha=0.7)

# Add real QC values
ax.scatter(x_real_values, y_real_values, label="Real", alpha=0.7)

# Add labels and plot
ax.set_xlabel("Idle Time (s)")
ax.set_ylabel("Probability of measuring |1>")
ax.legend()
ax.set_title("T1 Decay")
ax.grid(True)

plt.show()
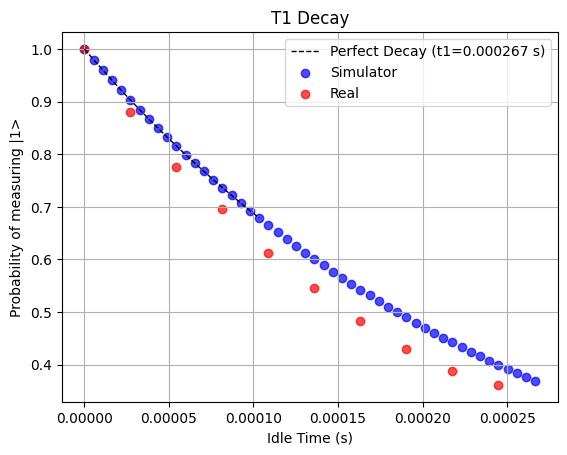
Як ми бачимо, розпад стану з часом відповідає теорії (та визначенню ). Крім того, симулятор досить добре відповідає поведінці реального квантового комп'ютера в цьому випадку. Ось кілька речей, які варто мати на увазі щодо розпаду цього стану:
- Ми штучно затримали вимірювання на нереалістично тривалий час. Ці затримки відповідають часовому масштабу надзвичайно глибоких схем, що можуть складатися з тисяч двокубітних вентилів. Це було зроблено лише для того, щоб показати, що ефекти теплового шуму існують. У реальних схемах, застосованих до реальних задач, операції виконувалися б на інших кубітах, тоді як кілька кубітів могли б залишатися неактивними достатньо довго, щоб помилки енергетичної релаксації мали значення — але інші помилки домінували б до досягнення повного .
- Жодних методів пом'якшення чи придушення помилок не було використано. Ми можемо змінити цю криву розпаду, використовуючи методи, яких навчимося в цьому курсі.
- Тут ми використали лише 100 запусків (shots), що незвично мало, оскільки ми прагнули лише показати, що ефект існує. У застосуваннях ви, ймовірно, використовуватимете понад 1000 запусків.
Ця перша візуалізація помилки не потребувала майже жодних вентилів, крім затримок (та одного вентиля X, використаного для підготовки ). Тепер розглянемо ще один приклад, зосереджений на помилках вентилів.
Помилки вентилів і накопичення
Коли ми застосовуємо квантовий вентиль, скажімо вентиль , теоретично цей вентиль обертає квантовий стан на кут радіан навколо осі на сфері Блоха, відображаючи у через
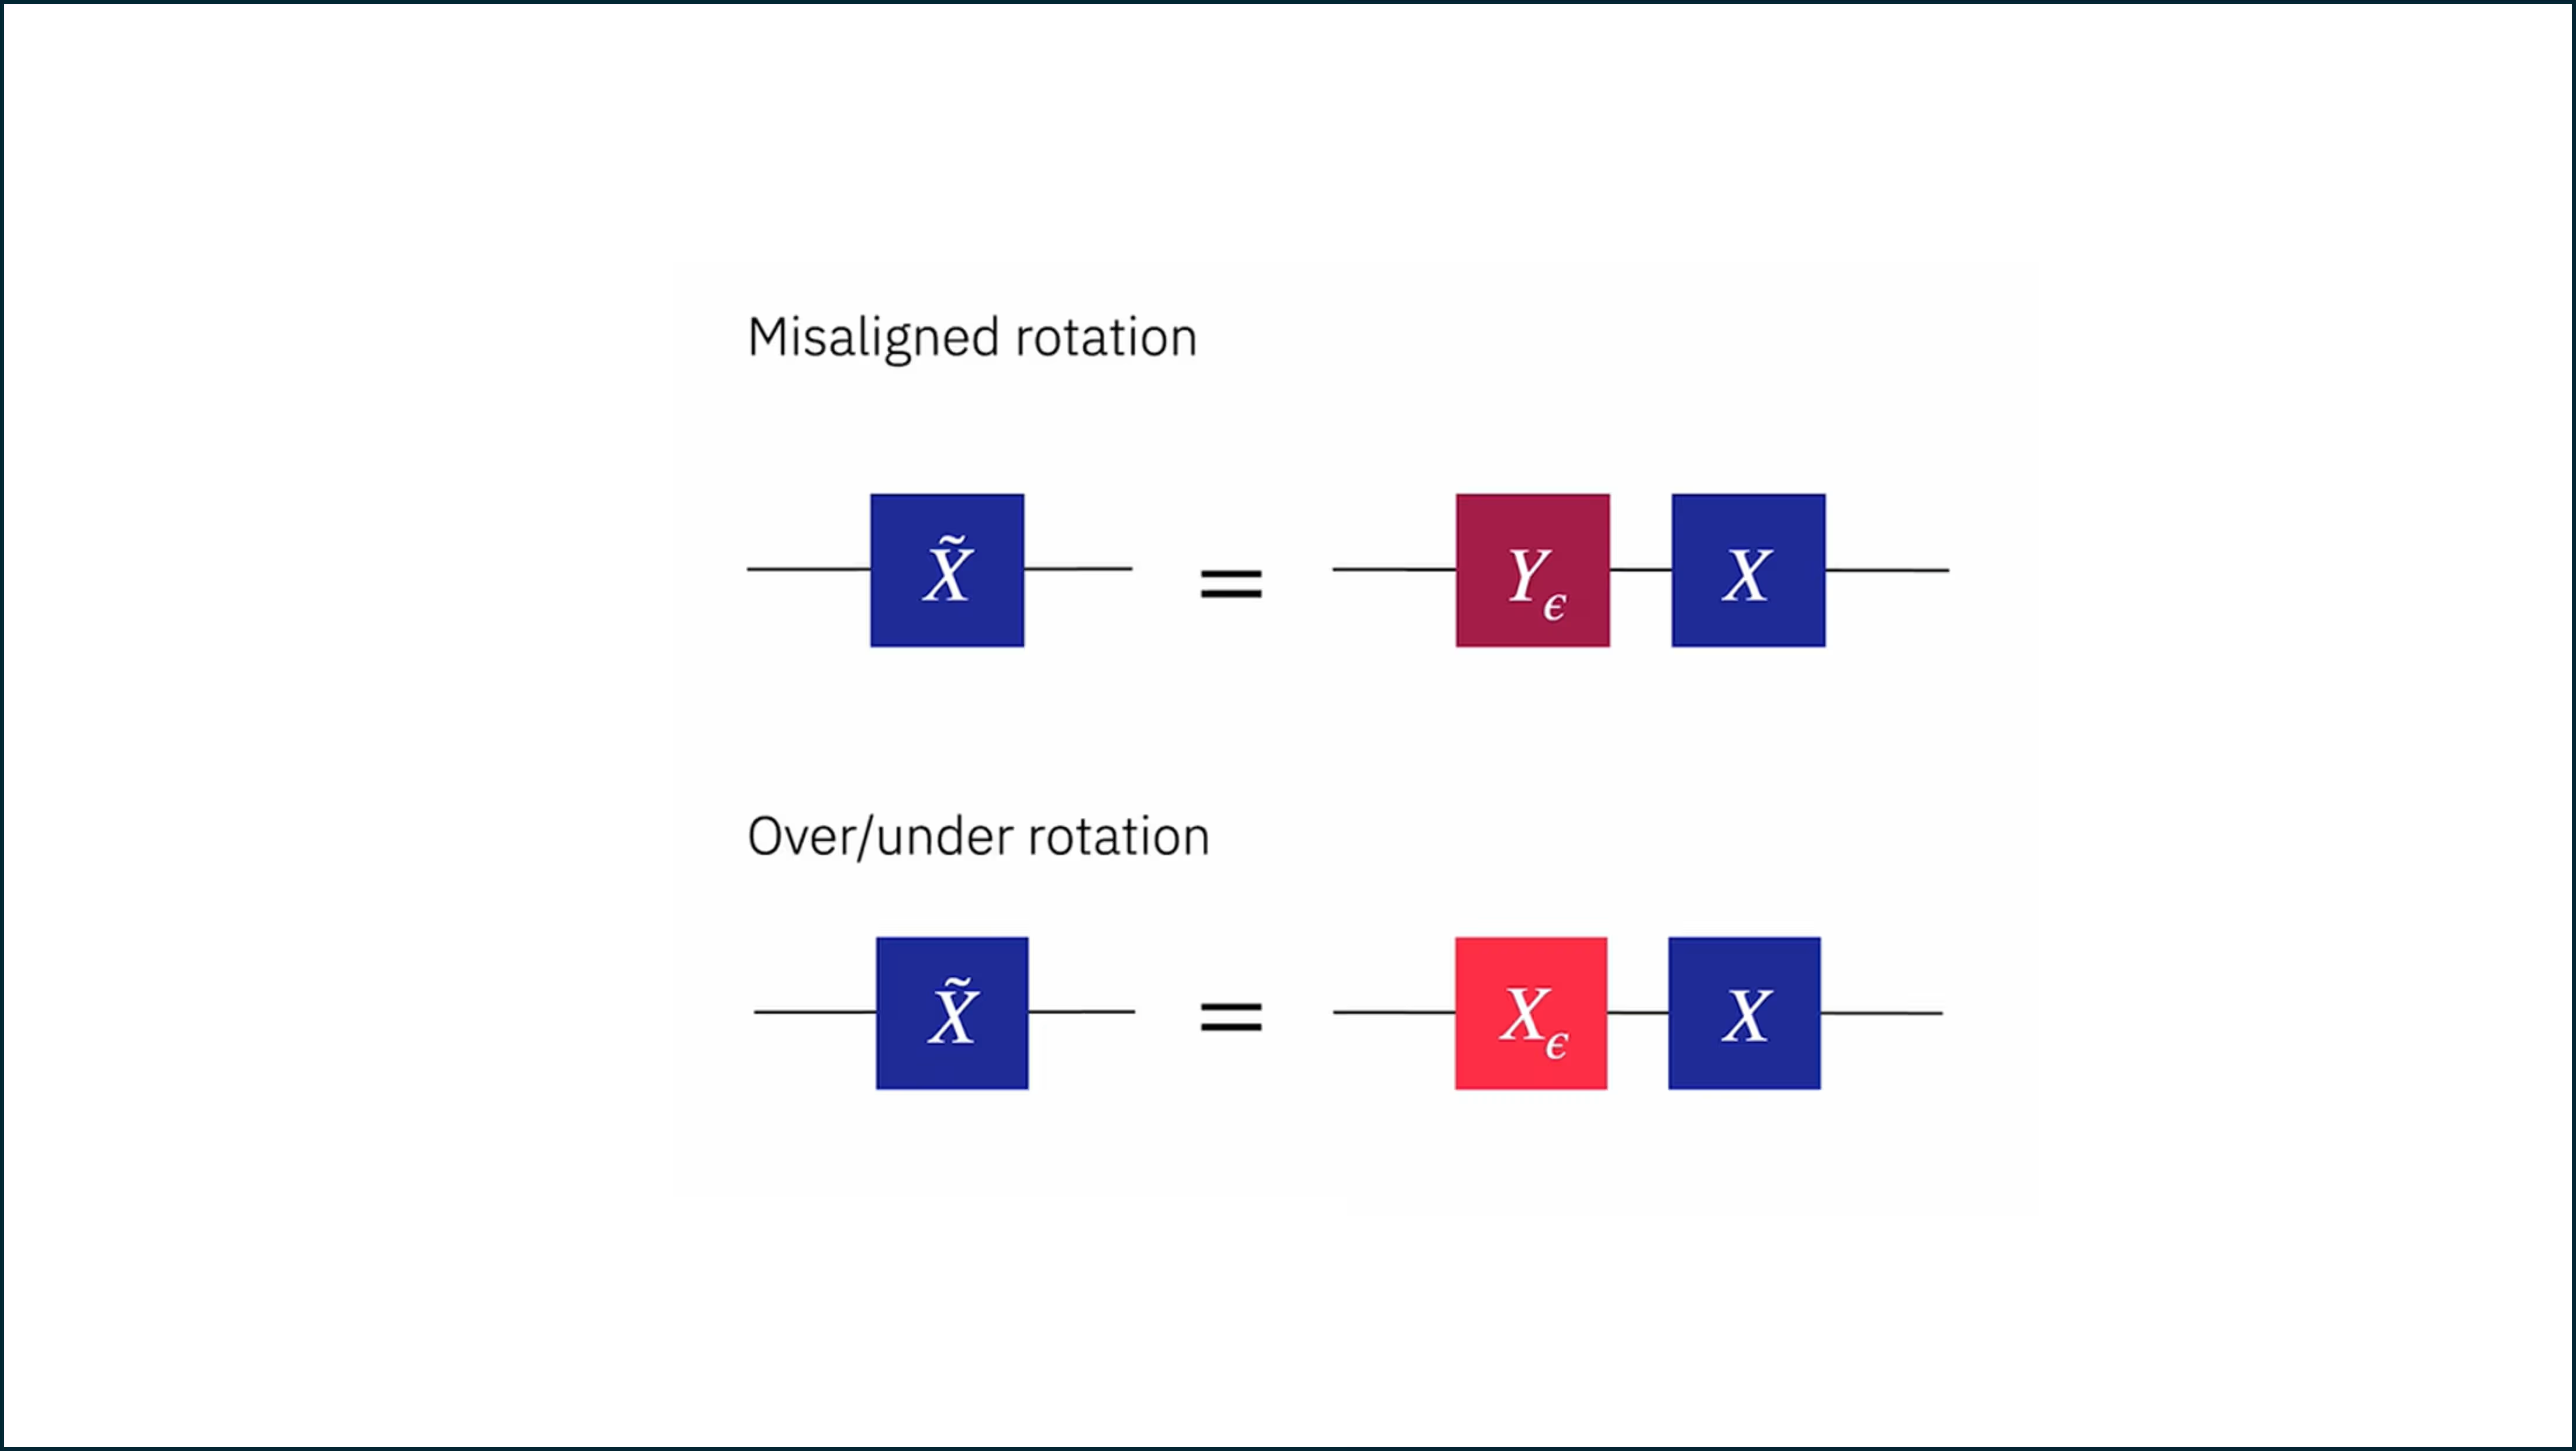
Однак реальний вентиль недосконалий. Він може бути неідеально орієнтований (що спричиняє обертання не точно навколо осі X) або може спричиняти дещо більше чи менше обертання, ніж заплановано. Змоделюймо похибку вентиля як чисте над- чи недообертання на малий кут .
Якщо недосконалий вентиль застосовується багато разів, малі похибки можуть накопичуватися. Іноді ці численні похибки навіть спричиняють зсув стану в одному й тому самому напрямку щоразу (явище, зване «когерентним накопиченням», яке ми розглянемо нижче). Подивімося, що відбувається, коли ми застосовуємо реальний вентиль X до кубіта багато разів.
# This took 78 s on penguino1

from qiskit_ibm_runtime import EstimatorV2

# Explicitly use a pass manager with optimization level 0 so that we don't remove the delays
pass_manager = generate_preset_pass_manager(backend=backend, optimization_level=0)

# Use the same bit flips
max_depth = 60
circuits = []
observables = []

for depth in range(max_depth + 1):
    qc = QuantumCircuit(1)
    # Repeat flipping back and forth depth times
    for _ in range(depth):
        #    qc.x(0)
        qc.x(0)
        qc.barrier()
        qc.x(0)
        qc.barrier()
    circuits.append(qc)
    observables.append(Pauli("Z"))

pubs = list(zip(circuits, observables))

estimator = EstimatorV2(mode=backend)
results = estimator.run(pubs=pubs).result()
real_expectations = [pub_res.data.evs for pub_res in results]
# from qiskit_ibm_runtime import QiskitRuntimeService

# service = QiskitRuntimeService()           # uses stored IBM Quantum account
# job_id = "d5immof67pic7386l8eg"

# job = service.job(job_id)                 # retrieve the job
# results = job.result()                        # this is your .result() object
# Convert from the expectation value of Z to the probability of a transition
# y_real_values = [(1-r.data.evs.item())/2 for r in results]

# Create the plot
plt.figure(figsize=(8, 5))
# plt.plot(range(max_depth + 1), y_real_values, 'o-')
# plt.plot(x_real_values, y_real_values, marker='o', linestyle='-', color='blue', label='EV Data')
plt.plot(
    range(max_depth + 1),
    real_expectations,
    marker="o",
    linestyle="-",
    color="blue",
    label="EV Data",
)

plt.xlabel("Number of Flip-Back Cycles")
plt.ylabel("Expectation ⟨Z⟩")
plt.title("Accumulated Gate Noise Effects on Flips")
plt.grid(True)
plt.show()
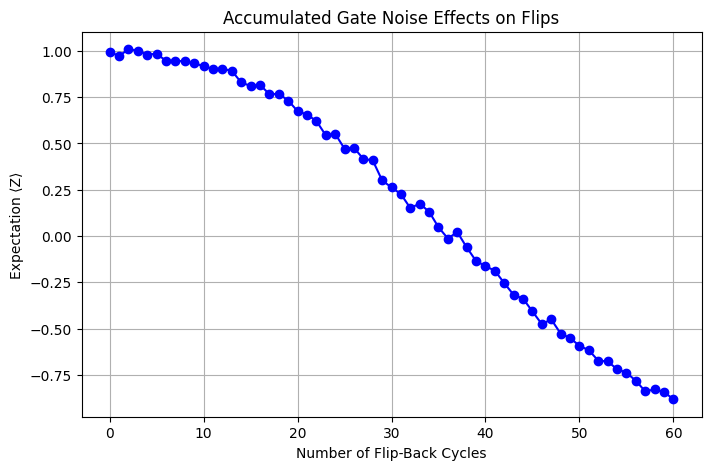
Очікуване значення починається приблизно з 1.0, як і очікувалося, і спадає, але воно не просто спадає до нуля! Воно стає від'ємним. Якби це був тепловий шум чи випадкові взаємодії, це не зробило б більш імовірним для вимірювання, ніж . Ця похибка явно інша. І це має сенс у контексті нашого обговорення над-/недообертання. Якщо кожна пара обертань, яка мала б скасовувати одна одну, насправді призводить до обертання на малий кут, то багато таких повторень поступово дозволять стану обертатися від до .
Накопичення помилок, показане тут, навряд чи відбуватиметься так само чисто в реальному робочому процесі. По-перше, ми явно вимкнули пом'якшення помилок і виконали одну й ту саму повторювану послідовність вентилів, щоб дозволити помилкам накопичуватися когерентно. Це зроблено виключно для того, щоб продемонструвати, що такі помилки існують. Коли ми використовуємо методи опрацювання шуму (наприклад, скручування Паулі), ми можемо впливати на те, як накопичується помилка, часто отримуючи нижчу загальну помилку.
Ми можемо перевірити, наскільки добре наша модель цієї похибки відповідає експериментальним даним, побудувавши модель шуму явно і використавши симулятор. У наведеній нижче моделі ми явно закладаємо похибку, що відповідає 0.025 радіана. Це не магічне число; можна просто підлаштовувати похибку, доки вона розумно не опише експеримент.
from qiskit_aer.noise import NoiseModel, coherent_unitary_error
from qiskit_aer import AerSimulator
import numpy as np

# For your SINGLE-QUBIT test on qubit 0, just override X error specifically
noise_model = NoiseModel.from_backend(backend, gate_error=True, thermal_relaxation=True)

theta_error = 0.025  # model over-rotation error around 0.01-0.03 radians
U_over = np.array(
    [
        [np.cos(theta_error / 2), -1j * np.sin(theta_error / 2)],
        [-1j * np.sin(theta_error / 2), np.cos(theta_error / 2)],
    ]
)

unitary_error = coherent_unitary_error(U_over)
# Target ONLY qubit 0 (your circuit) - no warning!
noise_model.add_quantum_error(unitary_error, ["x"], [0])

simulator = AerSimulator(noise_model=noise_model)
WARNING: quantum error already exists for instruction "x" on qubits (0,) , appending additional error.
max_depth = 60
circuits = []
observables = []

for depth in range(max_depth + 1):
    qc = QuantumCircuit(1)
    # Repeat flipping back and forth depth times
    for _ in range(depth):
        #    qc.x(0)
        qc.x(0)
        qc.barrier()
        qc.x(0)
        qc.barrier()
    circuits.append(qc)
    observables.append(Pauli("Z"))

pubs = list(zip(circuits, observables))

estimator = EstimatorV2.from_backend(simulator)
results = estimator.run(pubs).result()
expectations = [pub_res.data.evs for pub_res in results]  # no [0], use value directly
Тепер ми можемо побудувати реальну та змодельовану криві разом.
fig, ax = plt.subplots()

# Add simulator values
ax.scatter(range(max_depth + 1), expectations, c="blue", label="Simulator", alpha=0.7)

# Add real QC values
ax.scatter(range(max_depth + 1), real_expectations, c="red", label="Real", alpha=0.7)

# Add labels and plot
ax.set_xlabel("Number of Flip-Back Cycles")
ax.set_ylabel("Expectation ⟨Z⟩")
ax.set_title("Accumulated Gate Noise Effects on Flips")
ax.legend()
ax.grid(True)

plt.show()
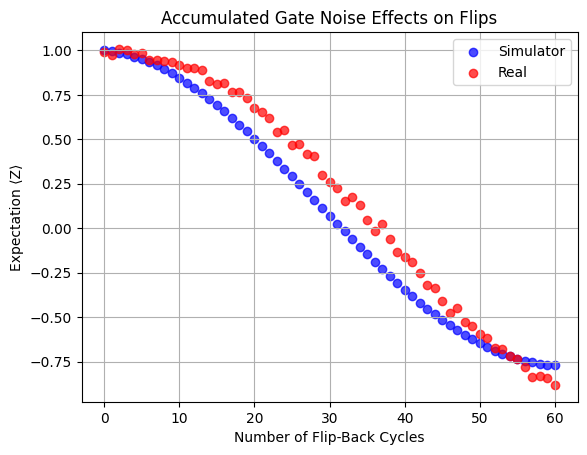
Помилка в реальній схемі була досить добре описана моделлю помилки над-/недообертання. Очевидно, що різні типи шуму та помилок накопичуватимуться по-різному і призводитимуть до кардинально різних наслідків для точності наших квантових схем. Тому стає дуже важливо класифікувати й характеризувати помилки, які можуть виникати, більш формально, ніж ми робили це досі.
Характеризування квантових помилок
Ми вже описали деякі джерела квантового шуму, і ми могли б класифікувати помилки за категоріями шуму, що їх спричиняють. Але можуть існувати й інші категорії квантових помилок, корисні для корекції та пом'якшення помилок. Наприклад, нам потрібно знати, в який момент виникають помилки і як вони накопичуються, якщо ми хочемо їх виправити чи пом'якшити. Якщо класифікувати помилки за тим, де (в яких процесах) вони виникають, то важливою категорією є помилки підготовки стану та вимірювання (або SPAM-помилки, скорочено). Тут термін «підготовка стану» не означає все, що робиться зі станом для підготовки його до вимірювання. Радше він стосується ініціалізації кубітів, «підготовки» кубітів до виконання алгоритму, і тому ця категорія SPAM виключає такі речі, як помилки вентилів під час виконання алгоритму.
Ще одна важлива відмінність — чи є похибки когерентними, чи некогерентними. Коротко (докладніше ми обговоримо це нижче): когерентні похибки зазвичай моделюються унітарними операціями і зберігають чистоту стану. Некогерентні похибки моделюються неунітарними квантовими каналами і, як правило, знижують чистоту стану. Некогерентні похибки легко уявити як теплові взаємодії, що спричиняють втрату квантової інформації, але насправді вони можуть бути спричинені будь-яким випадковим зв'язком із середовищем. Як приклад когерентної похибки, припустімо, що є недосконалість орієнтації імпульсу під час реалізації вентиля RY, така що вентиль насправді спричиняє . Така недосконалість завжди спричиняла б помилкове обертання навколо X в одному й тому самому напрямку. Це була б когерентна похибка.
Зауваж, що помилки SPAM включають суміш когерентних помилок, як-от систематичні збої керування, та некогерентних помилок, таких як втрата фотонів і теплові ефекти. Оскільки це охоплює кілька етапів і джерел помилок, помилки SPAM найкраще описувати як поєднання і когерентних, і некогерентних помилок.
SPAM-похибки
Як випливає з назви, SPAM-помилки виникають на двох окремих стадіях квантового експерименту: початкової підготовки та зчитування/вимірювання. Помилки підготовки стану виникають, коли апаратура не може надійно ініціалізувати кубіти в бажаному початковому стані ( для квантових комп'ютерів IBM). Причини включають:
- теплове збудження (реальні кубіти не є ідеально охолодженими і можуть іноді стартувати в замість )
- залишкові фотони чи шум у резонаторах надпровідних кубітів
- дрейф калібрування, що впливає на точність скидання кубітів
Помилки вимірювання виникають під час процесу зчитування, коли апаратура вимірювання неправильно ідентифікує стан кубіта. Джерела включають:
-
шум підсилювача зчитування, що спричиняє плутанину між і
-
релаксацію кубіта під час зчитування (наприклад, кубіт у стані розпадається до безпосередньо перед або під час вимірювання)
-
перехресні завади між лініями зчитування: зчитування одного кубіта дещо впливає на показання сусідніх кубітів
-
недосконалі порогові значення розрізнення в резонаторних вимірювальних системах IBM
SPAM-помилки переважно некогерентні. Помилки підготовки поводяться як випадкові суміші збуджених і основних станів. Помилки вимірювання поводяться як класична плутанина: з імовірністю стан зчитується як або навпаки. Це відрізняється від когерентних унітарних помилок (як-от неправильно відкалібровані вентилі, що спричиняють систематичні фазові зсуви). Натомість SPAM-помилки більше нагадують випадковий класичний шум, хоча рідкісні когерентні зсуви у зчитуванні також можуть існувати.
SPAM-похибки можуть бути проблематичними для рандомізованого бенчмаркінгу або для схем із малою глибиною, де підготовка стану та вимірювання становлять велику частку загальної похибки. Вони менш проблематичні для дуже глибоких схем, особливо тих, що мають багато двокубітних вентилів.
Математично SPAM-похибки можна описати як утворення зашумленого розподілу , пов'язаного з ідеальним розподілом через матрицю :
Тут — імовірність вимірювання бітового рядка , а — імовірність отримання стану , коли стан мав би бути підготовлений у стані . Уяви контекст вибіркових бітових рядків із Sampler. Виміряний розподіл станів складатиметься з багатьох точних вимірювань, але також із деяких вимірювань, де інструкції для підготовки стану не збігаються зі спостереженим станом. Це означає, що ймовірності будуть трохи неточними.
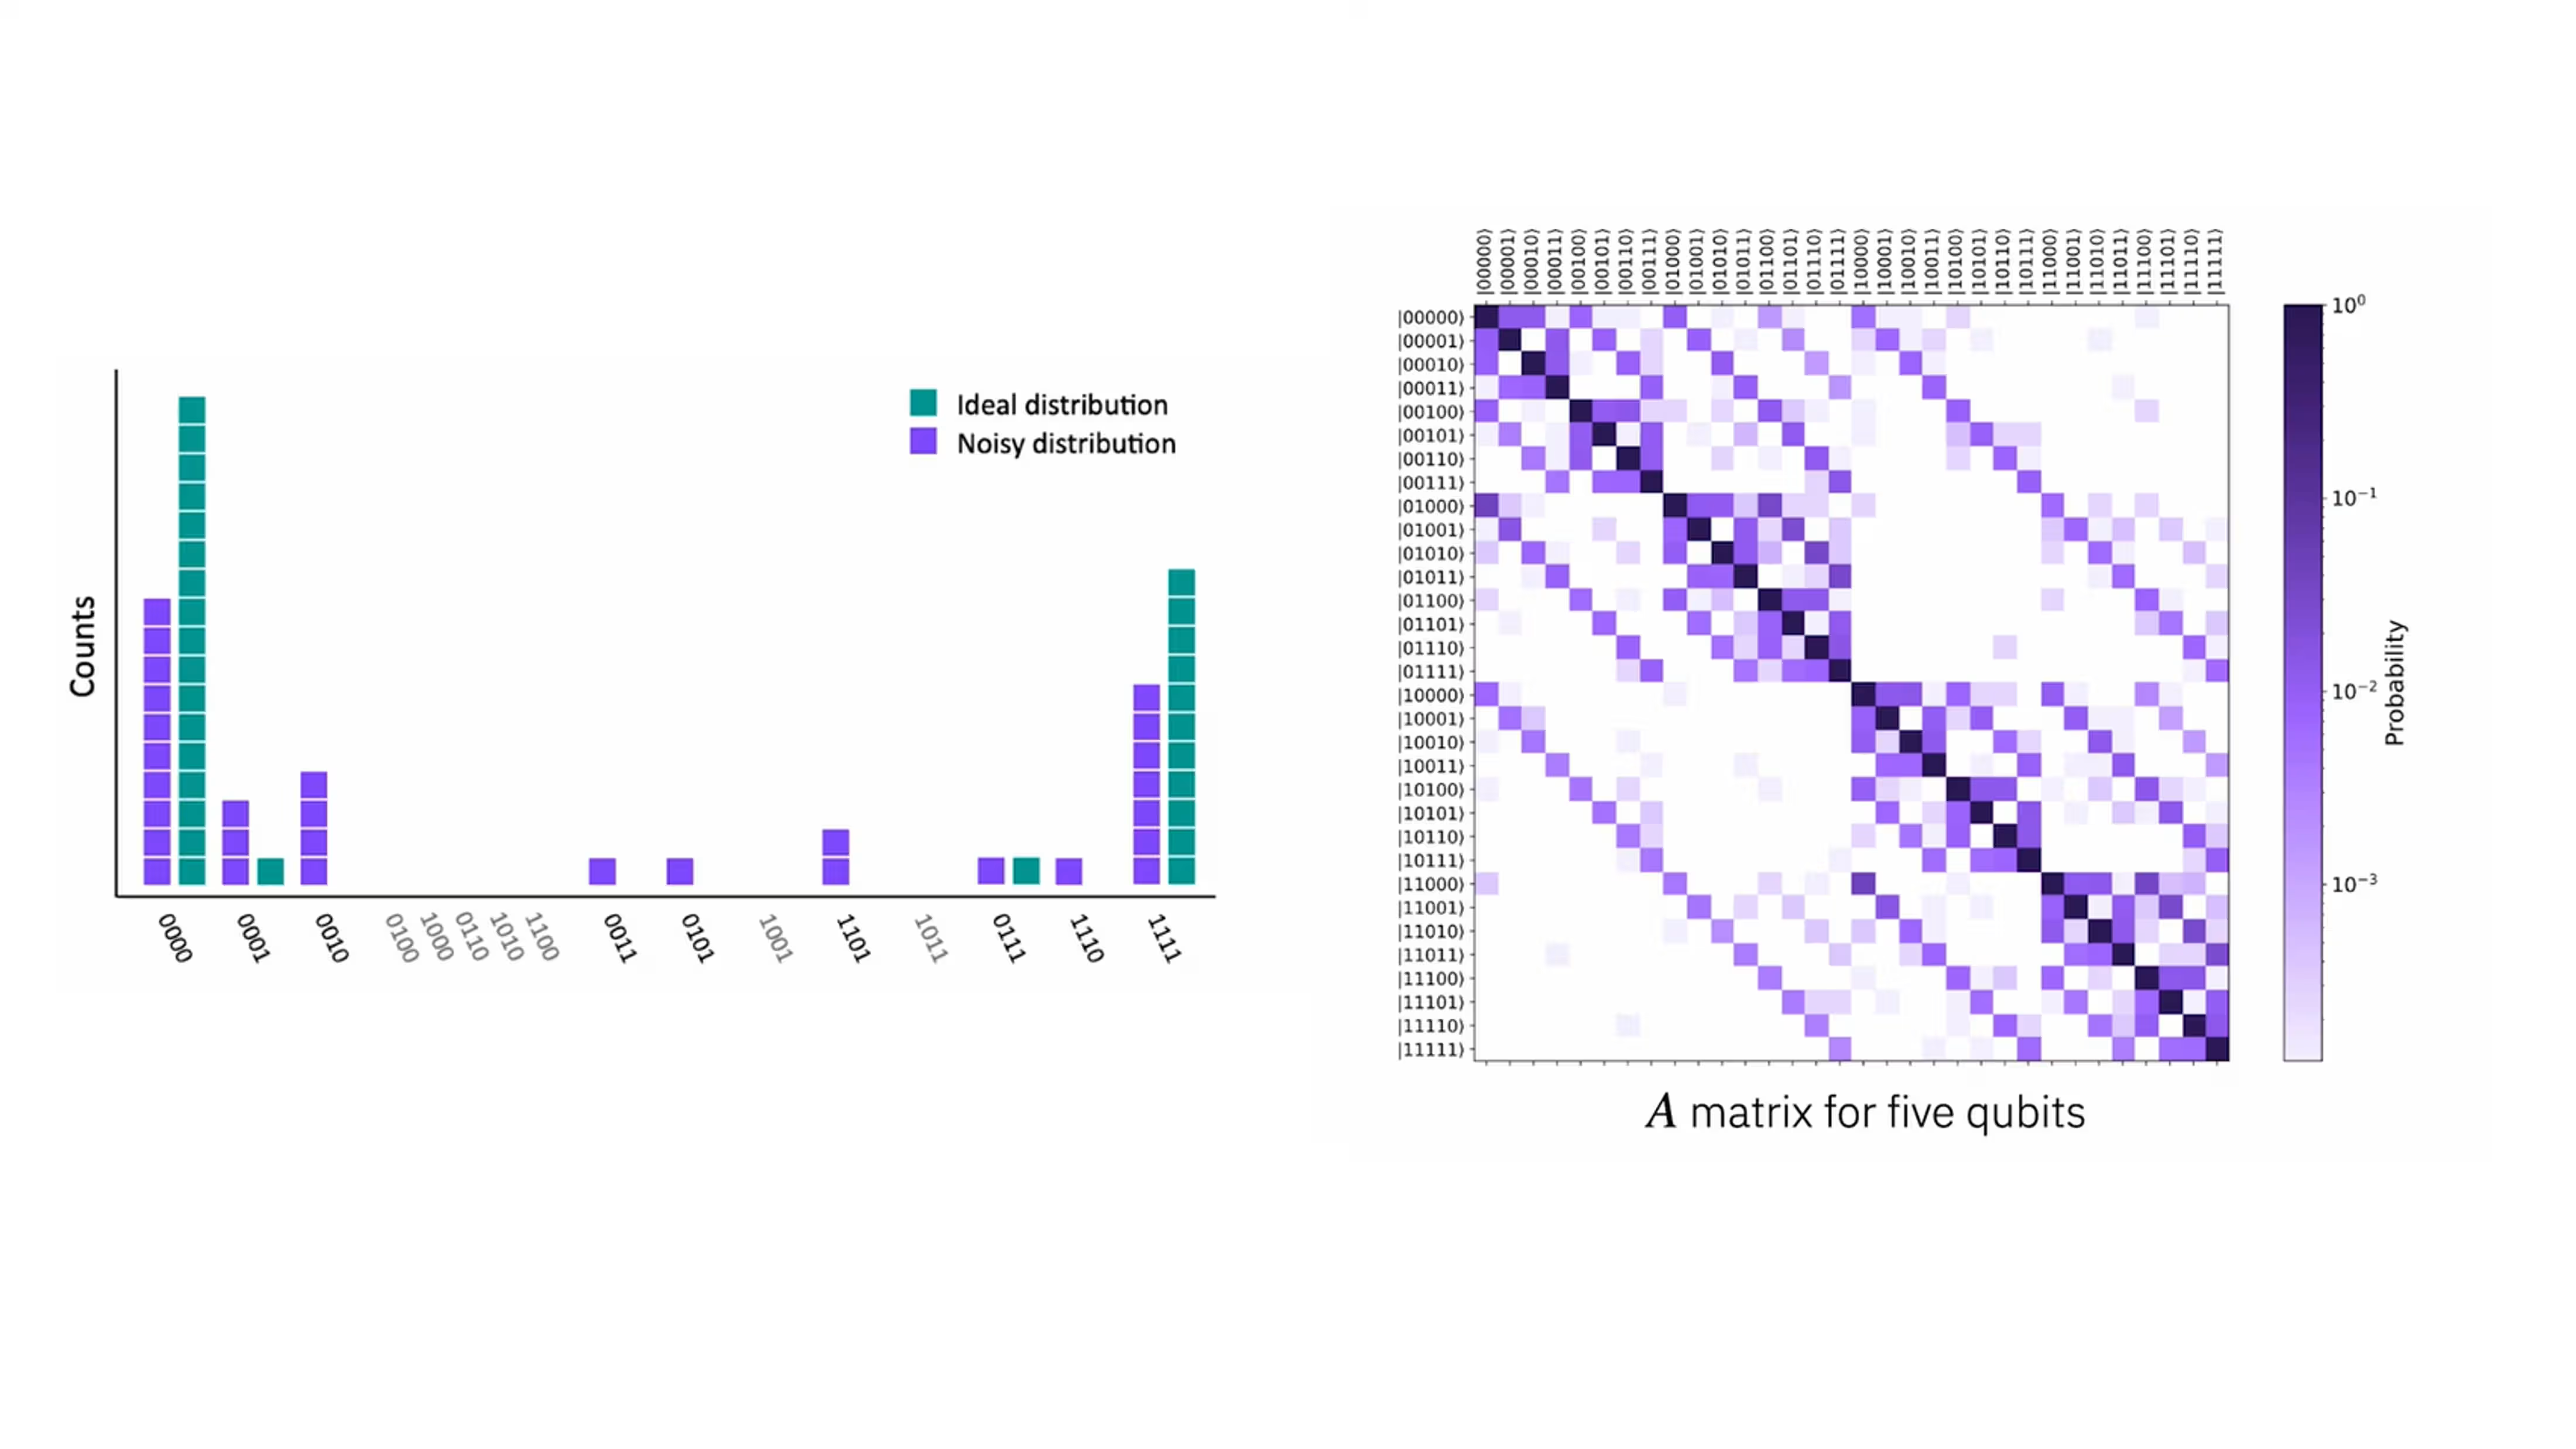
На наведеному вище рисунку частина (a) показує ідеальний розподіл GHZ-стану бірюзовим кольором і фактичні вимірювання фіолетовим. У частині (b) ми бачимо приклад матриці . Зауваж, що матриця не є ідеально симетричною відносно діагоналі, оскільки кожен кубіт не обов'язково однаково імовірно помилково повертає 0 і помилково повертає 1. На практиці часто важко відокремити похибки підготовки та зчитування, тому їх часто розглядають разом (звідси й поширене використання терміна SPAM).
Один зі способів виправлення цих SPAM-помилок — використання простих схем із відомими ідеальними результатами вимірювання та порівняння їх із виміряними результатами за наявності SPAM-помилок. Це можна використати для зворотного інжинірингу ідеальних результатів складніших схем. Для загальних станів із високою ентропією це може вимагати побудови матриці з імовірностей, але в менш екстремальних випадках ці помилки можна пом'якшити.
Когерентні та некогерентні помилки
Когерентні помилки — це систематичні, детерміністичні й унітарні помилкові обертання квантового стану. Вони виникають через недосконалі квантові операції, що відхиляються передбачуваним чином. Приклади включають незначні помилки в обертанні, застосованому однокубітними вентилями обертання, зокрема ті, що спричинені дрейфом калібрування, який постійно над- або недообертає. Математично ми могли б записати, що реальний вентиль обертання, скажімо , задається ідеальним вентилем обертання плюс деяка додаткова помилка:
для деякого малого недо- чи надобертання . Інші приклади включають двокубітний вентиль, що додає малий небажаний фазовий зсув, та керуючі імпульси, що систематично відхиляються від ідеальної форми.
Ключова характеристика когерентних помилок полягає в тому, що вони детерміністичні й можуть бути змодельовані самими унітарними вентилями. Відповідно вони зберігають чистоту квантового стану: квантова інформація не втрачається, вона просто оброблена недосконало. Інший важливий момент, який слід відзначити, полягає в тому, що повторювані когерентні помилки інтерферують конструктивно і іноді зростають квадратично з кількістю вентилів.
Ці помилки іноді передбачувані, і тому їх певною мірою можна відкалібрувати. Але когерентні помилки, що залишаються, можуть швидко накопичуватися, спричиняючи неприємні відхилення від ідеальних станів. Це означає, що іноді вигідно навмисно «рандомізувати» когерентні помилки. Ця процедура та її корисність будуть розглянуті в уроці про пом'якшення помилок.
Чому вони проблематичні
Когерентні похибки можуть «накопичуватися» небезпечним чином, спричиняючи великі відхилення від правильного стану, якщо їх не рандомізувати чи не виправити.
Некогерентні похибки — стохастичні, випадкові й часто неунітарні. Вони виникають через взаємодії із середовищем чи неконтрольовані джерела шуму. Ми вже бачили деякі приклади: релаксація енергії / розпад — некогерентна. Так само як стохастичний шум вентилів, тепловий шум і похибка вимірювання.
Ключова особливість некогерентних помилок полягає в тому, що вони не однакові щоразу, коли виконується операція. Вони неунітарні, тому їх не можна змоделювати простим унітарним квантовим вентилем, як це можна було зробити з когерентними помилками. Оскільки вони некогерентні, вони зазвичай накопичуються лінійним чином, як випадковий шум, а не як послідовне надобертання.
Некогерентні похибки спричиняють незворотну втрату інформації кубітами (втрату чистоти та фазової інформації).
То що ж гірше? Як і з більшістю речей у квантових обчисленнях, це залежить від обставин. Висновок полягає в тому, що когерентні помилки накопичуються швидше і нелінійно (що погано). Але їх можна частково відкалібрувати, і фазова інформація все ще присутня у твоїй системі, якщо ти зможеш зрозуміти, як правильно її видобути. Некогерентні помилки накопичуються лінійно, що добре з двох причин: це повільніше, ніж когерентне накопичення, і досить легко побачити, як ефекти некогерентних помилок масштабуються для таких процесів, як екстраполяція до нульового шуму (ZNE), яку буде розглянуто в уроці про пом'якшення помилок. Однак, коли виникають некогерентні помилки, квантова інформація справді втрачається, а не просто стає прихованою.
Матриці густини та квантові канали
У наступних розділах ми глибше розглянемо кілька типів когерентних і некогерентних помилок і побачимо, як їх можна змоделювати математично за допомогою квантових каналів. Спочатку варто коротко освіжити знання про матриці густини та квантові канали. Для повного, строгого розгляду цього див. курс Джона Ватруса Загальне формулювання квантової інформації на IBM Quantum Learning. Виклад тут буде побудований на прикладах і менш формальний.
Квантові канали — це найзагальніший спосіб опису того, як квантова система еволюціонує, взаємодіє та зазнає шуму. Якщо ти звик до чистих станів і унітарної еволюції, квантові канали є природним наступним кроком.
У стандартній квантовій механіці «чистий» стан записується як . Тут «чистий» стосується чистоти інформації чи знання про підготовку стану; це не означає власний стан якоїсь системи. Для прикладу з кубітом є чистим станом, тому що ми маємо досконале знання про відносні амплітуди та фазу. Часова еволюція такого чистого стану керується унітарним оператором :
згідно з рівнянням Шредінгера, в якому , де — гамільтоніан системи, а — зведена стала Планка, яку часто «прирівнюють до одиниці», або, точніше, поглинають у гамільтоніан, так що всі енергії задаються в одиницях .
Унітарна еволюція оборотна, детерміністична й ізольована. Але цього недостатньо для опису реальних квантових систем. У реальних квантових системах:
- Ми виконуємо вимірювання, колапсуючи квантовий стан у власний стан системи. Це явно неунітарно.
- Система взаємодіє із середовищем. Це означає, що система не є справді ізольованою, і оскільки середовище неможливо відстежувати нескінченно, це відповідає втраті інформації.
- Практично кажучи: шум спотворює стан. І багато іншого.
Сама лише унітарна еволюція не може описати ці процеси; тому нам потрібне більш загальне представлення квантових станів і процесів. Змішаний стан описує класичний розподіл квантових станів. Тобто ми вже знаємо той факт, що квантовий стан має 50% шанс бути виміряним (колапсованим у класичну інформацію) у стані і 50% шанс бути виміряним у стані . Але твердження полягає в тому, що початковий квантовий стан є точно зі 100% імовірністю. Тепер ми хочемо додати поверх квантово-механічної ймовірності класичну ймовірність, наприклад:
Початковий квантовий стан підготовлений у із 25% класичною імовірністю і підготовлений у із 75% класичною імовірністю (зауваж різні відносні фази).
Іноді це може бути через явні класичні імовірності в підготовці; в інших випадках це може бути через заплутаність із частинами середовища, які ми ігноруємо. У будь-якому разі потреба в інструменті для опису цього класичного розподілу квантово-механічних станів очевидна. Самі лише чисті стани не можуть представити ці можливості. Тому ми вводимо матрицю густини.
Змішаний стан описується оператором густини:
Тут — квантовий стан (не обов'язково власний стан якогось конкретного оператора), а — класична імовірність того, що система підготовлена в стані . Це хороший рецепт побудови матриці густини з відомого класичного розподілу квантових станів. З іншого боку, ми можемо хотіти знати, маючи як класичний розподіл квантових станів, так і квантово-механічну ймовірність різних результатів вимірювання, яка ймовірність того, що вимірювання дасть певний стан (наприклад, , або , або інші стани, коли задіяно більше кубітів). Саме тут матриця густини особливо корисна. Ми також можемо записати її в базисі як:
Тут діагональні елементи є ймовірностями:
-
= імовірність того, що кубіт перебуває в стані
-
= імовірність того, що кубіт перебуває в стані
Вони дійсні, невід'ємні й у сумі дають 1.
Недіагональні елементи є когерентностями: фазовими співвідношеннями чи здатністю до інтерференції, і загалом відповідають тому, скільки квантово-механічної інформації міститься в стані. Це неформальне твердження, але подивимося, що це означає на практиці.
Приклад
Розглянь чистий стан . (a) Що ти знаєш про ймовірності вимірювання та фазову інформацію, не виконуючи жодних обчислень? (b) Побудуй матрицю густини і перевір свою інтуїцію.
Solution:
(a) Оскільки це чистий стан, існує лише одна можлива фаза між і : +1. Це досконала фазова інформація, тож ми очікуємо, що недіагональні елементи нашої матриці густини будуть великими. У тебе може бути більше інтуїції щодо недіагональних елементів, ніж це, але наразі цього достатньо. Далі, амплітуди двох базисних станів рівні, тож ми очікуємо 50% імовірності виміряти або , або . Тож ми очікуємо, що діагональні елементи дорівнюватимуть 1/2. (b) Використовуючи наведене вище визначення:
лише для стану . Тож ми можемо записати
Діагональні елементи кожен дорівнюють , як і очікувалося, а недіагональні елементи великі (у сумі дають одиницю).
Тепер подивімося, що відбувається, коли ми не маємо доброї фазової інформації.
Приклад
Розглянь подібний випадок, але тепер із 50% класичною імовірністю перебування в стані і 50% класичною імовірністю перебування в стані . Ті самі два питання: (a) Що ти знаєш про ймовірності вимірювання та фазову інформацію, не виконуючи жодних обчислень? (b) Побудуй матрицю густини і перевір свою інтуїцію.
Solution:
(a) Як і раніше, амплітуди двох базисних станів рівні, тож ми очікуємо 50% імовірності виміряти або , або . Тож ми очікуємо, що діагональні елементи дорівнюватимуть 1/2. Але цього разу є дві протилежні можливості для фази між і : +1 і -1, і кожна з них однаково імовірна. Можна очікувати, що з двома однаково імовірними протилежними фазами матимемо мало або зовсім не матимемо фазової інформації. Можна очікувати, що недіагональні елементи будуть малими. (b) Знову використовуючи наведене вище визначення
лише для двох станів і . Тож ми можемо записати
Недіагональні елементи малі, фактично нульові, як і очікувалося. Діагональні елементи все ще становлять 50% кожен, що має сенс, оскільки кожен зі станів у суміші мав і з однаковою вагою.
Ця конструкція стає цікавішою зі зростанням кількості кубітів. Дослідіть це в наведених нижче питаннях.
Перевір своє розуміння
Запиши матрицю густини для чистого стану Белла .
Відповідь
лише для стану . Тож ми можемо записати
Запиши матрицю густини для 25% класичної імовірності і 75% класичної імовірності .
Відповідь
лише для двох станів і . Тож ми можемо записати
Змінивши свою роботу з попереднього питання, запиши матрицю густини для 50% класичної імовірності і 50% класичної імовірності . Передбач, яка фазова інформація має зберегтися.
Відповідь
лише для двох станів і . Тож ми можемо записати
Діагональні члени в сумі дають 1, як і мають. Недіагональні члени тут не скасовуються, як це було в попередньому, однокубітному прикладі. Це можна побачити в математиці, але коротке пояснення полягає в тому, що тепер у нашому гільбертовому просторі більше станів. Хоча перший стан Белла мав додатну відносну фазу, а другий — від'ємну, ці фази були між різними базисними станами. Перший стан Белла мав фазу між і , тоді як другий мав відносну фазу між і .
Квантові канали
Квантовий канал — це найзагальніше фізично допустиме перетворення квантового стану. Він переводить початкову матрицю густини в іншу матрицю густини:
Тут означає квантовий канал , що діє на матрицю густини , і його не слід плутати зі станами Белла чи .
Квантові канали надзвичайно загальні. Вони можуть включати:
-
Унітарну еволюцію
-
Імовірнісні суміші унітарних операцій
-
Measurements
-
Decoherence
-
Загасання амплітуди (втрату енергії)
-
Дефазування (втрату фазової інформації)
-
Взаємодію із середовищем І багато іншого.
Один зі способів мислити про квантові канали полягає в тому, що вони є для матриць густини тим, чим унітарні оператори є для чистих станів. Але загальність матриць густини дозволяє відповідним квантовим каналам бути значно загальнішими і, отже, потужнішими.
Єдині обмеження на квантовий канал полягають у тому, що він повинен бути:
- Лінійним Суміші станів мають еволюціонувати узгоджено:
- Цілком додатним Він не повинен породжувати від'ємні ймовірності, навіть якщо твоя система заплутана з чимось іншим.
- Таким, що зберігає слід Ймовірності мають у сумі давати 1. Ці властивості іноді об'єднують в абревіатуру CPTP: Completely Positive Trace-Preserving maps (цілком додатні відображення, що зберігають слід).
Існують різні представлення квантових каналів, зокрема представлення Стайнспрінга, Крауса та Чоі. Вони детально розглядаються в цьому уроці про квантові канали в курсі Загальна формулювання квантової інформації, і там же показано, що вони еквівалентні. Ми не заглиблюватимемося тут у ці різні представлення. Досить сказати, що вони аналогічні опису векторів за допомогою трьох різних систем координат. Кожне може підкреслювати різні аспекти й будувати інтуїцію по-різному; але всі вони дають правильну відповідь. Представлення Крауса зручні для наших цілей. Вони пропонують зручний формульний спосіб вираження дії каналу через множення та додавання матриць. Зокрема, представлення Крауса — це специфікація каналу у такому вигляді.
Тут — матриці, які всі мають однакові розміри: їхні стовпці відповідають класичним станам вхідної системи, , а їхні рядки відповідають класичним станам вихідної системи, будь то чи якась інша система . Щоб був допустимим каналом, ці матриці повинні задовольняти таку умову.
Ці матриці називаються матрицями Крауса. Це формулювання застосовне не лише до каналів шуму, а й до загальних квантових процесів і каналів, зокрема вимірювання. Подивімося на приклад того, як їх можна використати для побудови каналів у контексті шуму й помилок.
Повністю дефазувальний канал
Розглянь канал, що знищує всю фазову інформацію, і назвемо його повністю дефазувальним каналом. Це означає, що канал має брати будь-яку матрицю густини вигляду
і відображати її на
Якщо ми припустимо, що матриця густини вже записана в обчислювальному базисі, ми можемо виразити як . Це наводить на думку про набір матриць Крауса, що можуть виконати цю дію каналу: . Застосуймо цю стратегію до прикладного випадку одного кубіта і подивімося, чи спрацьовує вона так, як нам потрібно:
Задай і .
Оскільки є числом, ми можемо просто перенести вектор повз нього. Це стосується й другого доданка. Маємо:
Зверніть увагу, що ці матриці задовольняють необхідну умову:
Варто зазначити, що цей вибір матриць Крауса не є унікальним.
Характеризація шуму як каналів
У цьому розділі ми використаємо модель сфери Блоха та математику квантових каналів, щоб краще зрозуміти різні типи шуму та помилок.
Некогерентні помилки
Повернімося до некогерентних помилок і розглянемо, зокрема, помилки енергетичної релаксації. Пригадаймо, що стан — це основний стан кубіта, а стан має трохи вищу енергію. Іноді квантові стани просто спонтанно розпадаються з вищого енергетичного рівня на нижчий. Процес спонтанного випромінювання є багатою темою, і його справді неможливо зрозуміти без розгляду квантової теорії поля. Але інтуїція тут дуже знайома всім нам: випадкові збурення можуть змусити камінь скотитися з пагорба вниз; вони не змусять камінь підкотитися на пагорб. Те, як довго кубіт залишається у стані з вищою енергією, характеризується часом . Точніше, ймовірність того, що кубіт, підготовлений у стані , залишиться в цьому стані після часу , дорівнює . Або, еквівалентно, ймовірність помилки енергетичної релаксації після часу дорівнює
Щоб описати це за допомогою квантового каналу в представленні Крауса, нам потрібні матриці Крауса, які відповідають
- залишенню станів незмінними
- зміні станів на з деякою ймовірністю p.
Визначимо
Спочатку перевіримо, що це справджує бажаний ефект на матрицю густини. Розглянемо систему, яка перебуває у чистому стані . Ми бачили у прикладі вище, що матриця густини для цього випадку дорівнює
Застосовуючи канал енергетичної релаксації за допомогою матриць Крауса, ми отримуємо нову, відображену матрицю густини:
Розглянемо це та порівняємо з нашою інтуїцією:
Спочатку перевіримо границю, коли прямує до нуля. Ми отримуємо початкову матрицю густини, як і має бути:
З плином часу ми очікували б, що ймовірність виміряти стан зростатиме, а ймовірність виміряти спадатиме. І знову це саме те, що ми бачимо, оскільки
Ми також легко бачимо, що ймовірності виміряти та у сумі дають 1, як і має бути.
Точне масштабування доданків когерентності (недіагональних елементів) виходить за межі цього розгляду. Але зрозуміло, що спочатку ми маємо повну інформацію про фазу, а через дуже тривалий час фазової інформації вже не буде, оскільки система повністю релаксує у стан . Тому доданки когерентності мають спадати до нуля за дуже великих часів. Дійсно,
Багато обмежень на наші матриці Крауса неявно перевіряються через ці інтуїтивні міркування. Слід строго перевірити, що обмеження на канали (і зокрема на матриці Крауса) виконуються, але ми залишаємо це як вправу для читача.
Графічно цей тип каналу можна зобразити за допомогою сфери Блоха. Чистий стан лежить на поверхні сфери Блоха. Мішані стани зміщуються всередину сфери та розповсюджуються від однієї точки. Включення класичних ймовірностей проявляється через зменшення абсолютної відстані від початку координат до будь-якого зі станів у суміші, а розповсюдження від однієї точки до області вказує на змішування кількох можливих станів. У особливому випадку каналу енергетичної релаксації мішаний стан (матриця густини) після певного помітного часу виглядатиме як на зображенні нижче: область всередині сфери Блоха, зміщена вгору до полюса і стиснута як уздовж осі , так і в площині , хоча меншою мірою, ніж уздовж .

Зверніть увагу, що ця область не є «шапкою» сфери Блоха, як іноді здається у перспективному зображенні. Як добре видно з відео, це сплюснутий сфероїд, стиснутий і зміщений до стану . Шумові канали (і канали загалом), звісно, застосовні до систем будь-якого розміру. Але їх візуальне представлення (наприклад, за допомогою сфери Блоха) стає складнішим із збільшенням кількості взаємно ортогональних станів у гільбертовому просторі.
Перевір своє розуміння
Перевір, що матриці Крауса, використані в каналі енергетичної релаксації вище, задовольняють умову тотожності:
Відповідь
Ми представимо ще два типи некогерентних шумових каналів, але залишимо більшу частину інтерпретації та перевірки як вправи. Наступний — це канал дефазування, який описує втрату фазової інформації, але зі збереженням амплітуд. Хоча в загальній ймовірності вимірювання все ще можуть бути задіяні як класичні, так і квантово-механічні ймовірності, втрату фазової інформації часто описують як втрату квантової інформації, або як те, що система стає більш класичною.
Так само, як енергетична релаксація описувалася характерним часом , помилки дефазування описуються другим часовим параметром . Ймовірність помилки дефазування після часу визначається як
Набір матриць Крауса для каналу дефазування на одному кубіті, виражений через цю ймовірність, є таким:
Результат цього каналу дефазування візуалізовано за допомогою сфери Блоха на рисунку нижче.

Зверніть увагу, що амплітуди не змінюються, тому будь-які стани, що потрапляють точно на полюс ( або ), залишаються незмінними і все ще відображаються на поверхню сфери в затіненій області. Але фазова інформація втрачається, що відповідає стисненню затіненої області вздовж площини . Один із способів осмислити це такий: будь-який можливий квантовий стан усе ще може мати чітко визначену фазу, але оскільки існує класична ймовірність знайти кілька станів із різними чітко визначеними фазами, загальна ймовірність будь-якої однієї чітко визначеної фази зменшується.
Перевір своє розуміння
Перевір, що матриці Крауса, визначені вище для каналу дефазування, задовольняють умову тотожності:
Відповідь
Почніть із чистого однокубітного стану на ваш вибір, із чітко визначеною фазою між та . Запишіть його як матрицю густини. Застосуйте канал дефазування, використовуючи оператори Крауса, запропоновані вище. Проінтерпретуйте отриману, відображену матрицю густини.
Відповідь
Оберемо стан . Відповідна матриця густини дорівнює
Тепер застосуємо канал дефазування до цієї матриці густини, використовуючи оператори Крауса.
По-перше, зауважимо, що сума діагональних елементів дійсно дорівнює одиниці, як і має бути. По-друге, зауважимо, що недіагональні елементи спочатку були великими, із сумою 24/25, що вказує на сильну когерентність. Зауважте, що зі зростанням ймовірності помилки дефазування ці недіагональні елементи зменшуються. Це також відповідає нашим очікуванням. Одна тонкість: зверніть увагу, що відбувається, коли . Когерентність знову стає сильною! Спочатку це здається контрінтуїтивним, адже висока ймовірність помилки дефазування мала б зіпсувати нашу фазу, чи не так? Секрет у тому, що якщо ми на 100% впевнені, що фазова помилка відбувається, то ми знову маємо чітку інформацію про фазу; фаза просто перевернулася. З огляду на це, можна очікувати, що найгірша фазова інформація відповідає ймовірності 50 на 50 виникнення фазової помилки, і саме це ми й спостерігаємо.
Наш останній приклад шумового каналу, що описує некогерентні помилки, — це паулівський шумовий канал. Цей канал описує виникнення трьох типів помилок із незалежними ймовірностями:
- помилка бітового перевороту (X-помилка) з ймовірністю
- помилка фазового перевороту (Z-помилка) з ймовірністю
- комбінована X та Z (Y-помилка) з ймовірністю Тут для всіх . Наслідком є те, що ймовірність відсутності помилки дорівнює .
Оператори Крауса для цього каналу такі:
У випадку паулівського шумового каналу повчально виписати сам канал:
З цього вигляду видно, що паулівський шумовий канал реалізує одну або кілька помилок, що відповідають дії матриць Паулі , кожна з ймовірністю .
Різні комбінації ймовірностей переворотів дають різні візуалізації. Тут ми візуалізуємо особливий випадок, коли , який також називають деполяризуючим каналом.

Моделювання когерентних помилок
Квантові канали можуть представляти як когерентні, так і некогерентні помилки, але на практиці їх використовують переважно для некогерентних помилок, оскільки когерентні помилки краще моделювати як унітарні розкалібрування або перетворювати на стохастичні канали для полегшення аналізу. У цьому розділі ми представимо підходи, більш придатні для когерентних помилок.
Когерентні помилки можна моделювати небажаними унітарними вентилями. Деякі прості приклади — неузгоджені обертання або недо-/надобертання. На зображенні нижче ми показуємо неузгоджене обертання як додаткове обертання на малу величину на додачу до бажаного обертання навколо осі . Надобертання описується бажаним обертанням , а також деяким додатковим обертанням навколо тієї самої осі .
Двокубітні помилки та затінені світлові конуси
Однокубітний вентиль повертає ізольований кубіт. Двокубітний вентиль реалізує логіку, що спирається на два кубіти, але не може безпосередньо виміряти жоден із кубітів; тому він має вмикати взаємодію між кубітами. Саме ця взаємодія дає змогу створювати заплутаність, і саме звідси значною мірою походить шум, перехресні завади та складність калібрування. Ця взаємодія між кубітами також дозволяє помилкам поширюватися. Якщо один кубіт має якусь помилку, і він слугує керуючим кубітом для іншого цільового кубіта, помилка може передатися на цільовий кубіт. У цьому уроці ми розглянемо, що означають двокубітні вентилі для частоти помилок та їх поширення в межах схеми.
Вентилі відлуненого перехресного резонансу
Різні апаратні архітектури та сімейства вентилів реалізують цю взаємодію по-різному. Квантові комп'ютери IBM реалізують абстрактні двокубітні вентилі, такі як CZ або CX, за допомогою апаратно-нативних вентилів відлуненого перехресного резонансу (ECR). Вентилі ECR генерують ефективну взаємодію за допомогою мікрохвильового приводу. Споріднені вентилі, такі як CNOT, будуються з шляхом додавання однокубітних поворотів.
Різні кубіти мають різні резонансні частоти (частоти, на які вони сильно реагують). Стандартна операція може використовувати цю резонансну частоту, щоб викликати перехід у кубіті. Але що станеться, якщо ти збуджуватимеш кубіт C на резонансній частоті сусіднього кубіта T? Сусідні кубіти пов'язані фіксованою ємнісною або резонаторно-опосередкованою взаємодією. Через цей зв'язок збудження кубіта C «просочується» у гамільтоніан кубіта T. Сила та напрямок цього ефективного збудження залежать від стану кубіта C ( або ). Тут кубіт C є керуючим, а кубіт T — цільовим.
Результатом є ефективний поворот цільового кубіта, обумовлений станом керуючого кубіта. Математично:
Ця взаємодія ZX — це саме те, що потрібно для побудови CNOT. Але інші доданки можуть включати деякі помилки і майже напевно включають ємнісний зв'язок між кубітами C та T, що відповідає доданку ZZ.
Ми можемо розглядати ці додаткові доданки таким чином:
-
IX = цільовий кубіт ненавмисно отримує збудження
-
ZI = керуючий кубіт набуває небажаного повороту Z
-
IZ = цільовий кубіт набуває небажаного повороту Z
-
ZZ = статичний фазовий зсув, що залежить від стану
-
інші = малі взаємодії XY, XX та вищих порядків
Вентиль ECR — це просто керований поворот плюс ретельно підібраний луна-імпульс на керуючому кубіті. Луна-імпульс змінює знак багатьох небажаних доданків, зберігаючи взаємодію ZX. Цей процес досить добре скасовує помилки IX та ZI, а іноді й деякі доданки вищих порядків. Але відлунення не може скасувати статичний зв'язок ZZ, оскільки він комутує з луна-імпульсом. Існують інші взаємодії, які не скасовуються в цьому процесі: деякі залишкові нелінійності та ефекти кубітів-спостерігачів, витік та забруднення далекодіючим приводом, а також кілька інших — але доданок ZZ є особливо важливим.
Цей процес часто вимагає часу приводу, який на порядок довший, ніж для однокубітних вентилів. Поєднання довшого часу приводу, стійких доданків ZZ у гамільтоніані та недосконалостей зв'язку робить двокубітні вентилі домінантним джерелом помилок вентилів. Зауважте також, що якщо в схемі потрібні взаємодії між кубітами, що не є сусідніми, необхідні вентилі SWAP також, очевидно, є двокубітними вентилями. Саме тому стандартною метрикою, пов'язаною з глибиною, є двокубітна, транспільована глибина. Нас переважно цікавлять двокубітні вентилі, оскільки саме вони домінують у помилках вентилів, і нам потрібно розглядати транспільовані схеми, оскільки транспіляція часто вносить багато додаткових двокубітних вентилів у формі вентилів SWAP.
Перевір своє розуміння
Поясніть, чому нас переважно цікавить двокубітна транспільована глибина. Обов'язково врахуйте апаратні обмеження, а також те, що глибина однокубітних вентилів може бути значно більшою.
Відповідь
Двокубітні вентилі мають значно вищу частоту помилок, ніж однокубітні. Однокубітні вентилі теж не є ідеальними, тому бувають випадки, коли корисно враховувати й однокубітну глибину. Але глибина двокубітних вентилів, як правило, домінує в поведінці помилок схеми. Ми маємо розглядати транспільовану схему. Сучасні квантові комп'ютери не мають зв'язності «кожен з кожним» між кубітами. Квантові комп'ютери IBM використовують або квадратну ґратку, або ґратку типу «heavy hex», що означає, що кубіти мають 2, 3 або 4 найближчих сусіди, з якими вони можуть бути безпосередньо з'єднані за допомогою одного двокубітного вентиля. Будь-яка заплутаність з іншими, несусідніми кубітами вимагає переміщення інформації по квантовому комп'ютеру за допомогою двокубітних вентилів SWAP. Таким чином, транспіляція, як правило, збільшує глибину двокубітних вентилів. Для схем із високим рівнем заплутаності це збільшення може бути дуже значним.
Затінені світлові конуси
Припустимо, що один кубіт добре ізольований від усіх інших. Помилка на цьому кубіті не спричинить жодних помилок на будь-яких інших кубітах. Але коли кубіт взаємодіє з іншим, помилки можуть поширюватися. Спосіб поширення помилок залежить від способу взаємодії кубітів. Розгляньмо схему нижче. Припустимо, що будь-які кубіти, суміжні на діаграмі схеми, також є суміжними на квантовому чипі (тобто інформацію не потрібно буде переставляти на інші кубіти, щоб забезпечити описані взаємодії).
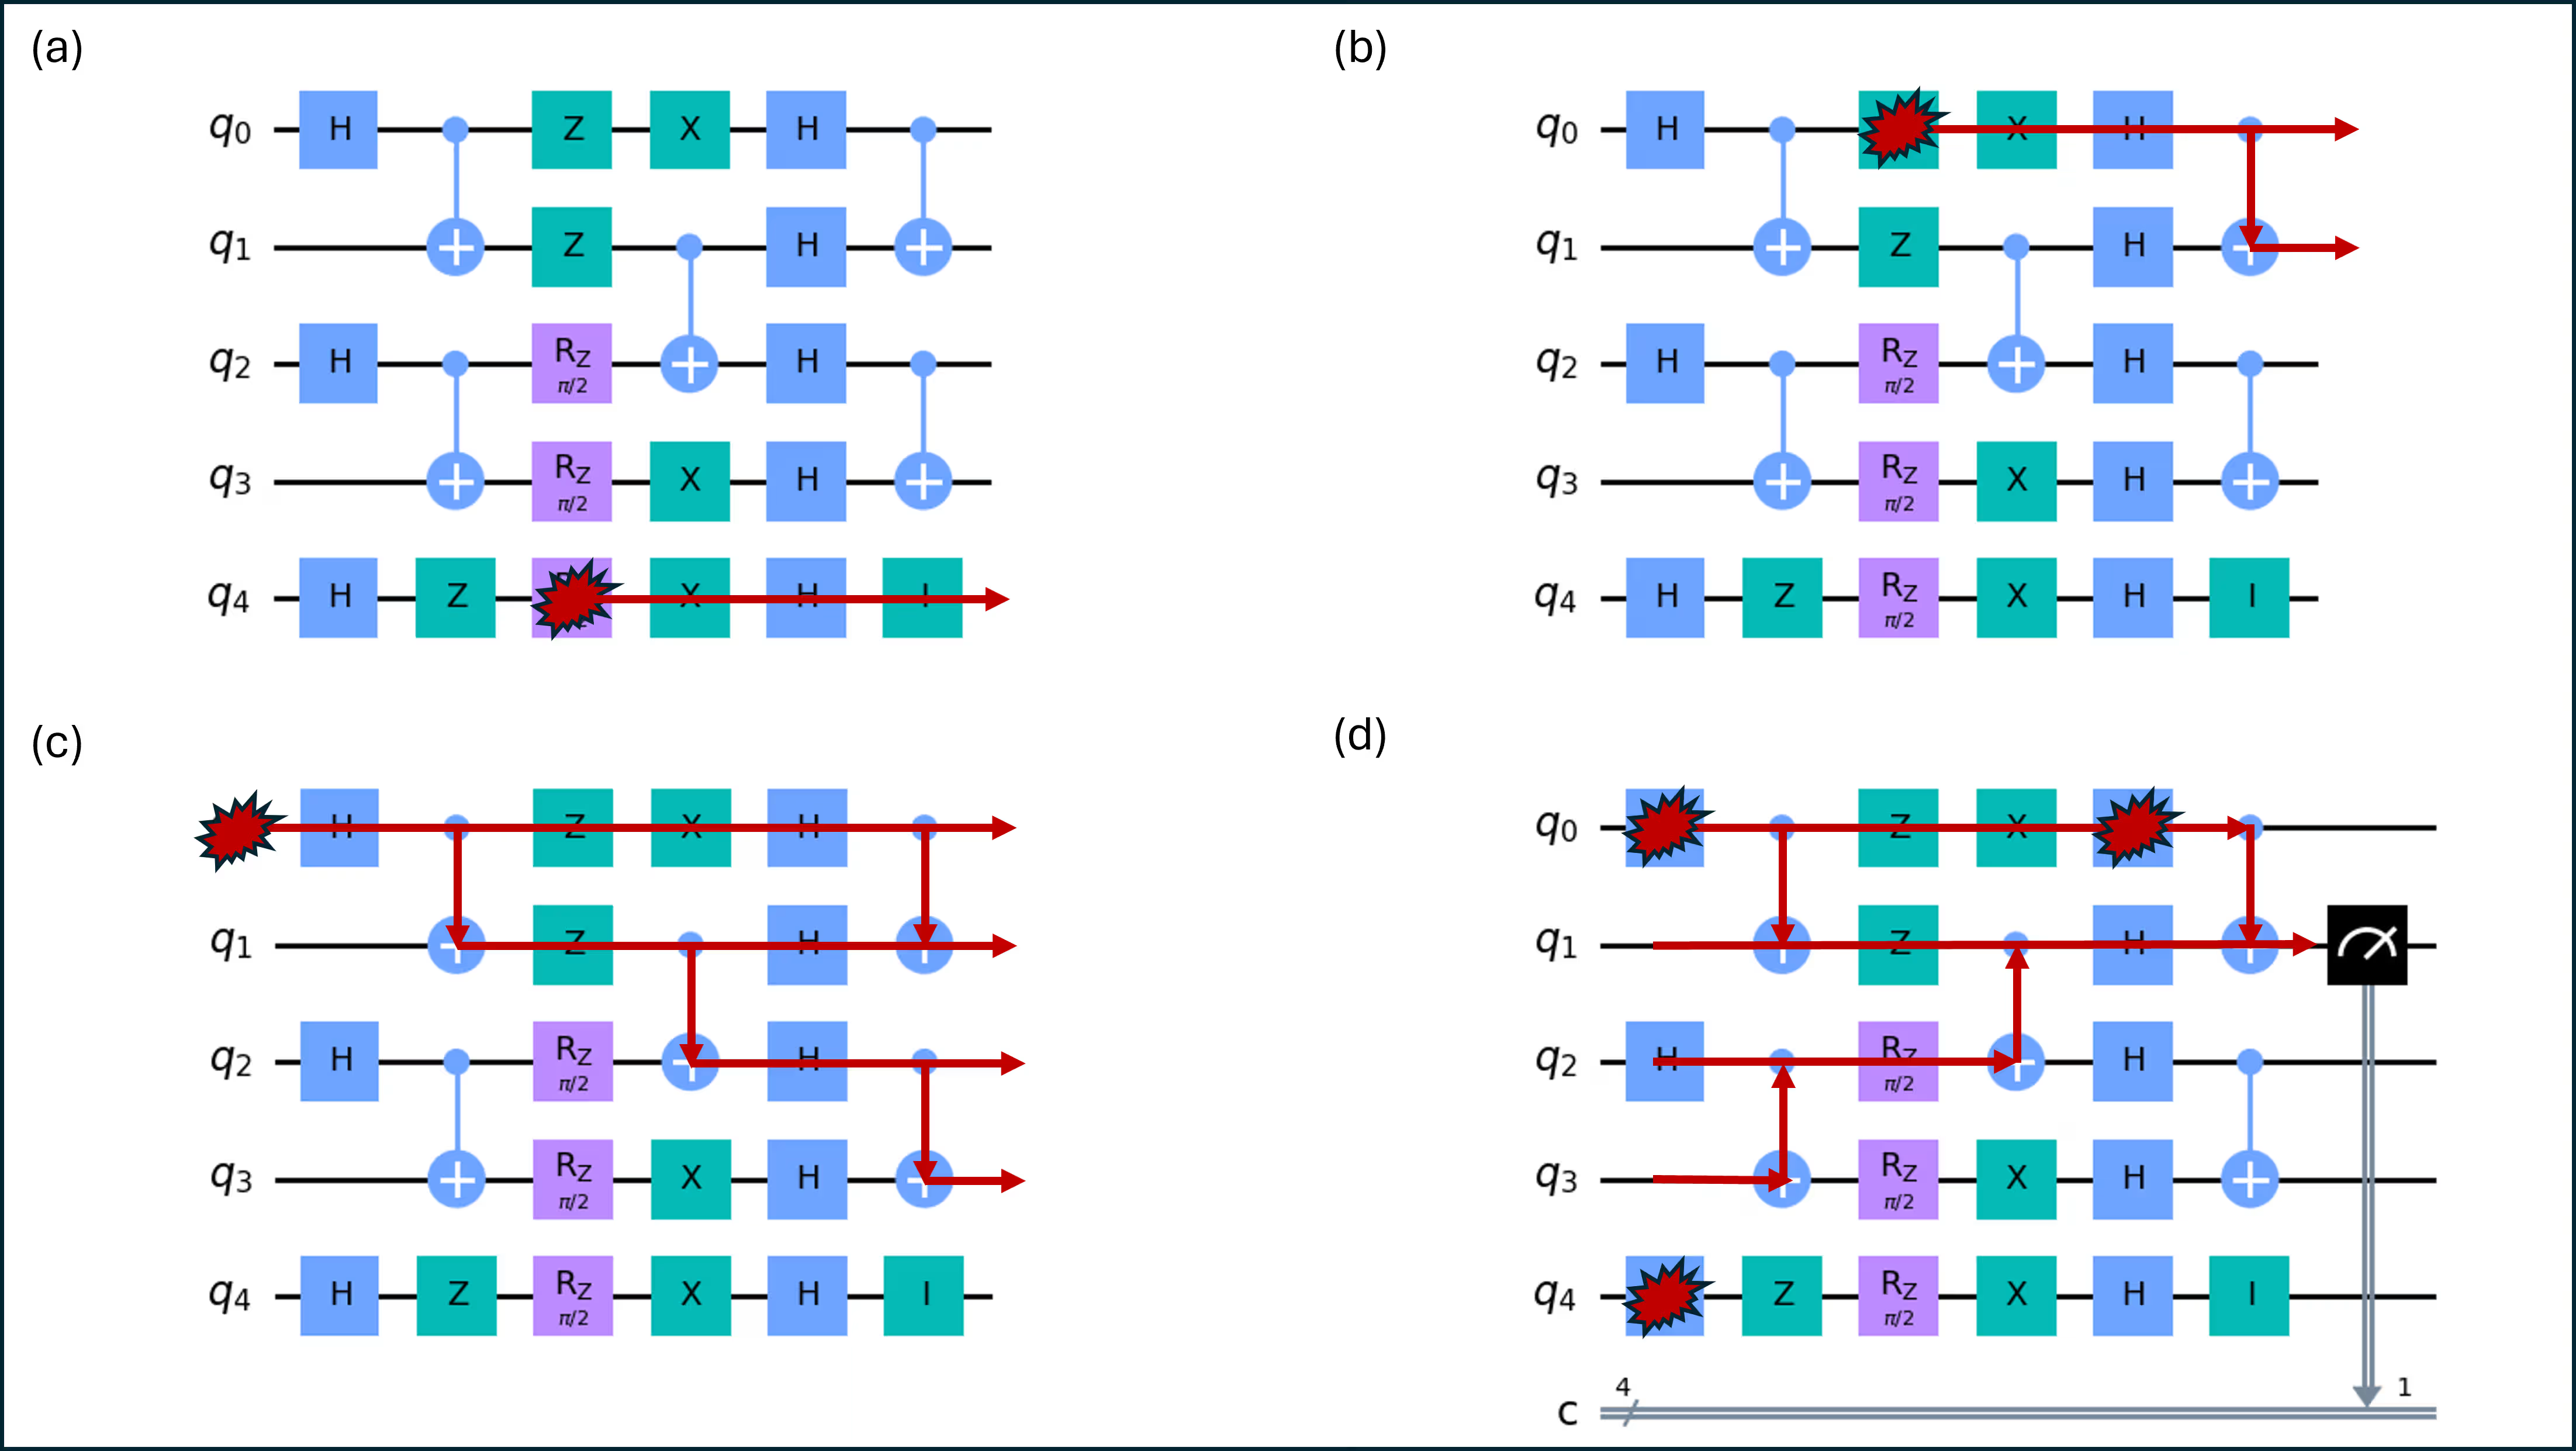
Хоча ви, можливо, не думали про це в такий спосіб, це свого роду просторово-часова діаграма. Вертикальна вісь на квантовій схемі представляє різні кубіти, розташовані в просторі. Горизонтальна вісь представляє час, протягом якого застосовується послідовність вентилів. Запозичуючи мову теорії відносності, світловий конус представляє область простору-часу, досяжну з певної точки за допомогою причинних взаємодій.
На рисунку вище тип помилки не було вказано. Виявляється, що тип помилки впливає на світловий конус, оскільки деякі помилки впливають на логіку двокубітного вентиля, а інші — ні. Ми повернемося до цього незабаром. Наразі вважатимемо жовті лінії шляхами потенційного поширення певного типу помилки. Зверніть увагу, наприклад, у частині (a) рисунка, що однокубітна помилка на вентилі RZ у кубіті 4 може поширюватися вперед у часі лише на цьому одному кубіті. Вона не може поширитися на інші кубіти, оскільки кубіт 4 не заплутаний з жодним іншим кубітом. Це гарний момент, щоб зазначити, що кубіт 4 є доволі непотрібним у цій схемі, і справді, вся схема побудована лише з педагогічною метою.
Проте помилка на вентилі Z кубіта 0 (не обов'язково Z-помилка, просто якась помилка в цьому місці) могла б поширитися на інший кубіт: кубіт 1, через фінальний CNOT, який використовує кубіт 0 як керуючий, а кубіт 1 як цільовий. Це показано в частині (b). Як і слід було очікувати, помилка раніше в схемі часто матиме шанс поширитися на більшу кількість кубітів. Частина (c) показує, що помилка в початковій підготовці стану кубіта 0 може поширитися на всі кубіти, крім кубіта 4, який ізольований.
Ця схема показує, як помилка може поширюватися вперед у часі, впливаючи на вимірювання. Але можна також розглянути зворотне питання: для конкретного однокубітного вимірювання, які частини моєї схеми могли внести в нього якусь помилку? У такому разі потрібно просто почати з вимірювання чи іншої точки інтересу і рухатися назад (у часі) через схему, слідуючи за будь-якими заплутуючими схемами, як показано в частині (d). Також показано кілька випадково обраних точок виникнення помилок.
На рисунку вище помилки поширюються між кубітами через вентилі ECR, але подібне обговорення можна застосувати й до інших двокубітних вентилів. Ці вентилі мають керуючий і цільовий кубіти. Очевидно, що помилка на керуючому кубіті може вплинути на логіку вентиля і тим самим призвести до помилки на цільовому кубіті. Але що щодо зворотного напрямку? Чи може помилка на цільовому кубіті поширитися на керуючий кубіт? Пригадаймо, що зв'язок між керуючим і цільовим кубітами для вентилів ECR — не суто ідеальний тип ZX; він також має небажаний зв'язок ZZ.
Якщо помилка на цільовому кубіті комутує зі зв'язком ZZ, то вона не може поширитися на керуючий кубіт. Це можна побачити через фізичні механізми, що діють. Швидкий спосіб побачити це такий: якщо помилка комутує з , то їхній порядок можна поміняти місцями без впливу на результат. Однак якщо виникнення безпосередньо перед зв'язком дає той самий результат, що й дія після зв'язку , то це не може вплинути на керуючий кубіт, оскільки в останньому випадку помилці довелося б рухатися назад у часі. Якщо помилка не комутує зі зв'язком ZZ, то вона справді може поширитися з цільового кубіта назад на керуючий. Таким чином, у випадку вентиля ECR Z-помилки не можуть поширюватися з цільового кубіта на керуючий, а X- або Y-помилки можуть.
Перевір своє розуміння
У частині (d) рисунка вище погляньте на вертикальні лінії між кубітами 0 та 1. Чи правильно, що деякі помилки можуть поширюватися вздовж цих ліній? Знову ж таки, це може залежати від типу помилки, і ми ще не обговорювали це. Питання полягає в тому, чи існує будь-яка помилка, яка могла б поширюватися так, як показано цими вертикальними лініями. Поясніть.
Відповідь
Так, вони мають рацію. Малюючи світловий конус назад від вимірювання, може здатися, що ви стверджуєте, ніби щось рухається від цільового кубіта до керуючого. Однак насправді значення діаграми полягає в тому, що помилка могла перейти від керуючого кубіта (кубіт 0) до цільового кубіта (кубіт 1), щоб спричинити помилку в точці інтересу. Якщо ваша інтуїція підказує, що це залежить від типу помилки, ви абсолютно праві. Це частково розглядається в наступному розділі.
Починаючи з безпомилкової версії схем на діаграмі вище, простежте потенційне поширення помилки в першому вентилі Адамара, що діє на кубіт 2. Перелічіть усі кубіти, які могли б бути порушені до кінця схеми, якщо помилка є (a) фазовим переворотом і (b) бітовим переворотом. Підказка: подумайте про те, як використовується інформація на кожному кубіті.
Відповідь
(a) Може бути порушений кубіт 3, а також, очевидно, сам кубіт 2. Більше жодних! Якщо ви вказали кубіти 0 та 1, зауважте, що кубіт 2 є цільовим для ECR, що заплутує його з кубітом 1. У цьому вентилі кубіт 1 не змінюється. (b) Можуть бути порушені кубіти 0-3. Бітовий переворот, або помилка X-типу, не комутує зі зв'язком ZZ у вентилі ECR, і тому може поширюватися з цільового кубіта на керуючий.
Поширення помилок
У попередньому розділі ми обговорювали поширення помилок, не давши цьому формального визначення. Надалі:
Для помилки , що виникає перед якоюсь частиною логічного навантаження схеми , поширення помилки означає знаходження еквівалентного оператора , який відтворює той самий помилковий результат, якщо застосувати його після замість перед ним.
Зображення поширення помилок у попередньому розділі демонструвало, що помилки можуть поширюватися з керуючого кубіта на цільовий через вентиль CNOT. Один зі способів перевірити, коли це справедливо, — розглянути помилку на керуючому чи на цільовому кубіті до заплутування і перевірити, чи комутує цей оператор із вентилем CNOT. Якщо два оператори комутують, то немає різниці, чи застосовувати їх у зворотному порядку, а це означає, що помилку можна просто «перенести повз» CNOT без будь-якого впливу на інші кубіти. Це найпоширеніший спосіб, у який люди підходять до поширення помилок, і він дає такі правила:
Нехай керуючим є кубіт 0, а цільовим — кубіт 1. Розгляньмо помилки X та Z на керуючому та цільовому кубітах (, , та відповідно). Перенесення цих помилок повз призводить до того, що помилки стають такими:
Ми наводимо вищесказане без доведення. Але якщо ви, як і автор цього уроку, віддаєте перевагу картині Шредінгера, ви також можете записати довільні стани керуючого та цільового кубітів, застосувати помилку, потім CNOT, і дослідити кінцевий стан. Якщо порівняти цей кінцевий стан із безпомилковим випадком, можна побачити, яка комбінація помилок, застосована після CNOT, дала б помилковий стан, і зокрема, побачити, чи поширилася операція помилки з одного кубіта на інший.
| Керуючий, початковий | Цільовий, початковий | Помилка | Кінцевий | Еквівалент помилки після CNOT |
|---|---|---|---|---|
| Немає | Не застосовується | |||
| X на керуючому | ||||
| Z на керуючому | ||||
| X на цільовому | ||||
| Z на цільовому |
Можливо, дивно, але Z-помилка на цільовому кубіті справді спричиняє поширення помилки назад на керуючий кубіт!
Як можна уявити, відстеження такого поширення операторів помилок вперед крізь схеми (або еквівалентно, поширення назад операторів, які вимірюються) є складним. Qiskit має інструменти для полегшення цього, про які ми дізнаємось в уроці 6, присвяченому сучасним робочим процесам.
Існує додаток Qiskit під назвою Shaded Lightcones. Додаток shaded lightcones (SLC) аналізує поширення помилок у квантових схемах, використовуючи поширення Паулі для визначення того, які частини схеми можуть насправді впливати на цільову спостережувану величину. Він розроблений передусім для того, щоб зробити пом'якшення помилок ефективнішим, особливо для робочих процесів ймовірнісного скасування помилок (PEC). Тут ми лише коротко розглянемо цей інструмент, а ширше використаємо його в контексті методів пом'якшення помилок у майбутніх уроках. Він використовує поширення операторів Паулі для відображення поширення помилок різних типів, створюючи світловий конус для помилок типу X, Y та Z.
Затінені світлові конуси (SLC, Shaded Lightcones) йдуть далі, використовуючи класичні симуляції для більш точного обмеження чутливості до помилок протягом усієї схеми. Це обмінює частину часу QPU на час CPU та зменшує накладні витрати на семплування, потрібні для перенормування зміщення. Замість жорсткого порогу, кожній потенційній помилці в схемі присвоюється градуйований «відтінок», який обмежує зверху чутливість спостережуваної величини до цієї помилки. Ця вдосконалена характеристика дозволяє ефективніше та цілеспрямованіше застосовувати PEC зі зменшеною дисперсією, водночас надаючи користувачеві можливість контрольовано налаштовувати зміщення в оцінці спостережуваної величини. Докладніше див. Lightcone shading for classically accelerated quantum error mitigation.
Ми не наводитимемо тут повний робочий процес. Ми просто схематично покажемо, як цей робочий процес обробляє схему:

Робочий процес розділяє схему на «блоки», корисні для вивчення поведінки шуму:

Нарешті, він використовує поширення операторів і навчання щодо шуму, щоб побудувати затінену карту чутливості до помилок протягом усієї схеми:
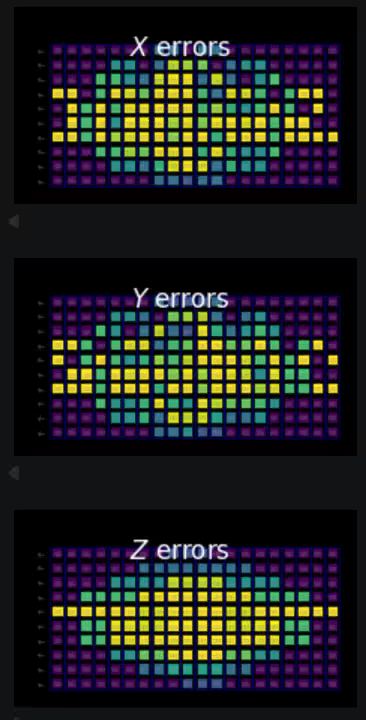
Кожен кольоровий блок на виході відповідає конкретному кубіту в конкретний момент часу. Найтемніші (фіолетові) блоки вказують на кубіт і шар, у якому помилка не може поширитися до вимірювання(-нь), що цікавлять. Найяскравіші (жовті) блоки відповідають кубіту і шару, у якому помилка може мати сильний вплив на вимірювання(-я), що цікавлять.
Зверніть увагу на фіолетові області праворуч на кожній карті. Помилка на тому ж шарі, що й вимірювання, але на іншому кубіті, не може вплинути на вимірювання через показану зв'язність схеми. Аналогічно, помилка на один шар назад у часі (на один шар лівіше) може поширитися лише на сусідній кубіт на наступному кроці через структуру шару заплутування, і так далі. Тому конусоподібна форма праворуч є типовою, коли у вимірюванні, що цікавить, задіяно відносно небагато кубітів.
Перевір своє розуміння
Як ви думаєте, краще будувати карту затіненого світлового конуса до чи після транспіляції? Чому?
Відповідь
Це потрібно робити після транспіляції. Щоб ці різні карти були корисними, ми маємо переконатися, що сусідні кубіти в нашій схемі відповідають сусіднім кубітам на нашому квантовому чипі. Інакше вентилі заплутування, показані як такі, що діють на сусідні кубіти на діаграмі схеми, зрештою вимагатимуть вентилів SWAP і складнішої структури схеми.