Пом'якшення помилок
Цей урок надає передумови щодо різних технік пом'якшення помилок, щоб допомогти користувачам виробити інтуїцію щодо того, як і коли їх найкраще використовувати. Важливо, що сучасні застосування цих технік використовують досконаліші інструменти, як-от Samplomatic, Shaded Lightcones та Executor. Ці робочі процеси буде розглянуто в наступних уроках.
Це відео дає огляд технік пом'якшення помилок. Текст нижче додає деталей і досліджує ці методи за допомогою Qiskit.
Огляд технік пом'якшення помилок
Пом'якшення помилок — це будь-який процес, що намагається зменшити вплив помилок у квантових обчисленнях після того, як вони виникли. Воно відрізняється від придушення, яке намагається запобігти помилкам, і від корекції помилок, яка кодує інформацію в багатьох фізичних кубітах і перевіряє узгодженість цієї інформації, щоб зберегти інформацію в одному логічному кубіті. Протягом цього уроку техніки пом'якшення помилок найкраще розуміти як методи побудови кращих оцінювачів ідеальних очікуваних значень або кращих семплерів розподілів імовірностей, а не як методи корекції квантових станів під час виконання. Ми розглянемо наведені нижче методи пом'якшення помилок, усі з яких доступні в Qiskit та його адонах і є перспективними інструментами на шляху до квантової переваги.
Усунення помилок зчитування за допомогою твірлінгу (TREX) рандомізує процес вимірювання, застосовуючи випадково вибрані операції Паулі перед вимірюванням, а потім класично скасовуючи їхній відомий вплив на спостережені бітові рядки. За відповідних припущень щодо шуму вимірювання це перетворює канал помилок зчитування на простішу та симетричнішу форму, яку легше калібрувати та пом'якшувати.
Безматричне пом'якшення помилок вимірювання (M3) — це масштабована техніка пом'якшення помилок вимірювання, яка уникає явної побудови матриці призначень або її оберненої.
Екстраполяція до нульового шуму (ZNE) наближає значення, яке мала б спостережувана за відсутності шуму, штучно масштабуючи шум на відомий коефіцієнт і екстраполюючи назад до випадку нульового шуму. Це вимагає, щоб шум масштабувався передбачуваним чином. Для цієї передбачуваності можуть знадобитися інші методи, розглянуті в цьому уроці (розтягування імпульсів, згортання вентилів і ймовірнісне підсилення помилок (PEA)).
Ймовірнісне скасування помилок (PEC) — одна з найпотужніших, але й найдорожчих обчислювально технік пом'якшення помилок. Воно працює, вивчаючи шумову поведінку системи та намагаючись скасувати шум шляхом статистичної побудови незміщеної оцінки ідеального обчислення. PEC видає статистично скориговані спостережувані, а не результати з виправленими помилками.
Тепер ми заглибимося в кожен із цих методів.
M3
Помилки вимірювання — одне з найстійкіших і найспецифічніших для апаратури джерел шуму в квантових пристроях найближчого майбутнього. Навіть коли квантовий стан підготовлено та еволюціоновано правильно, фінальний крок зчитування може хибно повідомити справжній результат у обчислювальному базисі. Ці помилки виникають через недосконале розрізнення фізичних станів, що відповідають та , релаксацію під час вимірювання та недосконалість вимірювальної електроніки. Як наслідок, спостережений розподіл бітових рядків часто є спотвореною версією справжнього (ідеального) розподілу, у якій імовірність помилково перерозподілена між результатами.
Пом'якшення вимірювань розв'язує цю проблему, явно моделюючи, як результати вимірювань призначаються хибно. У стандартному формулюванні така поведінка описується матрицею призначень , елементи якої задають імовірність записати результат , коли справжнім базисним станом був . Якщо шум вимірювання класичний і стаціонарний, спостережений вектор імовірностей пов'язаний з ідеальним розподілом простим лінійним співвідношенням,
Зауважте, що матриця призначень — це класичне стохастичне відображення, а не квантовий канал. Вона діє на класичні результати зчитування, а не на лежачі в основі квантові стани, з яких отримано ці результати.
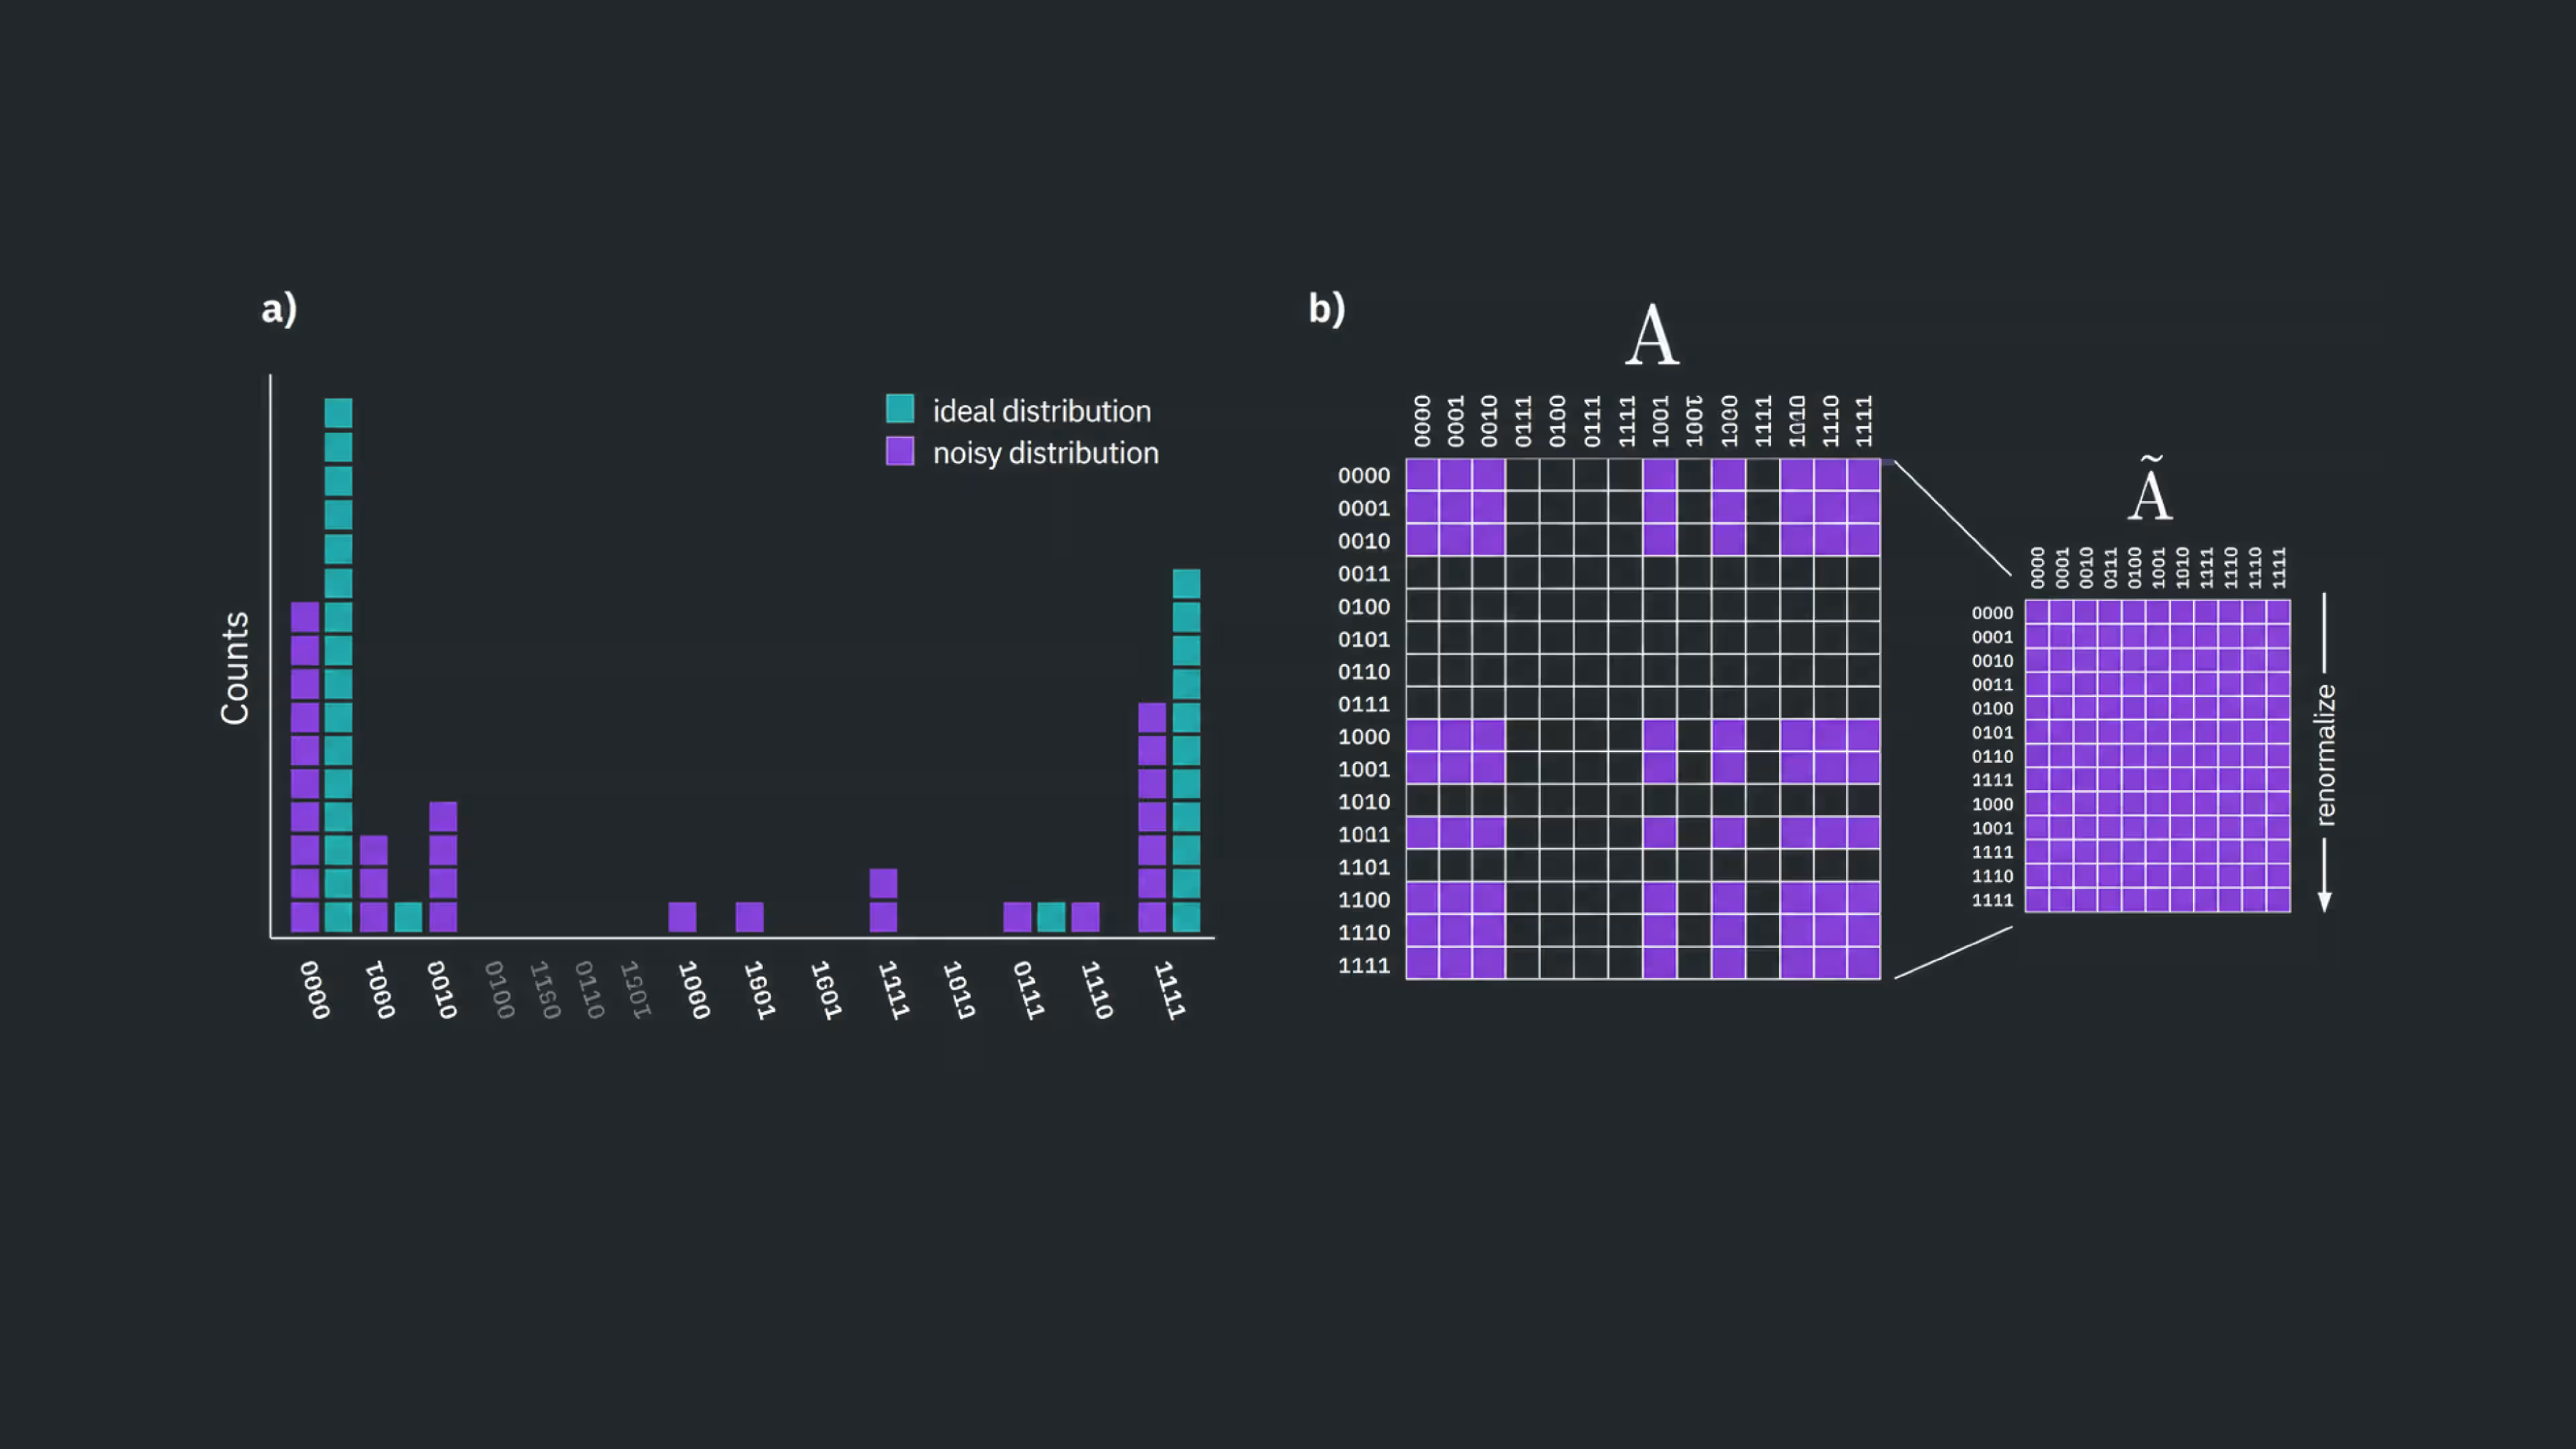
Безматричне пом'якшення вимірювань (M3) використовує цю структуру, щоб побудувати пом'якшену оцінку , ніколи не формуючи й не обертаючи повну матрицю , що було б нездійсненним для великої кількості кубітів. Натомість M3 використовує те, що багато квантових навантажень найближчого майбутнього дають розподіли з різкими піками або з низькою ентропією, тож пом'якшення зосереджується лише на підмножині результатів, які суттєво впливають на спостережений розподіл.
Щоб побудувати модель призначень, на квантовій апаратурі потрібно виконати додаткові калібрувальні експерименти. Зазвичай вони полягають у підготовці відомих станів обчислювального базису та записі того, як їх повідомляє система вимірювання. Накладні витрати на калібрування масштабуються з кількістю виміряних кубітів, тоді як обчислювальна вартість пом'якшення залежить від структури спостереженого розподілу. Ця вартість значно менша за ту, що знадобилася б для явної характеризації повної матриці призначень . Хоча ці накладні витрати на калібрування реальні, вони легкі порівняно з техніками на рівні схеми, як-от екстраполяція до нульового шуму чи ймовірнісне скасування помилок, що робить M3 практичним і широко вживаним інструментом пом'якшення помилок зчитування в експериментах найближчого майбутнього.
Зауважте, що калібрування корисне лише тією мірою, якою процес вимірювання залишається достатньо стабільним між калібрувальними запусками та цільовим експериментом.
Спочатку ми вручну розглянемо простий випадок, щоб показати, як це працює, а потім скористаємося вбудованими в Qiskit інструментами, щоб показати застосування M3 у реалістичнішому масштабі.
Невеликий приклад M3
Починаємо з побудови простого стану Белла.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "mthree": "mthree", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
import numpy as np

qc = QuantumCircuit(2, 2)
qc.h(0)
qc.cx(0, 1)
qc.measure([0, 1], [0, 1])
<qiskit.circuit.instructionset.InstructionSet at 0x714a5fa4d630>
Ми можемо використати симулятор із моделлю шуму, оскільки обмежуємо цей приклад дуже малою схемою. Ми явно налаштовуємо нашу модель шуму так, щоб вона мала помилку зчитування такого вигляду:
if true=0: [95% chance of reading 0, 5% chance of reading 1]
if true=1: [8% chance of reading 0, 92% chance of reading 1]
Ці рівні помилок зчитування набагато вищі за ті, що спостерігаються в реальних квантових комп'ютерах IBM®. Високі значення обрано з педагогічних міркувань, щоб ми могли чітко побачити ефект M3.
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, ReadoutError

ro_error = ReadoutError([[0.95, 0.05], [0.08, 0.92]])

noise_model = NoiseModel()
noise_model.add_readout_error(ro_error, [0])
noise_model.add_readout_error(ro_error, [1])

backend_noisy = AerSimulator(noise_model=noise_model)
Ми можемо запустити схему на шумному симуляторі, щоб побачити вплив помилки зчитування.
result = backend_noisy.run(qc, shots=5000, seed_simulator=123).result()
raw_counts = result.get_counts()
raw_counts
{'01': 290, '11': 2165, '10': 304, '00': 2241}
У нашому демонстраційному прикладі ми самі задали помилку зчитування для нашої моделі шуму. Але на реальному квантовому комп'ютері помилка зчитування апріорі невідома. Натомість її потрібно оцінити експериментально. Для цього ми створюємо схеми, що готують кубіт у відомому стані обчислювального базису або , і вимірюємо його. За відсутності помилки зчитування ми б виміряли саме підготовлений стан. Збираючи статистику з цих вимірювань, ми можемо побудувати матрицю призначень, що описує помилку зчитування. У цьому демонстраційному прикладі вона має виглядати подібно до тієї, яку ми задали.
Для реалістичнішої системи статистику потрібно було б накопичувати для кожного фізичного кубіта. Це іноді нетривіально, тому що транспіляція відображає абстрактну схему на апаратуру, і номер кубіта змінюється. Ми повернемося до цього в наступному прикладі. У цьому прикладі із симулятором ми призначили однакову модель помилки зчитування кожному кубіту, тож достатньо однієї характеризації.
# Define a function to make a state and measure it.
def measure_state(state):
    qc = QuantumCircuit(1, 1)
    if state == 1:
        qc.x(0)
    qc.measure(0, 0)
    return backend_noisy.run(qc, shots=5000, seed_simulator=123).result().get_counts()
# Use the function to get statistics on readout errors
cal_counts_0 = measure_state(0)  # True state = 0
cal_counts_1 = measure_state(1)  # True state = 1

cal_counts_0, cal_counts_1
({'1': 244, '0': 4756}, {'0': 420, '1': 4580})
# Create the normalized readout error matrix

# def normalize(d):
#    s = sum(d.values())
#    return {k: v/s for k,v in d.items()}
# p0 = normalize(cal_counts_0)
# p1 = normalize(cal_counts_1)

p0 = {k: v / sum(cal_counts_0.values()) for k, v in cal_counts_0.items()}
p1 = {k: v / sum(cal_counts_1.values()) for k, v in cal_counts_1.items()}

A_1q = np.array(
    [
        [p0["0"], p1["0"]],  # row: measured 0, columns true 0/1
        [p0["1"], p1["1"]],
    ]
)
A_1q
array([[0.9512, 0.084 ],
       [0.0488, 0.916 ]])
Зауважте, що це дуже близько до матриці помилок зчитування, використаної для побудови симулятора.
Знову ж таки, на реальному квантовому комп'ютері ми мали б подібну статистику для кількох фізичних кубітів. Для цього симулятора ми припускаємо, що два кубіти мають однакові й незалежні помилки зчитування, що дозволяє побудувати двокубітну матрицю призначень A_2q як тензорний добуток відповідних однокубітних матриць. Також зауважте, що суть M3 — не у побудові всієї матриці призначень. Натомість M3 зосереджується на підмножині результатів, які суттєво впливають на спостережений розподіл. Ми побудуємо всю матрицю для нашого дуже малого прикладу, щоб побачити, як це працює. Реалізація M3 у qiskit-ibm-runtime складніша за цей демонстраційний приклад, бо вона має працювати з багатьма кубітами з різними характеристиками зчитування, водночас уникаючи побудови повної матриці призначень.
A_2q = np.kron(A_1q, A_1q)
print(A_2q)
[[0.89794576 0.07107    0.07107    0.005625  ]
 [0.04965424 0.87653    0.00393    0.069375  ]
 [0.04965424 0.00393    0.87653    0.069375  ]
 [0.00274576 0.04847    0.04847    0.855625  ]]
У цьому прикладі ми припускаємо, що помилки зчитування на різних кубітах незалежні, що дозволяє побудувати двокубітну матрицю призначень як тензорний добуток відповідних однокубітних матриць.
Ми отримуємо сирі та пом'якшені результати для порівняння.
bitstrings = ["00", "01", "10", "11"]
# Normalize raw counts
raw_probs = np.array([raw_counts.get(b, 0) for b in bitstrings], dtype=float)
raw_probs /= raw_probs.sum()
raw_probs
array([0.4482, 0.0592, 0.0598, 0.4328])
На цьому етапі ми експериментально охарактеризували, як процес вимірювання спотворює ймовірності ідеальних результатів. Тепер наша мета — скасувати це спотворення та застосувати отриману корекцію до сирих імовірностей.
Оскільки ми виконуємо лінійне обернення, а не фізичну корекцію, отримані "імовірності" не завжди мусять бути додатними. Дуже малі від'ємні квазіймовірності очікувані й відображають те, що пом'якшення вимірювань дає оцінювач, а не фізичний розподіл імовірностей.
# Explicit inversion is feasible only for very small systems
# This is why M3 avoids creating the entire A matrix.

A_inv = np.linalg.inv(A_2q)

# Note: mitigated_probs might contain negative values.
# This is expected and reflects estimator, not physical, probabilities.

mitigated_probs = A_inv @ raw_probs
print(mitigated_probs)
[ 4.96000451e-01 -4.69852308e-04 2.17747967e-04 5.04251654e-01]
Ми перетворюємо їх на підрахунки для побудови графіка.
shots = sum(raw_counts.values())  # e.g., 5000
ideal_probs = [0.50, 0.00, 0.00, 0.50]  # ideal Bell distribution
# Convert probabilities to integer counts for plotting only.
# Not physically meaningful when probabilities are negative

def probs_to_counts(bitstrings, probs, shots):
    """
    Convert a probability vector into a Qiskit-style counts dictionary.
    Ensures integer shot counts and correct normalization.
    """
    counts = {}
    # First convert to raw integer counts
    int_counts = [round(p * shots) for p in probs]
    # Fix rounding error by adjusting the last entry
    diff = shots - sum(int_counts)
    int_counts[-1] += diff
    # Build dict
    for b, c in zip(bitstrings, int_counts):
        if c > 0:
            counts[b] = c
    return counts

mitigated_counts = probs_to_counts(bitstrings, mitigated_probs, shots)
ideal_counts = probs_to_counts(bitstrings, ideal_probs, shots)
Нарешті розглянемо сирий, пом'якшений та ідеальний розподіли. Пом'якшені "підрахунки" нижче — лише допоміжний засіб візуалізації, отриманий перемасштабуванням пом'якшених квазіймовірностей.
from qiskit.visualization import plot_histogram

plot_histogram(
    [raw_counts, mitigated_counts, ideal_counts],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
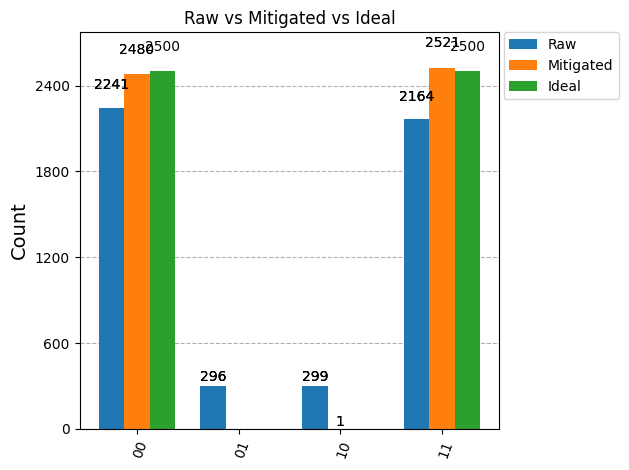
Очевидно, що результати, пом'якшені за допомогою M3, значно ближчі до ідеальних розподілів, і ми можемо зрозуміти чому.
Застосування M3 до реалістичніших робочих процесів значно складніше. Зверніть увагу:
- Реальні квантові комп'ютери містять багато фізичних кубітів, кожен зі своїми характеристиками помилок зчитування. Ці помилки потрібно змоделювати й належним чином поєднати.
- Повна матриця призначень зростає експоненційно з кількістю кубітів і швидко стає непрактичною для явної побудови. Саме тому M3 зосереджується на підмножині результатів, які суттєво впливають на спостережений розподіл, замість побудови всієї матриці призначень.
- Для реальних цікавих задач ідеальний розподіл може бути невідомим.
З усіх цих причин повний робочий процес пом'якшення інкапсульовано в адоні Qiskit mthree.
Більший приклад M3
Тепер ми застосуємо M3 до більшої схеми, для якої визначення відповідного підпростору вручну було б громіздким, але яка все ще достатньо проста, щоб ми знали ідеальний розподіл: стан GHZ. Починаємо з імпорту пакета mthree і визначення квантової схеми GHZ.
import numpy as np
from qiskit import QuantumCircuit

# from qiskit_ibm_runtime.fake_provider import FakeCasablancaV2
import mthree

num_qubits = 10

qc = QuantumCircuit(num_qubits)
qc.reset(range(num_qubits))
qc.h(0)
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)
qc.measure_all()
qc.draw("mpl")
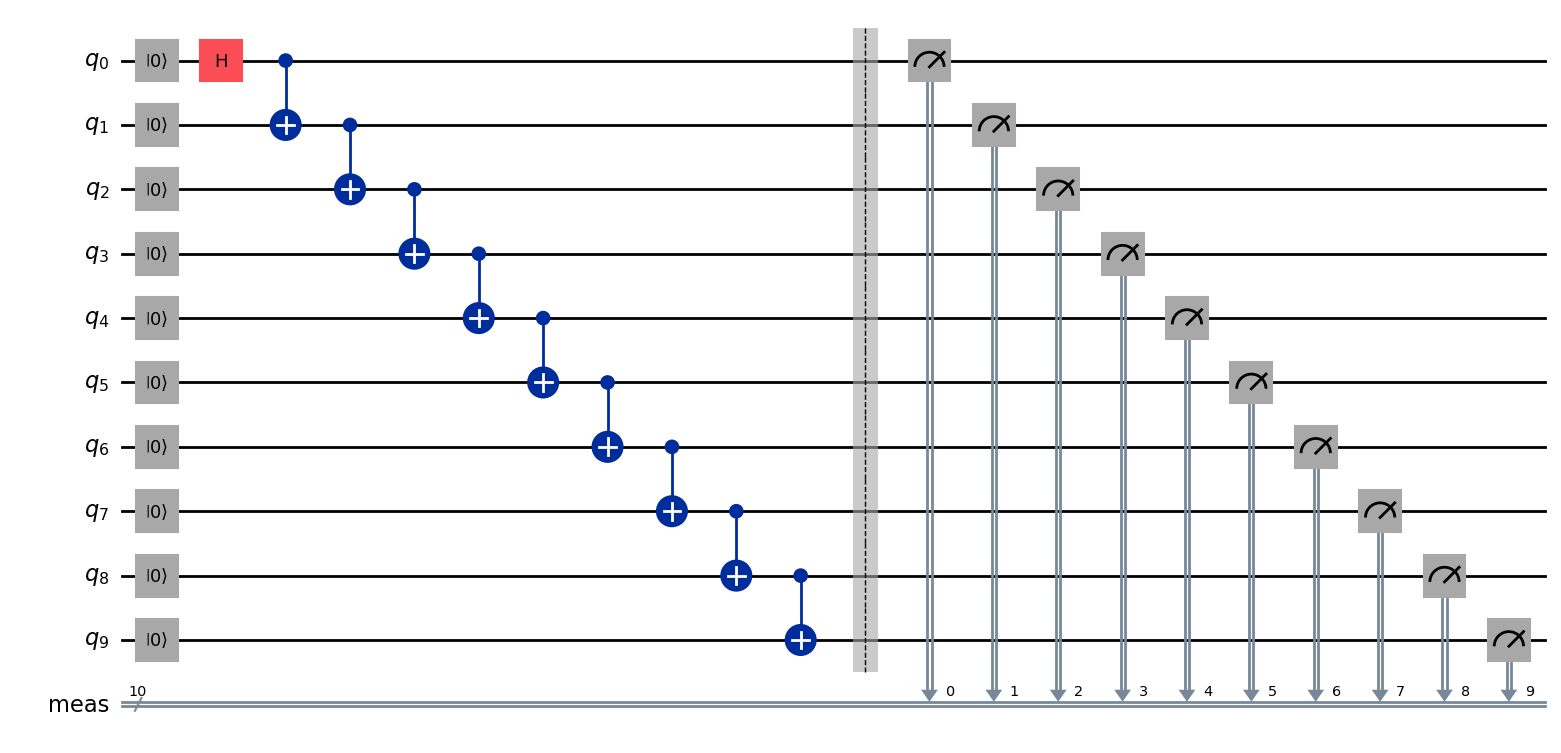
Щоб запустити це на реальному квантовому комп'ютері, імпортуємо qiskit_ibm_runtime та інші необхідні пакети. Ми використовуємо SamplerV2, щоб отримати розподіл результатів.
# Import packages needed for using real quantum computers

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime.executor_sampler import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

# --------- Configuration ----------
service = QiskitRuntimeService(channel="ibm_quantum_platform", instance="your crn here")

# backend_real = service.backend("ibm_fez")     # adjust if needed
backend_real = service.least_busy(simulator=False, operational=True)
Тепер ми транспілюємо схему для нашого бекенда. Тут ми встановлюємо рівень оптимізації 0, щоб зосередитися на ефектах M3, не додаючи інших інструментів. Це означає, що остаточна точність не буде репрезентативною для того, чого можна досягти на апаратурі IBM Quantum® з повним набором доступних інструментів, але дозволяє нам зосередитися саме на корисності M3.
# Exclude any optimization to focus only on M3 effects
opt_level = 0
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend_real)
qc_isa = pm.run(qc)
Тепер ми налаштовуємо Sampler, знову вимикаючи додаткові техніки придушення помилок, як-от динамічне розв'язування та твірлінг.
shots = 8192

# No twirling
sampler_no_twirl = Sampler(mode=backend_real)
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = False
sampler_no_twirl.options.default_shots = shots
sampler_no_twirl.options.dynamical_decoupling.enable = False
Нарешті виконуємо нашу задачу.
# This job took 7 seconds on ibm_fez. Your actual execution time can vary.
job = sampler_no_twirl.run([qc_isa])
res_real = job.result()
job_id = job.job_id()
print("job number for real  ", job_id)
job number for real d7ark4e5nvhs73a2fu6g
Ми можемо отримати сирі підрахунки з наведеної вище схеми.
counts_real = []
for i in range(len(res_real)):
    counts_real.append(res_real[i].data.meas.get_counts())
Тепер запускаємо mthree на нашому бекенді, щоб охарактеризувати модель призначень, яка використовується для пом'якшення вимірювань. Ми перемасштабовуємо сирий розподіл, використовуючи цю інформацію. Зауважте, що іноді це може давати дуже малі від'ємні імовірності (звідси термін квазіймовірності).
# Added 6 sec on ibm_fez, on top of original 7 sec to run circuits. Your time might differ.
mit_real = mthree.M3Mitigation(backend_real)
mappings_real = mthree.utils.final_measurement_mapping(qc_isa)
mit_real.cals_from_system(mappings_real)
quasis_real = mit_real.apply_correction(counts_real, mappings_real)
Корекція mthree дає квазіймовірності, а не підрахунки. Ми можемо перемасштабувати їх у підрахунки вручну. Допоміжна функція нижче перетворює їх у підрахунки та округлює до цілих значень. Крім того, для великих схем буде багато помилкових рядків з дуже малою кількістю підрахунків, які захаращують гістограму. Друга допоміжна функція нижче відсікає всі рядки з кількістю підрахунків, меншою за обраний нами поріг, щоб ми чітко бачили домінантні члени розподілу.
def quasidistribution_to_counts(quasi_list, shots):
    return [
        {bitstr: int(round(float(prob) * shots)) for bitstr, prob in quasi.items()}
        for quasi in quasi_list
    ]

def filter_counts_by_threshold(counts_list, t):
    filtered = []

    for counts in counts_list:
        new_counts = {}
        for bitstr, val in counts.items():
            c = int(round(float(val)))  # FORCE conversion
            if abs(c) >= t:
                new_counts[bitstr] = c
        filtered.append(new_counts)

    return filtered
quasi_counts = quasidistribution_to_counts(quasis_real, shots)
trim_threshold = 30
trimmed_quasi = filter_counts_by_threshold(quasi_counts, trim_threshold)
trimmed_raw = filter_counts_by_threshold(counts_real, trim_threshold)
Ми також легко можемо отримати теоретичний ідеальний розподіл, у якому стани з усіма нулями та з усіма одиницями мають рівні імовірності, а всі інші результати — нульову імовірність, для порівняння.
ideal = [
    {
        "0" * num_qubits: int(round(float(shots) / 2)),
        "1" * num_qubits: int(round(float(shots) / 2)),
    }
]
Нарешті, ми можемо візуалізувати наші результати.
from qiskit.visualization import plot_histogram

plot_histogram(
    [trimmed_raw[0], trimmed_quasi[0], ideal[0]],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
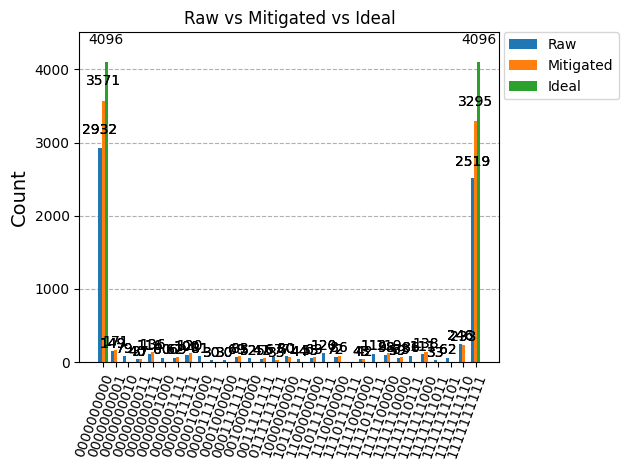
Пом'якшені результати ближчі до ідеального розподілу, ніж непом'якшені. Ми можемо краще кількісно оцінити це, використовуючи підрахунки для ідеальних бітових рядків.
def extract_all_zero_and_all_one(counts):
    """
    Extract counts for the all-0 and all-1 bitstrings.

    Parameters
    ----------
    counts : dict[str, int]
        Counts dictionary.

    Returns
    -------
    dict[str, int]
        Dictionary containing only 00...0 and 11...1 entries if present.
    """
    n = len(next(iter(counts)))  # infer bitstring length
    zero_state = "0" * n
    one_state = "1" * n

    return {k: counts[k] for k in (zero_state, one_state) if k in counts}

correct_counts_raw = extract_all_zero_and_all_one(trimmed_raw[0])
correct_counts_mitigated = extract_all_zero_and_all_one(trimmed_quasi[0])
keys = ["0" * num_qubits, "1" * num_qubits]
fidelity_raw = (
    correct_counts_raw.get(keys[0]) + correct_counts_raw.get(keys[1])
) / shots
fidelity_mit = (
    correct_counts_mitigated.get(keys[0]) + correct_counts_mitigated.get(keys[1])
) / shots
print("Percent correct raw counts: ", fidelity_raw)
print("Percent correct mitigated counts: ", fidelity_mit)
Percent correct raw counts:  0.6654052734375
Percent correct mitigated counts:  0.838134765625
Цей простий інструмент покращив нашу точність на 26% відносно непом'якшеної точності за досить низьких накладних витрат. Очевидно, M3 може бути дуже цінним. Але схему GHZ було обрано як вдалий приклад, бо вона має різкі піки на двох вихідних станах. Деякі задачі дають рівномірніше розподілені підрахунки (стани з високою ентропією). Для дуже глибоких схем із багатьма кубітами помилки вентилів і шум, не пов'язаний з помилками вимірювання, часто призводитимуть до стану з високою ентропією. У таких випадках M3 працює в доволі великому просторі станів. Є три можливі підходи до цього:
(1) Визнати, що це обмеження M3.
(2) Зауважте, що верхня межа простору матриці, яку формує M3, — це num_shots num_shots, а не , причому перше значно менше для великої кількості кубітів .
(3) Лише з великою обережністю видаляйте бітові рядки з дуже низькою імовірністю із сирих підрахунків, що подаються в M3. Це може внести зміщення, а обмеження носія ваших станів може заважати збіжності в підходах на кшталт методу Крилова. Це слід робити лише тоді, коли ви точно знаєте, навіщо це робите, і можете передбачити всі наслідки. Саме тому таке відсікання не є вбудованою функцією M3.
Щоб дізнатися більше про адон Qiskit mthree, дивіться приклади, інструкції зі встановлення, передумови та довідник API у його документації.
Усунення помилок зчитування за допомогою твірлінгу (TREX)
Усунення помилок зчитування за допомогою твірлінгу (TREX) — це техніка пом'якшення помилок вимірювання, що використовується на сучасних квантових комп'ютерах. Її мета — усунути зміщення, внесене класичними помилками зчитування, без потреби в повній характеризації або обернені матриці призначень вимірювання.
TREX не є корекцією помилок і не покращує точність стану. Натомість вона забезпечує, що оцінювачі очікуваних значень є незміщеними щодо шуму зчитування, з точністю до статистичної похибки, шляхом усереднення за рандомізованими базисами вимірювання та перемасштабування. На апаратурі IBM Quantum TREX є методом пом'якшення за замовчуванням для оцінювання очікуваних значень і відповідає resilience_level = 1 у примітиві IBM Quantum Estimator.
Природа помилок зчитування на надпровідній апаратурі
На надпровідних кубітах IBM помилки зчитування переважно зумовлені:
-
Асиметричними ймовірностями інверсії бітів (наприклад, частіше, ніж навпаки)
-
Залежною від стану релаксацією під час самого вимірювання
-
Незначними, але не нехтовними перехресними завадами між сусідніми резонаторами зчитування
Важливо, що ці помилки часто можна моделювати як класичний стохастичний процес, що діє на результати вимірювань. TREX використовує стандартну ідею з підгонки шуму: рандомізацію (твірлінг) процедури вимірювання. TREX зазвичай складається з двох етапів:
-
Твірлінг і класичний "антитвірлінг"
-
Перемасштабування очікуваних значень за допомогою калібрувальних схем
Припустімо, що очікуване значення спостережуваної пов'язане із шумними оцінками так:
де — фіксований коефіцієнт, що масштабує оцінку, а — зміщення від джерел, описаних вище. Ми використовуємо тут як нагадування, що ми розглядаємо лише помилку зчитування; помилку вентилів ще потрібно враховувати.
Безпосередньо перед вимірюванням кожен кубіт випадково спряжується з оператором Паулі (наприклад, I або X). Результати вимірювань потім класично "розкручуються".
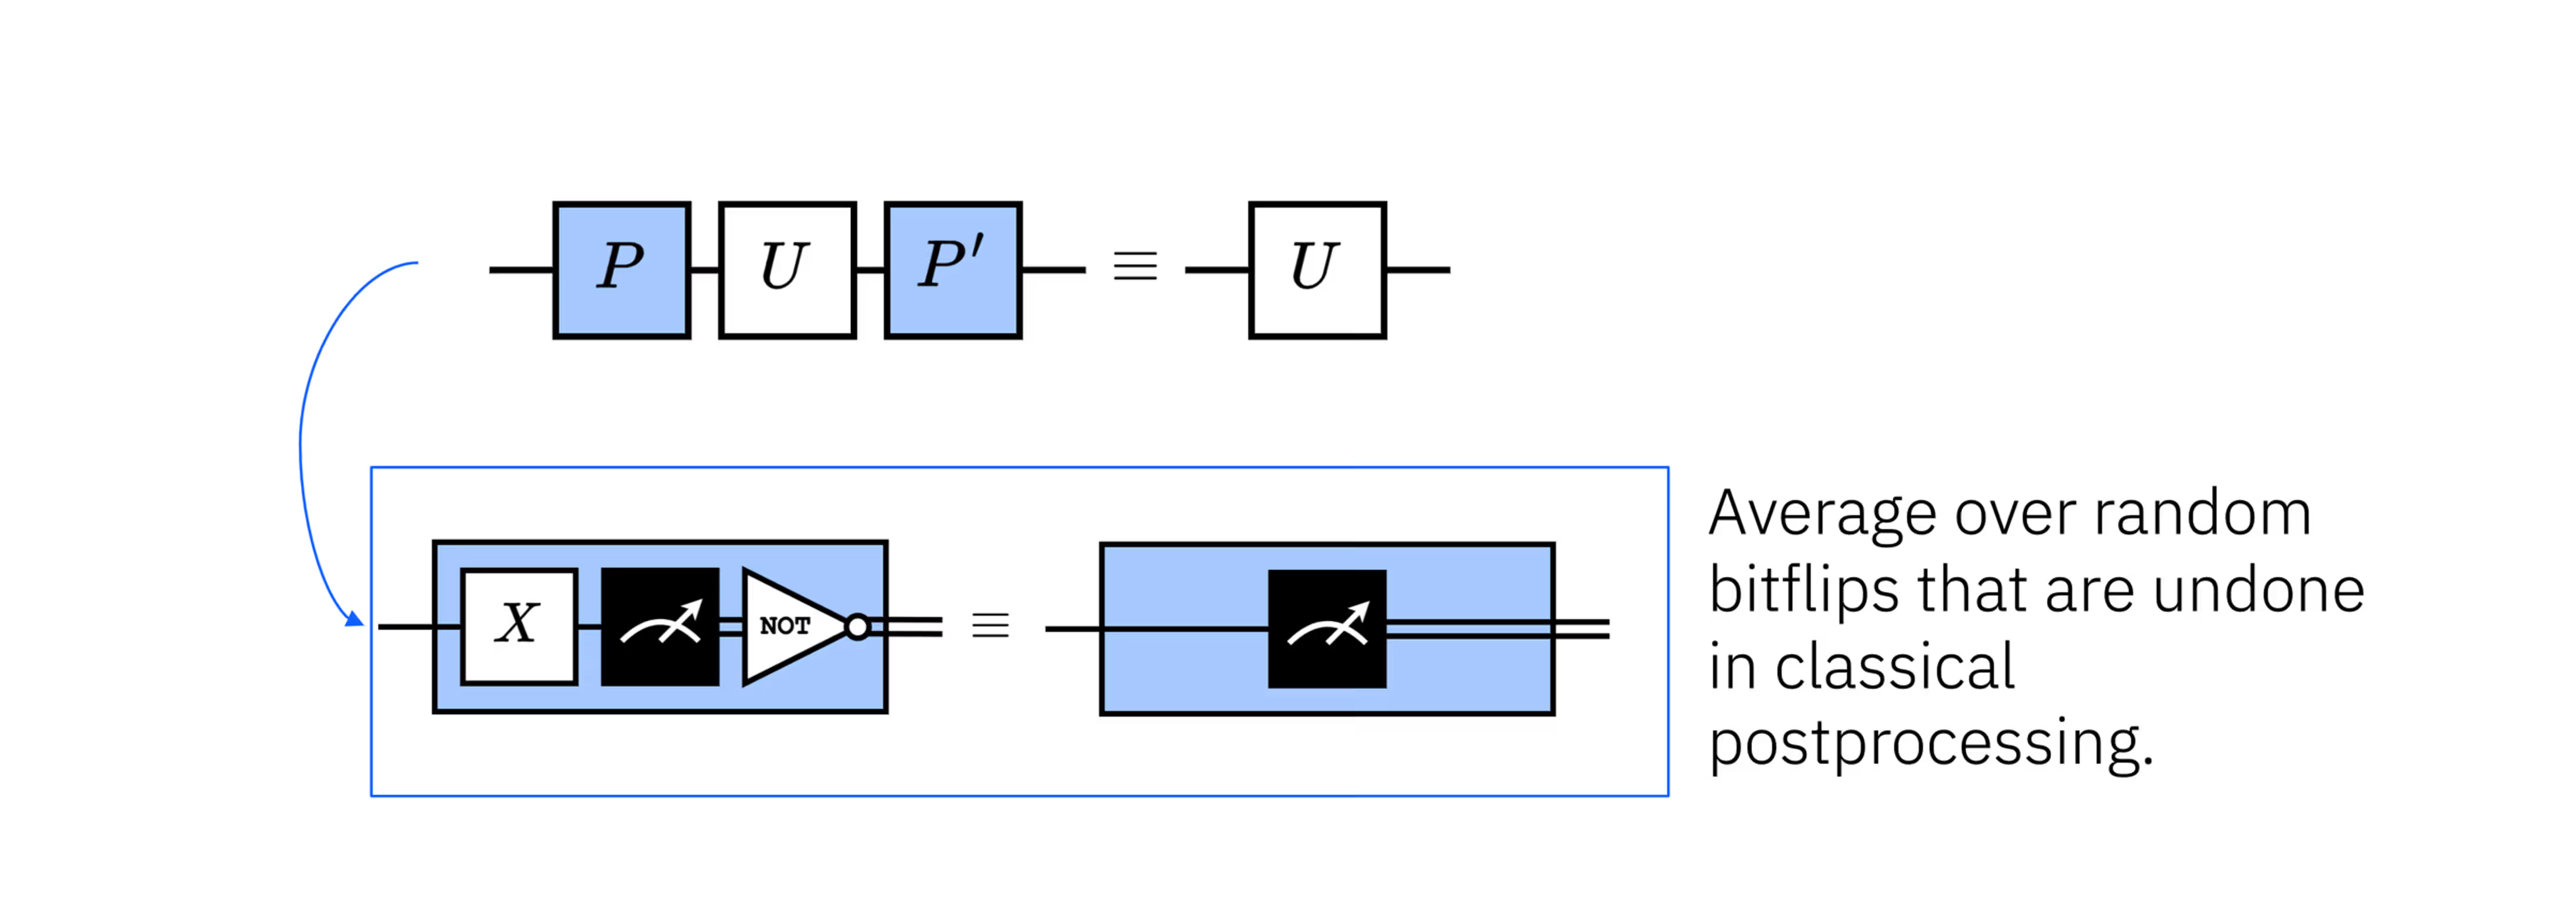
Усереднення за цими рандомізаціями симетризує канал зчитування. Як наслідок, систематичні асиметрії в процесі зчитування перетворюються на симетричніший канал помилок, залишковий вплив якого можна врахувати через калібрування та перемасштабування. Простими словами, якби, наприклад, було зміщення на користь стану , ми б пропускали частину вимірювань . Застосовуючи твірлінг навколо вимірювання, ми випадково міняємо місцями, який логічний результат пов'язаний з фізичним процесом зчитування, а потім класично скасовуємо цю заміну. Усереднення за багатьма такими рандомізованими вимірюваннями усуває систематичну перевагу одного повідомленого результату над іншим. Це усуває домінантне зміщення вимірювання за припущень моделі TREX, тож маємо:
Проте очікувані значення все ще можуть потребувати перемасштабування. Другий етап — використання калібрувальних схем (схем зі відомими результатами) для оцінки коефіцієнта масштабування . Це потім можна використати для отримання значно кращої оцінки.
Очікувані значення спостережуваних Паулі стають незміщеними оцінювачами їхніх ідеальних значень. Жодна явна модель шуму не вивчається й не обертається, тому TREX чисельно стабільний і недорогий. Знову ж таки, помилку вентилів тут не розглянуто.
Під час оцінювання очікуваного значення спостережуваної може бути дисперсія через скінченну вибірку, може бути багато типів некогерентних і когерентних помилок, а також може бути зміщення через помилку зчитування. Це зміщення виникає від таких джерел, як асиметричні переходи, які ми обговорювали. На практиці це зміщення зазвичай добре моделюється як класичний стохастичний канал, що діє після квантової еволюції. TREX перетворює ефективний канал вимірювання так, що оцінювач стає незміщеним щодо помилки зчитування. Це порівняно легко побачити на найпростішому прикладі твірлінг-вентилів: X. Якщо є асиметрія порівняно з , але ми випадково міняємо, який стан зчитується (потім класично повертаючи назад), то це очевидно усуває систематичну асиметрію (хоча скінченна вибірка все ж означає, що у вимірюванні може лишитися невелика стохастична асиметрія). На практиці твірлінг-вентилі для TREX не обмежуються I та X, але для пояснення цього достатньо.
TREX дозволяє отримати оцінку очікуваного значення, вільну від зміщення через помилку зчитування. Усе ще може бути зміщення від іншого джерела (наприклад, когерентного надмірного обертання); TREX націлений лише на зчитування. Оскільки TREX замінює систематичне зміщення рандомізованою симетризацією, вона загалом перетворює зміщення на додаткову стохастичну дисперсію, збільшуючи дисперсію оцінювача за фіксованої вартості вибірки.
Перевірте своє розуміння
Припустімо, ми використовуємо Estimator на схемі, що підготувала стан , для оцінювання . Припустімо далі, що помилки вимірювання призводять до того, що результати, які відповідають , повідомляються як у 10% випадків, тоді як результати, що відповідають , повідомляються як лише в 1% випадків. Асиметрія між цими помилками повідомлення вносить зміщення вимірювання.
(a) За відсутності будь-яких таких помилок вимірювання, яким було б ідеальне очікуване значення спостережуваної ?
(b) З асиметричними помилками вимірювання або зчитування, яке очікуване значення спостережуваної ?
(c) Розгляньте обмежений набір твірлінг-вентилів Паулі: I та X. Припустімо, що I та X застосовуються випадково з імовірністю 50% у кількох шотах. Застосовуються ті самі рівні помилок вимірювання. Потім вентиль Паулі (I або X) класично скасовується. Складіть таблицю всіх можливих результатів та їхніх імовірностей, зумовлених початковою суперпозицією, асиметричними помилками вимірювання та випадково призначеними вентилями Паулі.
(d) Використайте таблицю, щоб визначити очікуване значення за стратегією твірлінгу.
(e) Порівняйте очікувані значення: ідеальне, без твірлінгу та з твірлінгом.
(f) Що було пропущено в цьому розгляді з того, що є в повному застосуванні TREX?
Відповідь
(a) Можна просто скористатися інтуїцією та симетрією, щоб сказати, що . Щоб показати це явно:
(b) Під час вимірювання стан може колапсувати або в , або в , кожен із 50% імовірністю. Але з тих 50%, що колапсують у стан , 1% (або 0,5% усіх випадків) буде хибно повідомлено як . З тих 50%, що колапсують у , 10% (або 5% усіх випадків) буде хибно повідомлено як . Це залишає нам:
- 54,5%
- 45,5% Нехтуючи всіма іншими можливими типами помилок, ми б отримали оцінку
(c)
| Паулі | Ідеальний результат вимірювання | Результат після Паулі | Помилка зчитування | Скасувати Паулі | Остаточно повідомлений результат | Імовірність |
|---|---|---|---|---|---|---|
| I | 0 | 0 | Немає | I | 0 | 50% 50% 99% = 24.75% |
| I | 0 | 0 | I | 1 | 50% 50% 1% = 0.25% | |
| I | 1 | 1 | Немає | I | 1 | 50% 50% 90% = 22.5% |
| I | 1 | 1 | I | 0 | 50% 50% 10% = 2.5% | |
| X | 0 | 1 | Немає | X | 0 | 50% 50% 90% = 22.5% |
| X | 0 | 1 | X | 1 | 50% 50% 10% = 2.5% | |
| X | 1 | 0 | Немає | X | 1 | 50% 50% 99% = 24.75% |
| X | 1 | 0 | X | 0 | 50% 50% 1% = 0.25% |
(d) З попередніх частин ми знаємо очікувані значення Z у кожному з фінальних станів. Нам потрібно лише взяти зважене середнє:
(e) У цьому дуже простому випадку наше застосування твірлінгу точно відновило ідеальне очікуване значення. Це нетипово. Типово те, що твірлінг скасовує зміщення, як-от внесені асиметричними переходами, і повертає очікуване значення, ближче до ідеального.
(f) Це застосування демонстраційної моделі. Може бракувати кількох речей. Зокрема, ми не запускали тут калібрувальні схеми для оцінки коефіцієнта перемасштабування . Зазвичай це необхідно.
Деталі реалізації
TREX автоматично застосовується, коли використовується примітив EstimatorV2 із resilience_level = 1 (за замовчуванням). Зауважте, що він не застосовується автоматично до примітива Sampler, тому що Sampler повертає повні розподіли імовірностей, а не очікувані значення.
Коли TREX увімкнено, runtime генерує варіанти схем із твірлінгом вимірювання, вставляючи випадкові однокубітні оператори Паулі безпосередньо перед вимірюванням. Класична постобробка скасовує ці оператори Паулі. Ці варіанти схем є випадковими для різних шотів, а також для різних кубітів в межах шота. Потім усі варіанти схем об'єднуються в єдиний оцінювач.
TREX дуже масштабований. Він потребує додаткових калібрувальних схем, тож накладні витрати на вибірку зазвичай становлять невеликий постійний множник (часто 2-4x). Але пом'якшення є специфічним для спостережуваної, а не зберігає розподіл.
TREX розроблено для чіткої інтеграції з багатьма методами придушення та пом'якшення помилок, зокрема такими:
-
Динамічне розв'язування (DD) — діє під час простою, ортогонально до пом'якшення зчитування.
-
Твірлінг вентилів або Паулі — часто доповнює; TREX уже спирається на твірлінг, але націлений лише на шум зчитування.
-
Екстраполяція до нульового шуму (ZNE) — ZNE націлена на шум вентилів, а TREX обробляє зміщення вимірювання. Це поєднання використовується на рівні стійкості 2.
-
Ймовірнісне підсилення помилок і ймовірнісне скасування помилок у робочих процесах Estimator.
Однак деякі методи не можна (або не слід) поєднувати з TREX:
-
Корекція імовірностей на рівні Sampler: TREX не повертає скориговані імовірності бітових рядків.
-
Постфактумне пом'якшення вже пом'якшених даних TREX: подвійна корекція може знову внести зміщення.
Поєднувати TREX із пом'якшенням помилок зчитування на основі матриці призначень, як-от M3, непросто. M3 припускає фіксований канал вимірювання. TREX навмисно рандомізує вимірювання, що порушує припущення, яке використовує M3. У цьому сенсі ці методи не можна просто об'єднати. Проте, якщо застосувати твірлінг вимірювань під час калібрування, що використовується в M3, можна одночасно скористатися і підходом, подібним до матриці призначень, і підходом пом'якшення за допомогою твірлінгу (хоча цей підхід із твірлінгом не зовсім збігається з TREX). Це повторювана тема в поєднанні методів пом'якшення та придушення: бездумне додавання методів не працює; додавання їх обережно, так щоб вони «знали» один про одного, може спрацювати і бути дуже корисним.
TREX гарантує лише те, що очікувані значення вільні від зміщення, спричиненого помилками зчитування; він не зменшує дисперсію і не захищає від інших типів зміщення. Він, безумовно, не виправляє всі помилки. Проте це часто суттєве покращення, і його можна досягти з набагато меншими накладними витратами, ніж деякі інші методи, що потребують навчання повних моделей шуму. TREX часто є найдешевшим та найнадійнішим доступним пом'якшенням помилок зчитування, що робить його чудовим вибором за замовчуванням в експериментах.
TREX у Qiskit
Тут ми створюємо просту дикубітну схему та використовуємо Estimator, щоб оцінити очікуване значення дуже простої спостережуваної ZX. Ідеальне очікуване значення дорівнює 1. Ми порівняємо очікувані значення з TREX і без нього.
# Import packages needed for using real quantum computers

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_ibm_runtime import QiskitRuntimeService, EstimatorV2, Session
import numpy as np

# --------- Configuration ----------

backend = service.backend("ibm_fez")  # adjust if needed
Створіть просту квантову схему.
qc = QuantumCircuit(2)
qc.x(0)
qc.h(0)
qc.cx(0, 1)
qc.h(0)
qc.barrier()
qc.draw("mpl")

Транспілюйте схему за допомогою менеджера проходів.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend)

qc_t = pass_manager.run(qc)
Застосуйте до спостережуваної ту саму розкладку, що й під час транспіляції.
# Observable: X on qubit 0, Z on qubit 1, ideal expectation value is 1.0.
observable = SparsePauliOp("ZX")
observable_t = observable.apply_layout(qc_t.layout)
Запустіть експеримент на реальному квантовому комп'ютері. Спершу виконаємо його з reslience_level = 1; це значення за замовчуванням, але ми вказали його явно, щоб розрізнити два випадки.
# First, we run this on an ideal simulator to confirm the ideal expectation value.

from qiskit.primitives import StatevectorEstimator as Estimator

estimator = Estimator()

job = estimator.run(pubs=[(qc, observable)])

res = job.result()
val = res[0].data.evs

print("⟨ZX⟩ ideal:", val)
⟨Z₀⟩ ideal: 0.9999999999999996
# This took 27 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ with TREX:", val)
⟨Z₀⟩ with TREX: 0.9520029143897996
Тепер встановимо resilience_level у 0, щоб запустити без TREX.
# This took 12 sec on ibm_fez. Your runtime might differ.
with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ without TREX:", val)
⟨Z₀⟩ without TREX: 0.8651
Очікуване значення, як і слід було очікувати, суттєво ближче до ідеального (1) із TREX. Звісно, це було одне очікуване значення на одному кубіті. Тепер підготуємо схему з не-кліффордівськими гейтами та багатьма кубітами, щоб перевірити, чи залишається покращення від TREX стійким в іншому режимі.
import numpy as np

num_qubits = 20
qc = QuantumCircuit(num_qubits)
for i in range(num_qubits):
    qc.rx(np.pi * 7 / 8, i)
qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=20, num_clbits=0, params=[]), qubits=(<Qubit register=(20, "q"), index=0>, <Qubit register=(20, "q"), index=1>, <Qubit register=(20, "q"), index=2>, <Qubit register=(20, "q"), index=3>, <Qubit register=(20, "q"), index=4>, <Qubit register=(20, "q"), index=5>, <Qubit register=(20, "q"), index=6>, <Qubit register=(20, "q"), index=7>, <Qubit register=(20, "q"), index=8>, <Qubit register=(20, "q"), index=9>, <Qubit register=(20, "q"), index=10>, <Qubit register=(20, "q"), index=11>, <Qubit register=(20, "q"), index=12>, <Qubit register=(20, "q"), index=13>, <Qubit register=(20, "q"), index=14>, <Qubit register=(20, "q"), index=15>, <Qubit register=(20, "q"), index=16>, <Qubit register=(20, "q"), index=17>, <Qubit register=(20, "q"), index=18>, <Qubit register=(20, "q"), index=19>), clbits=())
Тут у куті обертання немає нічого особливого. Ми просто обрали будь-яку нерівну суперпозицію та , щоб дослідити ефекти асиметричних помилкових переходів і те, як їх обробляє TREX. Для цього стану ідеальне очікуване значення Z на кожному кубіті за відсутності будь-яких помилок (зчитування чи інших) становило б:
Тому ми сподіваємося отримати очікувані значення, близькі до -0.924, на всіх кубітах. Ми побачимо, чи покращує TREX кожне очікуване значення окремо, а також чи покращує він середнє за всіма кубітами.
Перевірте своє розуміння
Перевірте наведене вище очікуване значення прямим обчисленням.
Відповідь
Ми транспілюємо за допомогою менеджера проходів.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend_real)

qc_t = pass_manager.run(qc)
Тепер ми будуємо по одній спостережуваній на кубіт, щоб оцінити всі двадцять очікуваних значень в одному робочому процесі. Тобто для кубіта нам потрібна спостережувана з усіма тотожними , крім позиції, де має стояти . Не забудьте застосувати вашу транспільовану розкладку і до спостережуваних.
# Observables: Z on qubit i for all i.
observables = []
for i in range(num_qubits):
    obs_string = "I" * i + "Z" + "I" * (num_qubits - i - 1)
    obs = SparsePauliOp(obs_string)
    observables.append(obs)
observables_t = [obs.apply_layout(qc_t.layout) for obs in observables]
Тепер можна виконувати. Комірка коду нижче використовує session mode; якщо у вас немає доступу до сесій, замініть його на batch mode, щоб виконати той самий робочий процес, але з можливим очікуванням у черзі між схемами.
# This took 20 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX turned off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_no_trex = job.result()
    val_no_trex = res_no_trex[0].data.evs

print("⟨Z_i⟩ without TREX:", val_no_trex)
⟨Z_i⟩ without TREX: [-0.90645 -0.89755 -0.89125 -0.9165  -0.87655 -0.91035 -0.8757  -0.87905
 -0.66035 -0.8876  -0.87125 -0.89975 -0.83745 -0.89755 -0.82645 -0.90325
 -0.84385 -0.90195 -0.85865 -0.8884 ]
# This took 36 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_trex = job.result()
    val_trex = res_trex[0].data.evs

print("⟨Z_i⟩ with TREX:", val_trex)
⟨Z_i⟩ with TREX: [-0.92086303 -0.90253698 -0.91688854 -0.93308327 -0.91273953 -0.9221892
 -0.903782   -0.93046052 -0.90348934 -0.90284174 -0.89499677 -0.91630959
 -0.89508481 -0.92233292 -0.90497141 -0.91867138 -0.91421506 -0.91646851
 -0.9268364  -0.91669818]
Тут ми порівнюємо середні абсолютні похибки з TREX і без нього.
ideal = np.cos(7 * np.pi / 8)

mean_abs_error_no_trex = np.mean(np.abs(val_no_trex - ideal))
mean_abs_error_trex = np.mean(np.abs(val_trex - ideal))

print("The mean absolute error without TREX is: ", mean_abs_error_no_trex)
print("The mean absolute error with TREX is: ", mean_abs_error_trex)
The mean absolute error without TREX is:  0.05238453251128674
The mean absolute error with TREX is:  0.011980732757900719
zx = list(range(num_qubits))
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(zx, val_no_trex, c="blue", linestyle="-", label="No TREX", alpha=0.7)

## Add values with DD
ax.scatter(zx, val_trex, c="red", linestyle="-", label="With TREX", alpha=0.7)

# Add ideal reference line
ax.axhline(y=-0.924, color="black", linestyle="--", linewidth=2, label="Ideal ⟨Z⟩")

# Add labels and plot
ax.set_xlabel("Qubits")
ax.set_ylabel("<Z>")
ax.legend()
ax.set_title("<Z> in RX(7pi/8)|0> state with and without TREX")
ax.grid(True)

plt.show()
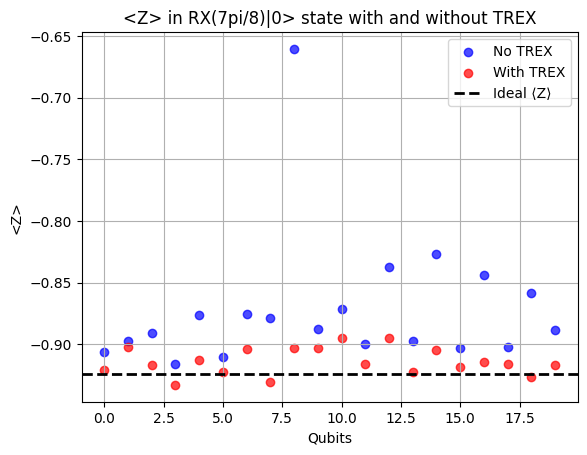
TREX, безумовно, допоміг. Очікуване значення на кожному кубіті покращилося, за єдиним винятком кубіта 16. Такого викиду слід було очікувати. Ми можемо кількісно оцінити загальний ефект застосування TREX до схеми, взявши середні значення.
mean_no_trex = sum(val_no_trex) / num_qubits
mean_trex = sum(val_trex) / num_qubits

print("Mean without TREX", mean_no_trex)
print("Mean with TREX", mean_trex)
Mean without TREX -0.8714950000000001
Mean with TREX -0.9137729590315635
У середньому TREX наблизив наші результати до ідеальних приблизно на 2.9% і залишив нас із результатом, який у середньому відрізняється від теоретично ідеального лише на 0.4%. Це чудово, і саме це покращення з малими накладними витратами є причиною, чому TREX — пом'якшення помилок за замовчуванням в Estimator. Але ми мусимо ще раз наголосити, що TREX усуває зміщення в помилці зчитування, а не виправляє всі наші помилки. Ми обрали початковий стан, який мав добрі шанси зазнати впливу асиметрії зчитування. Ефект був би іншим, якби ми підготували кожен кубіт в іншому стані. Для тривіального аргументу, чому це так, уявіть, що сталося б, якби ми залишили кожен кубіт в основному стані . Не було б можливості спостерегти (або виправити) асиметрію помилки зчитування між станами та .
Екстраполяція до нульового шуму (ZNE)
Екстраполяція до нульового шуму (ZNE) — один із найпоширеніших методів мітигації помилок. Загальну стратегію також легко зрозуміти, хоча деталі її реалізації складні. ZNE працює так:
-
Запуск цільової схеми за кількох «рівнів шуму» — модифікацій схеми, які змушують її шум масштабуватися передбачуваним чином
-
Оцінювання цікавої спостережуваної для кожного масштабу шуму.
-
Екстраполяція назад до нульового шуму за допомогою моделі підгонки (лінійної, поліноміальної, експоненційної тощо).
Результат — це оцінка того, якою була б спостережувана в границі нульового шуму, що випливає з моделі екстраполяції.
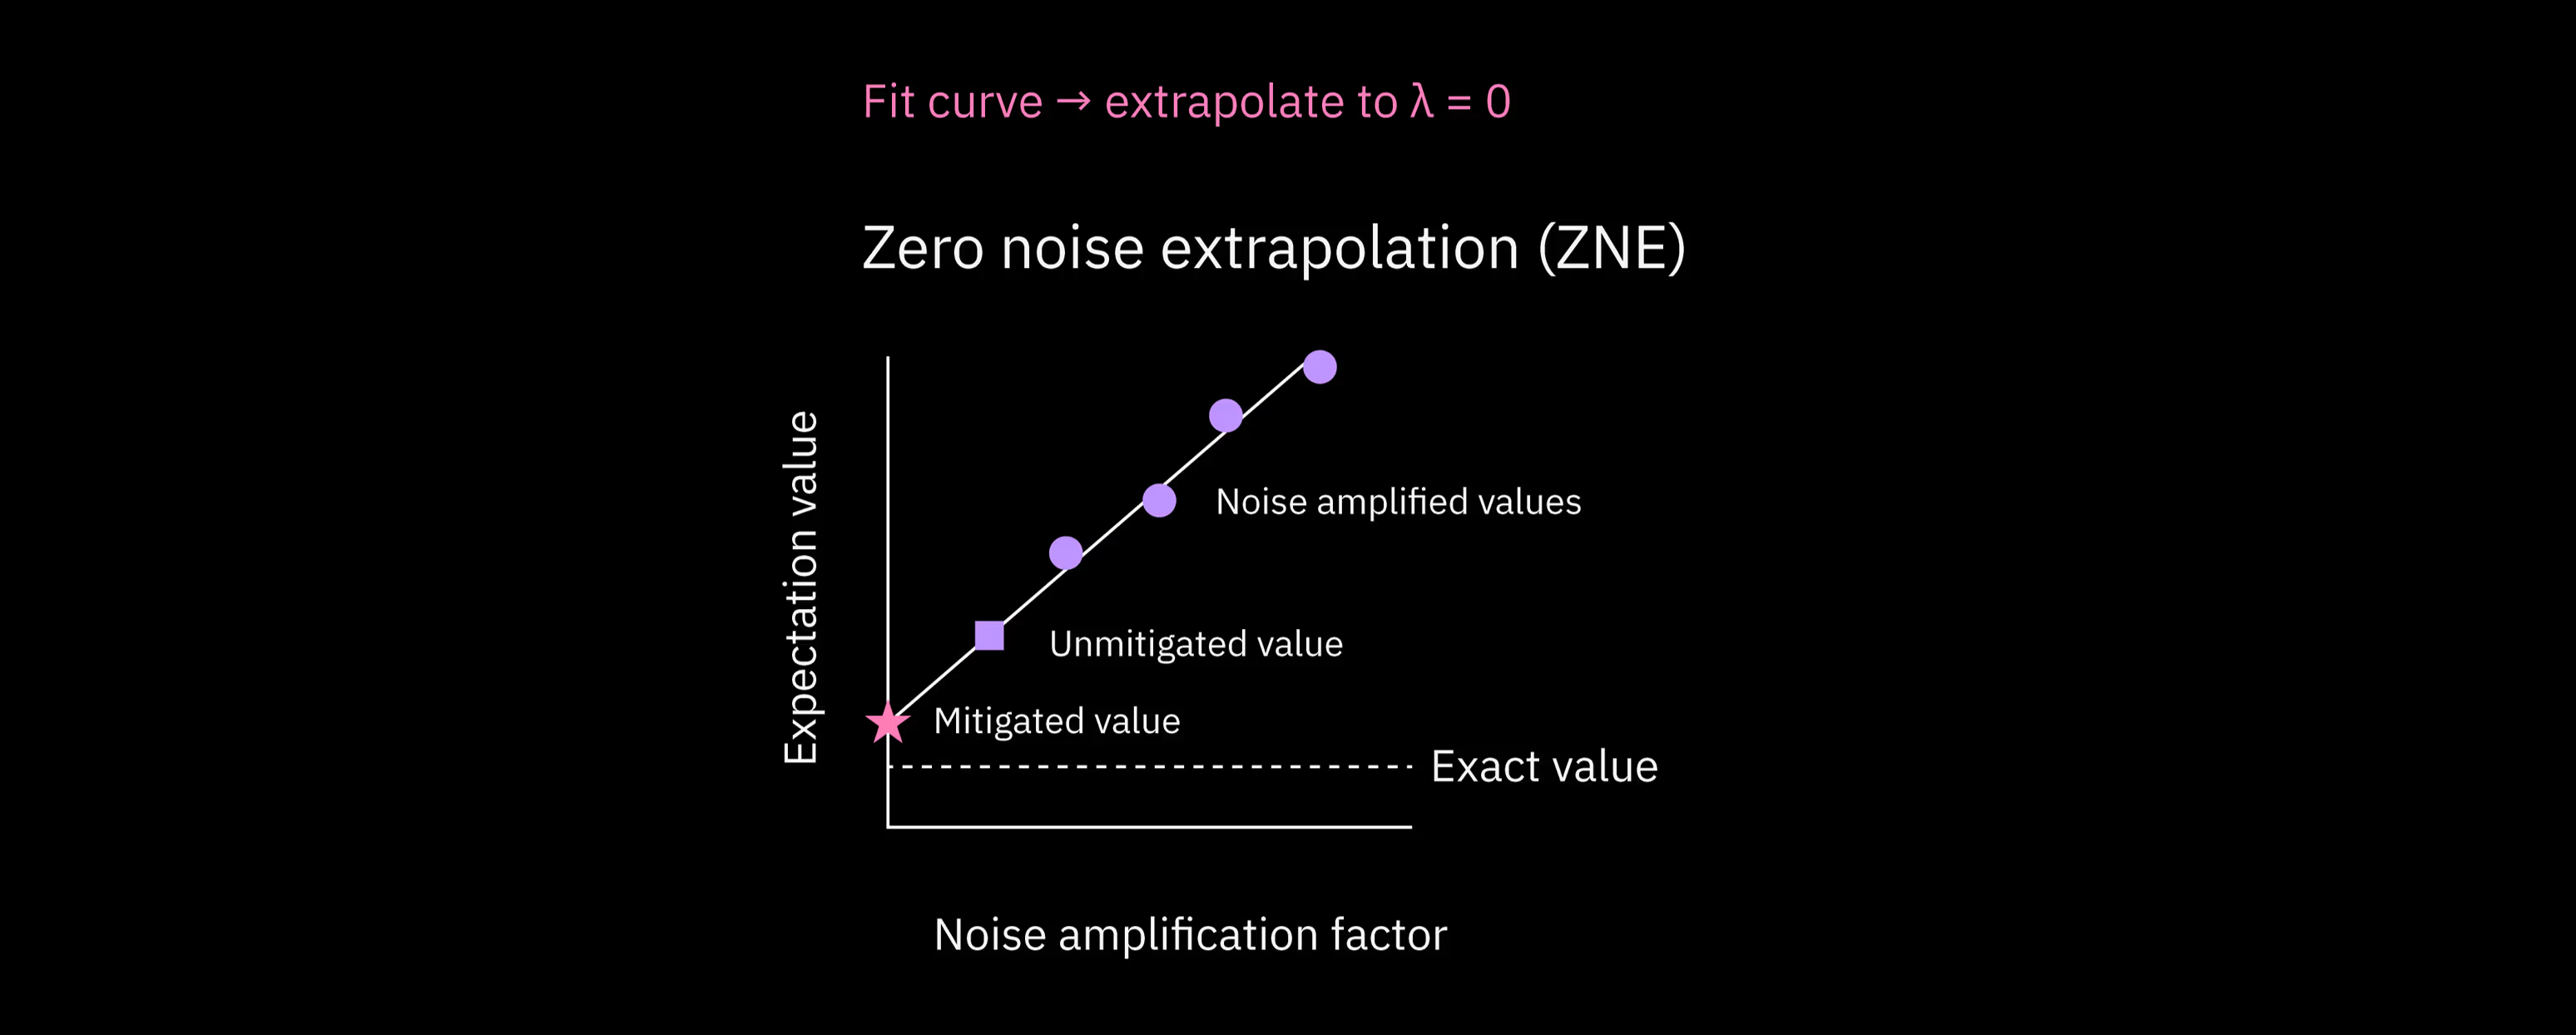
ZNE не гарантує, що шум зростає плавно чи лінійно, коли ми модифікуємо схеми. Натомість він припускає, що масштабування шуму достатньо добре поводиться, щоб уможливити екстраполяцію. Складність ZNE полягає в тому, як модифікувати схеми, щоб якомога краще задовольнити це припущення. Ми розглянемо деякі підходи в цьому уроці.
Масштабування ресурсів у ZNE
У ZNE накладні витрати здебільшого квантові. Тобто, щоб отримати очікувані значення на рівнях шуму, потрібно виконати експеримент на схемах, кожна з багатьма шотами. Щоб зберегти фіксовану статистичну точність, загальна кількість вибірок, як правило, збільшується в міру введення додаткових схем зі масштабованим шумом.
Кількість рівнів шуму , які ви досліджуєте, залежатиме від методу, що використовується для масштабування шуму. Для однієї простої техніки масштабування шуму (яку називають «gate-folding», розглянуто нижче) зазвичай становить від 3 до 5. Інший метод (імовірнісне підсилення шуму (PNA)) дозволяє нецілі коефіцієнти шуму і, як правило, дає нижчі рівні шуму, ніж gate-folding. Загальні накладні витрати масштабуються приблизно так:
де — базова кількість шотів. Ще слід пам'ятати, що якщо масштабування шуму передбачає повторення гейтів, глибина схеми може збільшитися в кількість разів, пропорційну значенню масштабування шуму. Масштабування шуму разом зі збільшенням глибини — це і є мета, але пам'ятайте про загальну глибину.
ZNE добре підходить для задач, до яких застосовні такі пункти:
-
Вам потрібен універсальний метод мітигації, ефективний для багатьох типів помилок.
-
Глибина схеми не надто велика; ZNE не спрацьовує, коли масштабована схема стає надто шумною для екстраполяції.
-
Ви можете допустити помірні накладні витрати часу виконання заради кращої точності.
На практиці це робить ZNE ідеальним для багатьох варіаційних схем, оцінювання очікуваних значень та інших квантових алгоритмів найближчого майбутнього. Він реалізований в Estimator за допомогою resilience_level = 2. Зауважте, що ZNE екстраполює в просторі, який має єдиний результат як функцію шуму в усій схемі. Це означає, що він придатний для задач оцінювання, але не для задач вибірки. Він не призначений для роботи з розподілами бітових рядків.
Коефіцієнти шуму
Як саме можна збільшити рівень шуму в схемі? Є два основні способи, хоча існує багато варіантів.
-
Замініть гейт або блок гейтів на . Оскільки гейти на квантових комп'ютерах унітарні, ми знаємо, що , тож логічно: . Проте кожне повторення або додає подібну або ідентичну помилку, що дозволяє збільшувати рівні шуму/помилок. Зауважте, що показана вище заміна переводить нас від початкового шуму гейта (рівень шуму 1) до втричі вищого рівня шуму в (рівень шуму 3). На практиці ми можемо повторити останні два гейти разів: , щоб отримати рівень шуму . Це називається gate folding, і це дуже поширена техніка масштабування шуму.
-
Існують інші методи збільшення рівня шуму, наприклад імовірнісне підсилення помилок (PEA). У PEA ми спершу навчаємо відповідну модель шуму для схеми, зазвичай виражену як канал Паулі. Потім шум підсилюється вибіркою з перемасштабованої версії цього вивченого каналу шуму. Регулюючи вибірку, можна неперервно масштабувати ефективну силу шуму, зокрема до нецілих значень.
На практиці gate folding може дуже надійно масштабувати помилки, але також може призводити до дуже глибоких схем. Якщо вам потрібні лише три рівні шуму (1, 3 і 5), це означає збільшення глибини схеми в 5 разів і все ще отримання прийнятних результатів. Тому, якщо ваша цільова схема має транспільовану двокубітну глибину 60 або більше, PEA, імовірно, підходить краще, ніж gate-folding.
Гейти можна згортати або локально (тобто повторювати для кожного двокубітного гейта одразу після його появи), або групувати в блок гейтів і повторювати блок (як-от гейти ). Часто локальне згортання краще відповідає припущенням ZNE, але можливі обидва варіанти.
Статистична обробка результатів зі масштабованим шумом у ZNE має багато нюансів. Наприклад, за п'ятикратного рівня шуму ваші результати напевно матимуть більшу дисперсію та будуть менш надійними. Чи слід надавати їм таку саму вагу, як точкам даних із нижчим шумом? Ні. Однак, щоб побачити ZNE в дії, ми знехтуємо частиною цієї складності в експерименті з іграшковою моделлю, у якому побудуємо згорнуті схеми вручну та виконаємо наївну екстраполяцію з рівними вагами, щоб проілюструвати ключові кроки. Але далі ми виконаємо експеримент із вбудованою у Qiskit функціональністю ZNE і побачимо, що вона значно краще справляється зі складністю, яку ми пропускаємо.
ZNE вручну
Ми починаємо з вибору квантової схеми та спостережуваної, для яких можна обчислити ідеальне очікуване значення за відсутності шуму та помилок. Ми обираємо стан GHZ з парною кількістю кубітів. Наша спостережувана — . Ми обираємо її з кількох причин:
- Очікуване значення тривіально обчислити в ідеальному випадку. Оскільки кількість кубітів парна, ми або отримуємо
1від кожного , перемножених разом, або отримуємо-1від кожного , перемножених парну кількість разів. - Вона буде досить чутливою до помилок і шуму, оскільки одна помилка на одному кубіті може змінити загальний результат цього шота з +1 на -1.
- Очікуване значення далеке від 0. ZNE може стикатися з труднощами, коли ідеальне очікуване значення дуже близьке до нуля, оскільки високі рівні шуму рандомізують результати, роблячи їх додатними так само часто, як і від'ємними. У підсумку високі значення шуму даватимуть значення, близькі до ідеального; це може зробити екстраполяцію дуже складною.
З огляду на цю мотивацію, побудуймо наші схеми.
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
num_qubits = 10  # must be even

# # Noise amplification factors used for folding (2* integer +1 for gate folding)
noise_steps = [1, 3, 5]
ghz_amp = []

for j in noise_steps:
    qc = QuantumCircuit(num_qubits)
    qc.h(0)
    # Since CX^2 = I, odd repetitions implement folded versions of the gate.
    for i in range(num_qubits - 1):
        for gates in range(j):
            qc.cx(i, i + 1)
    qc.barrier()
    ghz_amp.append(qc)
Зверніть увагу на тонкість: тут . Хоча gate folding подавався як такий, що складається з операторів вигляду , тут та сама структура виглядає як CNOT CNOT CNOT.
Переконаймося, що наша схема справді є звичайною схемою GHZ:
ghz_amp[0].draw("mpl")
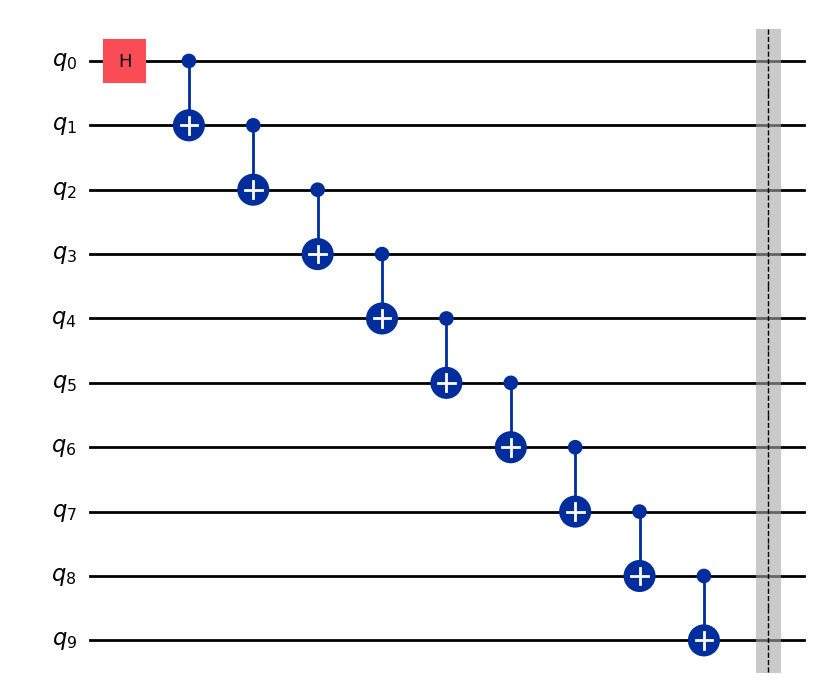
Ви можете переглянути інші схеми, щоб переконатися, що вони мають очікувану структуру.
Тепер будуємо наші спостережувані.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
observables = []
for j in range(len(noise_steps)):
    observables.append(observable)
Ми будуємо менеджер проходів і застосовуємо його до наших схем. Потім беремо розкладки та застосовуємо їх до наших спостережуваних.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=0,
)

qcs_transpiled = []
obs_transpiled = []

for j in range(len(ghz_amp)):
    # Transpile the circuit
    qc_pm = pm.run(ghz_amp[j])
    qcs_transpiled.append(qc_pm)
    # Extract the final layout
    layout = qc_pm.layout
    # Apply the layout to the observable
    obs_transpiled.append(observable.apply_layout(layout))
Відформатуйте pubs.
pubs = [(qc, obs) for qc, obs in zip(qcs_transpiled, obs_transpiled)]
Тепер запускаємо Estimator. Ми хотіли б зосередитися на ролі ZNE, тож можна було б встановити resilience_level = 0, щоб не змішувати ефекти твірлінгу з ефектом ZNE. Проте ми також хочемо порівняти наш ZNE «вручну» з налаштуваннями ZNE, вбудованими в Qiskit, які включають твірлінг. Тому тут ми встановлюємо resilience_level = 1. Встановлення resilience_level = 2 викликає налаштування ZNE в Qiskit, які ми незабаром використаємо.
# This took 21 sec on ibm_fez. Your actual runtime might vary.
options = EstimatorOptions(resilience_level=1)

estimator = Estimator(
    mode=backend_real,
    options=options,
)

job = estimator.run(pubs)

res = job.result()
Тепер виведемо рівні шуму та очікувані значення.
# We save this for later comparisons
value_no_zne = res[0].data.evs

# Print all values used for extrapolation
print("Noise level 1: ", res[0].data.evs)
print("Noise level 3: ", res[1].data.evs)
print("Noise level 5: ", res[2].data.evs)
Noise level 1:  0.8327970939283861
Noise level 3:  0.5612869745718734
Noise level 5:  0.3130254281266217
Це та частина, де ми найбільш безтурботні: ми виконуємо лінійну підгонку цих даних, не звертаючи уваги на дисперсію кожного отриманого значення і не намагаючись теоретично передбачити, чи має підгонка бути лінійною. Знову ж таки, вбудований ZNE працює набагато краще за те, що ми робимо вручну.
# Data
noise_factors = np.array([1, 3, 5])
values = np.array([res[0].data.evs, res[1].data.evs, res[2].data.evs])

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.12994291645044112
Zero-noise extrapolated value: 0.9588652482269501
Побудуємо графік перед інтерпретацією.
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Zero-noise estimate")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
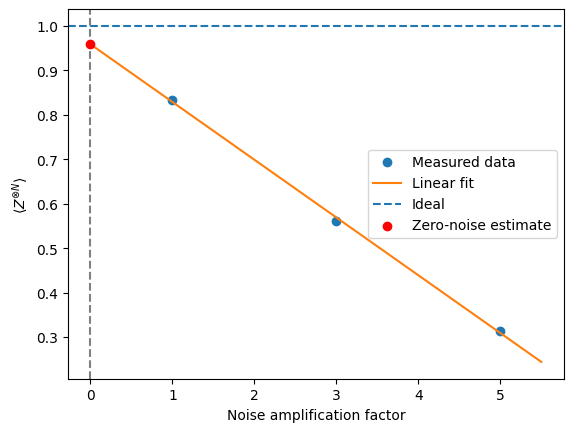
На момент створення цього уроку з екстраполяції до випадку нульового шуму ми отримуємо очікуване значення 0.959. Ваші значення можуть відрізнятися. Це суттєво краще за очікуване значення сирої схеми 0.83, приблизно на 13% ближче до ідеального значення. Але ви також бачите, що ми використовуємо одну точку даних, де очікуване значення впало до 0.31. Очевидно, ця точка даних має гіршу якість. Якби цій точці надали меншу вагу в нашому лінійному наближенні, а пряму підігнали більше до перших двох точок, ми бачимо, що оцінка з екстраполяції до нуля була б вищою (ближчою до ідеального значення). Такі міркування автоматично враховуються у ZNE, вбудованому в Estimator.
ZNE, вбудований в Estimator
Тепер подивімося, що станеться, коли ми використаємо функціональність ZNE, вбудовану в Estimator. Ми починаємо з визначення простої схеми GHZ без жодного gate folding.
num_qubits = 10  # must be even

qc = QuantumCircuit(num_qubits)
qc.h(0)

for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=10, num_clbits=0, params=[]), qubits=(<Qubit register=(10, "q"), index=0>, <Qubit register=(10, "q"), index=1>, <Qubit register=(10, "q"), index=2>, <Qubit register=(10, "q"), index=3>, <Qubit register=(10, "q"), index=4>, <Qubit register=(10, "q"), index=5>, <Qubit register=(10, "q"), index=6>, <Qubit register=(10, "q"), index=7>, <Qubit register=(10, "q"), index=8>, <Qubit register=(10, "q"), index=9>), clbits=())
Ми визначаємо ту саму спостережувану, що й раніше.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
Ми знову визначаємо менеджер проходів, використовуючи optimization_level = 1. До цього вибору ми повернемося нижче.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)
Транспілюйте схему та застосуйте розкладку до спостережуваних.
# Transpile the circuit
qc_transpiled = pm.run(qc)

# Extract the final layout
layout = qc_transpiled.layout

# Apply the layout to the observable
obs_transpiled = observable.apply_layout(layout)
Ми запускаємо Estimator із ZNE та твірлінгом і порівнюємо результати з нашою реалізацією ZNE вручну. Зокрема, ми порівнюємо їх із результатом без ZNE (value_no_zne).
# This used 18 sec on ibm_fez. Your actual QPU time might vary.

options_zne = {
    "resilience_level": 2,
    "resilience": {
        "zne": {
            "noise_factors": [1, 3, 5],
        }
    },
    "twirling": {
        "enable_gates": True,
        "enable_measure": True,
        "num_randomizations": "auto",
    },
}

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
Ми можемо отримати значення для кожного коефіцієнта шуму за допомогою синтаксису job_zne.result()[0].data.evs_noise_factors. Як і раніше, ми могли б наївно використати ці результати для лінійної підгонки та екстраполяції до випадку нульового шуму, але estimator із resilience_level = 2 уже впорався краще, врахувавши дисперсію та інші міркування. Нижче ми показуємо, що дала б лінійна екстраполяція, і що фактично дав вбудований ZNE.
# Data
noise_factors = np.array([1, 3, 5])
values_qiskit_zne = np.array(job_zne.result()[0].data.evs_noise_factors)

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values_qiskit_zne, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.11745451044574956
Zero-noise extrapolated value: 0.9045922788100509
print("Exp val ideal: 1.0")
print("Exp val with no ZNE: ", value_no_zne)
print("Exp val with ZNE: ", value_zne)
print("Fractional improvement: ", (value_zne - value_no_zne) * 100 / 1.0, "%")
Exp val ideal: 1.0
Exp val with no ZNE:  0.8327970939283861
Exp val with ZNE:  0.9877508802932561
Fractional improvement:  15.495378636487 %
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Linear")
plt.scatter(0, value_zne, color="black", zorder=3, label="Proper ZNE")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
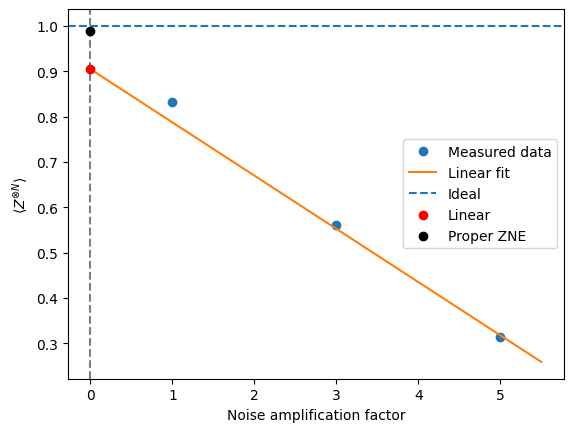
Ми бачимо, що вбудований ZNE покращив нашу оцінку більш ніж на 15% і спрацював помітно краще за нашу спробу вручну.
Перш ніж іти далі, зауважте, що протягом усього цього дослідження ZNE ми встановлювали optimization_level = 1 у менеджері проходів. Вищі рівні оптимізації зменшують помилку, і іноді це зменшення помилки може зробити масштабування помилок менш передбачуваним. Як це часто буває, тут потрібен баланс: зменшувати помилки, крім випадків, коли ви навмисно збільшуєте їх на відомий коефіцієнт.
Поєднання методів
ZNE спирається на таке:
-
Чітко визначений параметр масштабування шуму
-
Достатньо гладке та передбачуване масштабування очікуваних значень із
-
Той самий ефективний канал шуму з різною силою
-
Відсутність внесеного зсуву, що не масштабується з
ZNE добре поєднується з техніками, що усувають зсуви, які не масштабуються (як-от M3), або роблять шум більш регулярним (як-от твірлінг), але конфліктує з техніками, які або намагаються повністю скасувати шум (PEC), або динамічно змінюють його форму (DD).
Зокрема, M3 стосується лише помилок вимірювання/зчитування, які на практиці можна розглядати окремо від помилок гейтів (на яких зосереджені процеси масштабування помилок у ZNE). M3 значною мірою не залежить від gate folding; його можна чисто поєднувати з ZNE. TREX дуже схожий, і його можна поєднувати з ZNE.
Твірлінг Паулі, на відміну від M3 і TREX, таки зосереджений на гейтах. Однак пам'ятайте, що твірлінг Паулі не мітигує помилку/шум безпосередньо; скоріше він змінює його, щоб зробити більш передбачуваним. Твірлінг Паулі насправді може бути корисним для процесу ZNE, роблячи масштабування помилок гейтів більш лінійним і тим самим роблячи екстраполяцію точнішою.
Динамічне розв'язування (DD) є більш тонким. DD динамічно змінює поведінку шуму, частково скасовуючи певні помилки шляхом додавання послідовностей гейтів. Якщо можна побудувати схеми так, щоб DD поводилося однаково, навіть коли гейти або блоки згорнуті, то в принципі можна поєднати ZNE та DD, але на практиці DD іноді заважає масштабуванню. Якщо ви хочете їх поєднати, слід розглянути таке:
- Чи застосовується DD узгоджено на всіх рівнях шуму?
- Чи зберігає згортання структуру DD?
- Чи поводиться отримане масштабування шуму все ще монотонно?
Останній метод мітигації помилок, який ми обговоримо як самостійний підхід, несумісний із ZNE: імовірнісне скасування помилок.
Імовірнісне скасування помилок (PEC)
На відміну від ZNE чи мітигації вимірювань, PEC намагається скасувати шум на рівні гейтів, відтворюючи ідеальний канал у математичному сподіванні. Імовірнісне скасування помилок (PEC) — найпотужніший і найдорожчий метод мітигації помилок, розглянутий у цьому уроці. PEC побудований навколо явного обернення каналу шуму, здійсненого статистично, а не фізично. PEC працює так:
-
Характеризація моделі шуму через базис «помилкових операцій».
-
Вираження оберненого до каналу шуму як квазіймовірнісного розподілу над фізичними операціями.
-
Вибірка з цього розподілу під час виконання схеми для статистичної побудови незміщеної оцінки ідеального обчислення.
Концептуально PEC подібне до віртуальної корекції помилок — воно «скасовує» шум, поєднуючи шумні операції у ретельно зважені випадкові шаблони. Проте процедурно PEC не має тісного зв'язку з корекцією помилок чи кодами виявлення помилок. Незміщена оцінка PEC ідеального безшумного очікуваного значення коштує дуже великих накладних витрат на вибірку та сильної залежності від точної характеризації шуму.
На квантових комп'ютерах IBM PEC найкраще розглядати як прецизійний інструмент, а не універсальний шар мітигації: він найдоречніший для малих схем або невеликих частин більших схем, задач бенчмаркінгу та високоточних досліджень, де прийнятні великі квантові накладні витрати.
Характеризація каналу шуму
У PEC кожен ідеальний гейт у квантовій схемі моделюється як ідеальний унітарний канал, за яким іде процес шуму. Нехай позначає матрицю густини квантового стану. Ідеальний гейт подається унітарною матрицею , яка індукує квантовий канал:
На реальному обладнанні ця ідеальна еволюція спотворюється шумом. Ми моделюємо фізичну реалізацію гейта як ефективний шумний канал:
де — канал шуму, що описує стохастичні помилки, пов'язані з гейтом. Протягом цього обговорення , та — лінійні відображення, що діють на оператори густини. Ідеальний канал унітарний і оборотний, тоді як канал шуму (а отже й ) є цілком додатним відображенням, що зберігає слід (CPTP).
PEC припускає, що канал шуму відомий або відомий приблизно. На обладнанні IBM Quantum ця інформація зазвичай отримується з калібрувальних даних пристрою, рівнів помилок, виведених з експериментів бенчмаркінгу, та спрощених моделей шуму, як-от наближення Паулі або деполяризаційні наближення для малих наборів гейтів. Хоча PEC не потребує ідеально точної моделі шуму, його продуктивність швидко погіршується, коли припущений канал шуму розходиться з реальною поведінкою обладнання.
Квазіймовірнісне розкладання оберненого каналу шуму
Центральна ідея PEC — скасувати вплив шуму в математичному сподіванні, побудувавши стохастичне наближення до оберненого каналу шуму. Формально мета — застосувати лінійне відображення, яке приблизно скасовує , так що:
у сподіванні за багатьма виконаннями схеми.
Обернене тут визначається як алгебраїчне обернене до , що розглядається як лінійний супероператор, який діє на оператори. Це обернене існує лише тоді, коли має повний ранг; необоротні процеси шуму неможливо точно мітигувати за допомогою PEC.
Коли обернення можливе, PEC виражає обернений канал шуму як лінійну комбінацію фізично реалізовних операцій:
Тут кожна — це шумна операція, яку можна виконати на обладнанні (зазвичай рідні гейти або короткі послідовності гейтів), а дійсні коефіцієнти утворюють квазіймовірнісний розподіл. На відміну від звичайних імовірностей, коефіцієнти можуть бути від'ємними або перевищувати 1.
Квазіймовірнісна норма:
кількісно визначає вартість обернення шуму. Для будь-якого нетривіального каналу шуму . На обладнанні IBM Quantum це розкладання зазвичай виконується:
- для кожного гейта або малого набору гейтів,
- за припущення обмежених моделей шуму (часто діагональних за Паулі наближень),
- з використанням рідних операцій конкретного бекенда та обмежень планування.
Відтворення ідеальної схеми методом Монте-Карло
Щоб оцінити очікуване значення спостережуваної , PEC використовує вибірку Монте-Карло на основі наведеного вище розкладання. Для кожного входження шумного гейта в схемі застосовується така процедура:
-
Випадково виберіть операцію з імовірністю:
-
Призначте класичну вагу:
-
Виконайте отриману рандомізовану шумну схему на квантовому бекенді.
-
Помножте виміряний результат на добуток усіх накопичених ваг.
-
Усередніть зважені результати за багатьма виконаннями схеми.
Отриманий оцінювач задовольняє
за умови, що модель шуму точно описує обладнання. Отже, PEC не вносить жодного систематичного зміщення в очікуваному значенні, але замінює зміщення великою статистичною дисперсією. Кожен запуск дає шумну, але зважену оцінку; лише після усереднення багатьох таких запусків виникає ідеальне очікуване значення.
Концептуальна інтерпретація
PEC іноді описують як віртуальну корекцію помилок. Хоча це формулювання не є цілком хибним, його не слід плутати зі справжньою квантовою корекцією помилок. PEC не передбачає логічного кодування, вилучення синдрому чи зворотного зв'язку в реальному часі. Помилки не запобігаються і не виправляються під час виконання схеми.
Натомість PEC скасовує шум статистично, поєднуючи багато шумних реалізацій схеми зі знаковими класичними вагами так, що помилки скасовуються лише після класичної постобробки. Інформація не захищається під час виконання; ідеальні результати відтворюються постфактум.
Масштабування ресурсів і вартість
Основна вартість PEC походить від підсилення дисперсії. Дисперсія оцінювача PEC масштабується як:
що означає:
Це масштабування є фундаментальним і не може бути покращене класичною постобробкою.
Для схем із багатьма шумними гейтами кожен гейт вносить множник , через що загальна квазіймовірнісна норма зростає приблизно мультиплікативно:
де — глибина схеми. На обладнанні IBM Quantum це зазвичай призводить до експоненційного зростання вартості вибірки з глибиною схеми, з особливо сильною чутливістю до помилок двокубітних гейтів. Це масштабування встановлює практичні межі застосовності PEC.
PEC наразі практичне лише тоді, коли виконується одна або всі з таких умов:
-
Схеми дуже малі або неглибокі (часто гейтів),
-
Моделі шуму прості та добре перевірені (наприклад, шум Паулі),
-
Висока статистична вартість прийнятна,
-
Метою є точність, а не пропускна здатність.
З цієї причини PEC часто застосовують до:
-
Ізольованих підсхем у складніших робочих процесах,
-
Кроків еволюції на короткий час,
-
Процедур підготовки стану або вимірювання,
-
Експериментів бенчмаркінгу та валідації.
Програмний стек IBM (IBM Quantum Compute та інструменти мітигації помилок) відображає це, розглядаючи PEC як спеціалізований варіант, а не шар мітигації за замовчуванням.
Типові випадки використання PEC включають:
-
Точне бенчмаркінгове тестування квантового обладнання,
-
Перевірка невеликих квантових алгоритмів,
-
Високоточна квантова хімія для зменшених систем,
-
Перехресна перевірка ZNE або інших методів пом'якшення.
Зв'язок PEC з іншими методами пом'якшення
Багато інших технік пом'якшення жертвують точністю заради масштабованості; PEC робить прямо протилежне, роблячи ставку передусім на точність.
Оскільки PEC може застосовуватися лише до підсхеми, тут особливо важливо запитати, які ще методи пом'якшення можна з ним поєднувати. Щоб чітко міркувати про сумісність із PEC, корисно класифікувати техніки за тим, що вони роблять із шумом. Розглянь такі загальні категорії:
-
Скасування шуму: спроба інвертувати канали помилок
-
Масштабування шуму: навмисне збільшення шуму для екстраполяції
-
Переформування шуму: зміна структури або спектра шуму
-
Усунення зсуву: виправлення помилок, які не масштабуються разом із шумом вентилів
PEC міцно стоїть у категорії (1). Будь-який метод, що змінює або перемасштабовує канал шуму, потрібно ретельно досліджувати.
Зведена таблиця (загальний огляд)
| Техніка | Сумісна з PEC | Примітки |
|---|---|---|
| ZNE | Ні | Скасування проти масштабування, а подекуди й підлаштовування помилки |
| Pauli twirling | Так (обережно) | Впливає на поведінку помилок, але може полегшити їх вивчення |
| TREX | Так | Робочі процеси не перетинаються. Повністю сумісні. |
| Динамічне розв'язування | Зазвичай ні | Змінює канал помилок |
PEC і ZNE усувають ті самі джерела помилок (помилки вентилів), але за взаємно несумісними припущеннями чи робочими потоками, або й тими, й іншими. Наприклад, у ZNE ми припускаємо, що помилку можна розкласти за параметром :
і що помилку можна ефективно масштабувати, щоб змоделювати це розкладання. PEC скасував би саме ту помилку, на яку ми спираємося для масштабування. Параметр став би безглуздим. Інакше кажучи:
-
Застосування ZNE перед PEC змінює канал шуму, який ти намагаєшся інвертувати.
-
Застосування PEC перед ZNE усуває саме той шум, на який ZNE спирається для екстраполяції.
PEC і ZNE слід розглядати як альтернативні парадигми пом'якшення помилок, а не як шари, що компонуються. Порівнювати їх пліч-о-пліч повчально, а поєднувати їх не варто.
PEC і Pauli twirling загалом сумісні й часто корисні разом. Twirling може допомогти PEC, оскільки перетворює когерентні помилки на стохастичні помилки Паулі. Це спрощує канал шуму, полегшуючи його представлення та інвертування. Для PEC це надзвичайно цінно з таких причин:
-
Квазіймовірнісні розклади набагато простіші для каналів Паулі
-
Квазіймовірнісна норма часто значно менша
-
Дисперсія вибірки зменшується
Багато демонстрацій PEC припускають або вбудовують шум після Pauli twirling. Важливо уточнити, що Pauli twirling сам по собі не пом'якшує помилки; він переформовує шум до вигляду, з яким імовірнісне скасування помилок працює ефективніше.
PEC можна і слід поєднувати з TREX. Ці підходи повністю сумісні та відіграють ортогональні ролі. TREX працює лише на етапі вимірювання, усуває зміщення зчитування за допомогою рандомізованих twirl-ів каналу вимірювання і не впливає ні на шум вентилів, ні на динаміку схеми. PEC працює із шумом вентилів. Оскільки помилка вимірювання є адитивною, а не композиційною, вона не залежить від послідовностей вентилів. Застосовувати TREX разом із PEC безпечно, і часто це бажано.
Порядок цих методів такий, як і можна очікувати:
- Виконати схему з рандомізацією PEC
- Застосувати TREX для пом'якшення помилки зчитування
- Застосувати зважування й усереднення PEC
PEC і DD загалом несумісні, хіба що характеризація шуму для PEC виконується з активним DD. PEC припускає, що є стаціонарним, відтворюваним і точно характеризовним. DD явно переформовує канал шуму в часі, модулюючи взаємодії системи з оточенням і вносячи нетривіальні ефекти часування імпульсів. Через це ефективний шум із DD — це не той самий канал, що без DD. Усе ще ускладнюється тим, що канал шуму може сильно залежати від планування схеми. Кінцевий результат: інверсія шуму стає невизначеною або недійсною.
Теоретично можна охарактеризувати шум із активним DD і відповідно побудувати модель PEC, але це дуже складно й наразі не є рекомендованим робочим процесом.
Застосування PEC вручну
PEC складний, і реалізовувати його вручну не рекомендується. Проте ми хочемо пройти через математику базового застосування на одному кубіті, щоб зрозуміти, які кроки включає цей процес. Ми обираємо змішаний, але нетривіальний стан, щоб чітко бачити числові ефекти.
Візьмемо кубіт, який має бути в чистому стані
Ідеальна матриця густини:
Ми обрали цю матрицю густини, бо вона не діагональна і стосується лише одного кубіта, тож її легко розглянути «вручну».
Тепер застосуємо дуже просту, але реалістичну модель шуму: однокубітний деполяризаційний канал із малою силою .
Щоб арифметика була зручною, візьмемо . Цей канал цілком додатний зі збереженням сліду (CPTP), як і має бути. Це реалістичний канал шуму для реального обладнання, або принаймні реалістичний для опису частини шуму. Крім того, цей канал шуму аналітично оборотний як лінійне відображення. Іншими словами, існує обернена матриця, але це не означає, що вона відповідає фізичному CPTP-каналу, і вона точно не відповідає унітарному оператору, який можна реалізувати на обладнанні.
Тепер застосуємо наш деполяризаційний канал шуму до однокубітної матриці густини й отримаємо:
Для : та .
So:
Застосовуючи це до нашого стану:
Обчислимо явно:
Це все ще фізична матриця густини, і слід її, як і раніше, дорівнює одиниці — але тепер вона більш змішана.
Тепер обчислимо ідеальний обернений канал, будучи цілком готовими до того, що він може бути нефізичним. Ми перевіримо, чи це так. Математично обернене лінійне відображення має вигляд:
Якби ця обернена дія сама була допустимим фізичним каналом, у нас виникла б спокуса реалізувати її точно. Звісно, нам усе одно довелося б з'ясувати, як реалізувати її за допомогою унітарних операцій і класичних кроків, але саме це було б метою. Проте виявляється, що вона не є CPTP, і загалом немає гарантії, що такі обернені відображення будуть CPTP. Це критично для нашого обговорення, адже саме з цієї причини існує PEC.
Можливо, ти й так бачиш, що вона не є CPTP, просто дивлячись на неї. Надійна перевірка — застосувати її до матриці густини й подивитися, чи вона повертає фізичні результати. Це залишено як вправу для перевірки твого розуміння.
Перевір своє розуміння
Перевір, чи є обернене відображення зверху CPTP, застосувавши його до нової матриці густини:
Інтерпретуй результати як фізичні або нефізичні.
Відповідь
Як фізична матриця густини, вона відповідає класичній імовірності, більшій за 1, того, що система перебуває в стані , і від'ємній імовірності перебування в стані . Очевидно, це відображення може давати безглузді матриці густини. Крім того, з огляду видно, що власні значення отриманої матриці густини дорівнюють 1.0625 та -0.0625, тобто не всі власні значення додатні. Отже, відображення не є «цілком додатним», тобто не має властивості «CP» з абревіатури CPTP.
Перевір своє розуміння
Перевір явним обчисленням, що обернена операція зверху скасовує канал шуму та повертає стан без шуму.
Відповідь
Застосуй її до зашумленого стану:
Це в точності початковий стан (з точністю до округлення).
Наголосимо ще раз для повної ясності: ми не можемо точно інвертувати канал шуму; обернене відображення не є CPTP і не є допустимим фізичним каналом. Однак ми можемо ефективно інвертувати канал як лінійну комбінацію фізичних каналів.
Для деполяризаційного каналу:
де: тощо.
Обернене відображення можна записати так:
with:
-
= фізично реалізовні канали Кліффорда
-
= квазіймовірності
-
Some
Це основна ідея PEC:
-
Вибирати канали відповідно до ∣
-
Приписувати знаки результатам вимірювань
-
Очікувані значення збігаються до значення без шуму
Ми застосовуємо PEC «вручну» до оцінювання , використовуючи матрицю густини , і дивимося, чи вдасться відновити результати для . Для ми очікуємо:
Зауваж також, що для зашумленої матриці густини ми отримуємо:
Це правильний порядок величини, але значно далеко від ідеального випадку.
Тепер розглянемо крок за кроком, як за допомогою процесу PEC можна відновити незміщене очікуване значення із зашумленої матриці густини. У реальних робочих процесах це імовірнісний процес, і він буде автоматизований. У цьому «ручному» процесі ми оберемо імовірнісні значення, які реалістичні, але, можливо, зручні для нашого викладу. Це не слід розуміти як твердження, що PEC ідеальний. Це лише спосіб показати тобі правдоподібний сценарій, який міг би відбутися всередині пакетів PEC.
Нагадаємо, що наш канал шуму має вигляд:
Обернене відображення можна записати (точно):
based on symmetry of the transformation and the completeness of the Pauli operators. Inverting the noise channel somehow in the estimation process should yield an estimator that is unbiased and normalized. To do this, we must at least determine the coefficents and and then think about how to implement the inverse transformation. When done by a noise learner, the inversion of this noise channel would be done at the channel level, independent of a specific case like our density matrix. The coefficients and would come from this inversion.
Для цього вступу простіше зосередитися на впливі каналу на нашу матрицю густини. Це дозволяє працювати зі знайомими об'єктами, як-от матриці густини та очікувані значення. З цією метою розглянь, що має бути істинним щодо дії цієї оберненої операції на наш процес оцінювання: оцінювач, отриманий за допомогою PEC, має бути нормованим і незміщеним. Це відповідає двом умовам:
-
Нормування: щоб ця операція не змінювала масштаб спостережуваної, ми вимагаємо . Щоб зрозуміти, чому це так, можна розглянути або дію оберненого відображення на матрицю густини, або його дію на очікуване значення чогось тривіального, як-от самого .
-
Калібрування: у реальному робочому процесі ми використовуємо калібрувальні схеми, щоб вивчити поведінку шуму на рівні вентилів. Потім ми використовуємо знання про поведінку шуму на рівні вентилів і лінійність очікуваних значень, щоб застосувати вивчену модель шуму до більшої схеми. У нашому випадку ми почали зі штучного знання, що ідеальне очікуване значення . Але було б дуже легко придумати стан, для якого ми теоретично знаємо, що це ідеальне значення, а потім використати справжні вимірювання для калібрування. Ключовий момент: для PEC зазвичай не вивчають повну модель шуму всієї схеми. Натомість вивчають локальні моделі шуму для окремих вентилів або шарів схеми й використовують їх для побудови квазіймовірнісного розкладу.
Ми використовуємо ці умови, щоб визначити та . Розглянемо анзац
and apply it to an arbitrary single-qubit density matrix .
Нагадаємо, що канали Паулі діють спряженням:
Застосування до дає:
Беручи слід, отримуємо:
Кожен оператор Паулі є унітарним, тож спряження зберігає слід:
Therefore,
Щоб оцінювач PEC був нормованим, ефективне обернене відображення має зберігати слід усіх матриць густини. Тобто ми вимагаємо:
Звідси випливає обмеження нормування:
Але в нашому випадку це дає умову:
Тепер ми використовуємо калібрувальну інформацію, щоб пов'язати спостережуване очікуване значення з відомим ідеальним.
Or equivalently,
Розв'язуючи наші дві умови відносно та , отримуємо:
Ці коефіцієнти в сумі дають 1, але один із них від'ємний.
Ми можемо відновити ідеальне очікуване значення, випадково змінюючи схему, вимірюючи, множачи результат на знакову вагу й усереднюючи. Зокрема, жодні матриці густини не відновлюються, і жоден обернений канал не реалізується фізично.
Ключовий крок: це і є PEC
Для нашої сили шуму обернений канал можна записати як:
Важливі факти:
-
Коефіцієнти в сумі дають 1
-
Один коефіцієнт від'ємний
-
Кожен доданок фізично реалізовний
-
Від'ємність переходить у класичну постобробку
Ми формуємо розподіл вибірки з абсолютних значень ваг:
(для кожного з X, Y, Z)
Загальна вага:
Щоб отримати імовірності вибору, поділи на W.
| Операція | Імовірність | Знак |
|---|---|---|
| Нічого не робити () | 1.1875 / 1.375 ≈ 0.864 | + |
| Застосувати X | 0.0625 / 1.375 ≈ 0.045 | - |
| Застосувати Y | 0.0625 / 1.375 ≈ 0.045 | - |
| Застосувати Z | 0.0625 / 1.375 ≈ 0.045 | - |
Знак походить від початкового коефіцієнта, а не від імовірності.
Кожен шот складається з таких кроків:
-
Підготувати стан
-
Дозволити обладнанню застосувати зашумлену схему
-
Випадково вибрати операцію з наведеної вище таблиці, використовуючи відповідні імовірності
-
Apply it
-
Виміряти , отримавши
-
Помножити результат на
-
Записати це число
Тепер розглянемо приклади кількох шотів.
Шот 1 (випадок тотожності)
Припустімо, що випадково обрана операція — тотожність (або, що те саме, нічого не робити). Згідно з наведеними міркуваннями та таблицею, це трапляється в 86.4% випадків. Оскільки коефіцієнт при в оберненому до каналу шуму додатний, ми обираємо знак . Наше вимірювання Z цілком може дати будь-яке з . Припустімо, що воно дає .
Внесок цього шота, скоригований PEC, буде таким:
Шот 2 (знову тотожність)
Припустімо, що ми знову отримали як випадкову операцію (тож знак доданка спочатку, як і раніше, ), але цього разу наше вимірювання Z дає . Цього разу внесок такий:
Шот 3 (обрано X)
Цього разу наша випадкова операція — X. Цей доданок в оберненому відображенні від'ємний, тож ми зберігаємо знак . Ми застосовуємо X, а потім вимірюємо Z. Знову ж таки, ми можемо отримати будь-яке власне значення; скажімо, отримуємо . Внесок цього доданка такий:
Шот 4 (обрано Z)
Випадкова операція — Z. Згідно з таблицею, це дає нам знак . Припустімо, що ми вимірюємо Z і отримуємо . Внесок такий:
Шот 5 (обрано Y)
Випадкова операція — Y. Згідно з таблицею, це дає нам знак . Припустімо, що ми вимірюємо Z і отримуємо . Внесок такий:
Усереднення результатів
Уяви, що ми збираємо багато таких результатів, зважених за PEC:
За побудовою, ми застосовуємо тотожність у 86.4% випадків. Кожен з інших вентилів ми застосовуємо у 4.5% випадків. У реальному робочому процесі ми не знаємо точних базових станів і не знаємо всього каналу шуму. Але ми знаємо ваговий множник зверху та відносну імовірність, з якою застосовуємо кожну операцію. У реальному робочому процесі ми покладаємося на невідому матрицю густини, яка дає нам результати вимірювань. Тут ми перевіримо, що ця процедура дала б правильні результати.
Ми хочемо обчислити середнє всіх зважених вимірювань зі знаками, включно із застосуваннями операторів Паулі перед вимірюванням. Позначимо загальну кількість усіх шотів як . Позначимо множину всіх шотів, для яких було застосовано оператор Паулі , як і використаємо для індексації цих шотів. Позначимо результат вимірювання -го шота при застосуванні -го оператора Паулі як . Це середнє можна записати так:
Оператор Паулі застосовується імовірнісно з імовірністю . У границі великої кількості шотів,
Ми можемо використати це, щоб записати:
де — очікуване значення Z лише за ансамблем шотів, у яких було застосовано . Це корисно, бо ми знаємо, чому має дорівнювати кожне таке очікуване значення, з матриці густини. Знову ж таки, у реальному робочому процесі це випливало б із вимірювання, а не з відомої матриці густини.
Перевір своє розуміння
Перевір наведені вище очікувані значення обчисленням або логічними міркуваннями.
Відповідь
Y і Z обробляються точно так само, як вище.
Тепер ми можемо переписати наше загальне очікуване значення так:
Якщо ми знаємо параметри і для шуму нашого вентиля (або більше параметрів для складніших шумових каналів), цього достатньо, щоб визначити (1) загальний ваговий множник і (2) ймовірності, з якими слід застосовувати оператори Паулі. Наведений вище результат показує, що якщо ми так робимо, то пом'якшуємо шум і відновлюємо незміщені очікувані значення. Середнє за всіма цими шотами збіглося до , хоча:
-
Окремі шоти дають внески, більші за ±1
-
Деякі шоти мають від'ємну статистичну вагу
-
Кожна квантова операція була фізичною
Огляд робочого процесу PEC
У PEC усі кроки на квантовому комп'ютері такі:
-
Навчання шуму
-
Підготовка стану для вашого цільового circuit
-
Імовірнісне застосування гейтів Паулі, як описано вище
-
Measurement
Ефективна обернена карта шуму реалізується статистично під час класичної постобробки. Це дозволяє виконувати загальніше обернення шумових каналів, яке інакше вимагало б нефізичних кроків, як-от від'ємні ймовірності.
Ціна, яку ми за це платимо, — це дисперсія. Кожен шот раніше мав «величину», що дорівнювала величинам можливих результатів вимірювання . Після масштабування ваговим множником він має величину (1.375 у нашому прикладі вище).
Це і є джерело накладних витрат вибірки в PEC.
Вбудований PEC
Тепер ми використаємо PEC, вбудований у примітиви IBM Quantum. Тут важливо розрізняти повний PEC на рівні гейтів і локальну модель навчання шуму для масштабованішого PEC, який використовують примітиви IBM Quantum. Накладні витрати повного PEC обмежили б його застосування малими circuit. Це нормально, але корисніше мати інструмент, що масштабується до розміру, за якого квантові обчислення стають цінними для реальних задач. Тому примітиви IBM Quantum використовують пошаровий PEC із навченою моделлю шуму Паулі-Ліндбладa та суворими запобіжниками масштабованості. У цій реалізації PEC шум вивчається для кожного повторюваного шару circuit, а не для кожного екземпляра гейта, і модель шуму є паулі-твіртованою, локальною та марковською. Гейти Кліффорда поглинаються моделлю шуму, тоді як некліффордові гейти домінують у вартості пом'якшення. Накладні витрати вибірки обмежені, щоб уникнути експоненціального зростання.
Ми застосуємо PEC, вбудований у примітиви IBM Quantum, у двох масштабах: малому (шість кубітів) і середньому (30 кубітів), щоб побачити, як у цій версії PEC вартість залишається керованою. У межах кожного розміру ми також явно порівняємо результати PEC із результатами без пом'якшення, із ZNE та з ідеальним значенням.
Починаємо з імпорту кількох необхідних пакетів.
import numpy as np

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp, Statevector

# from qiskit_aer import AerSimulator
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    # QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
Ми обираємо observable для оцінювання. Observable нижче — це гамільтоніан ланцюжка ізингоподібних спінів із взаємодією лише між найближчими сусідами за компонентою та одно-кубітовим членом за , ніби внаслідок зовнішнього поля за .
Особливої причини обирати саме цей гамільтоніан немає. Нам просто потрібна нетривіальна комбінація observable і circuit, щоб пом'якшення помилок мало над чим працювати. Ми явно масштабуємо гамільтоніан (за допомогою коефіцієнтів), ділячи на кількість кубітів, щоб енергія залишалася того самого порядку величини, коли ми збільшуємо кількість кубітів. Починаємо лише з шести.
# This cell builds the observable

num_qubits = 6

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)
Як і у виборі гамільтоніана, circuit для підготовки стану нижче обрано не з фізичних міркувань. Його обрано так, щоб він мав достатню двокубітову глибину та достатньо некліффордових гейтів, щоб PEC був корисним. Немає підстав вважати, що цей circuit є хорошим наближенням, наприклад, основного стану цього ланцюжка спінів.
qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.5, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)
qc.rz(3.141592653589793 / 8, 2)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")
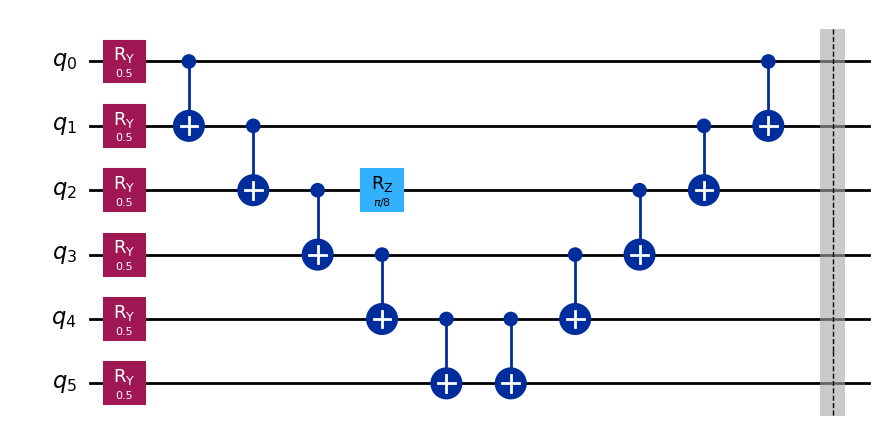
Ми транспілюємо наш circuit і застосовуємо отриманий layout до наших observable.
# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)
Ми отримуємо ідеальне очікуване значення за допомогою симулятора Statevector.
# Compute the ideal final state
state = Statevector.from_instruction(qc)

# Compute expectation value
ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.6651408876730361
Ми очікуємо, що інші ідеальні значення будуть подібними за розміром. Тепер запускаємо це на реальному квантовому комп'ютері IBM без пом'якшення помилок.
# This took 3 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.569677734375
Тепер застосовуємо ZNE до тієї самої задачі.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.6573718927156127
Нарешті застосовуємо PEC.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

from qiskit_ibm_runtime.options import EstimatorOptions

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

result = job_pec.result()
value_pec = result[0].data.evs

print("PEC:", value_pec)
PEC: 0.6666196849843695
Нижче ми будуємо графік результатів і порівнюємо їх.
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
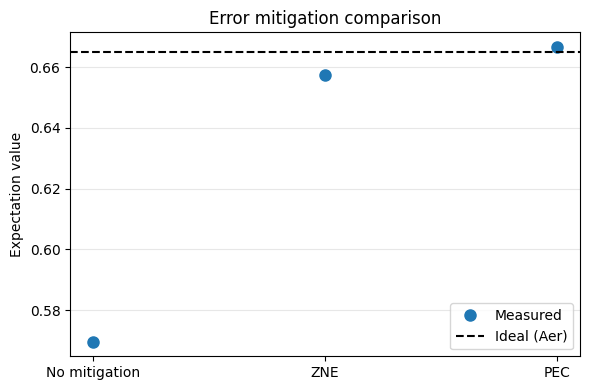
Це спрацювало дуже добре. Наша оцінка за допомогою PEC відхиляється від ідеального значення лише на 0.2%.
Але пам'ятайте, як квантові накладні витрати зростають експоненціально. Ми встановили максимум накладних витрат max_overhead = 100. Судячи з часу та якості результатів, схоже, що ми цього максимуму не досягли. Однак якщо ми збільшимо масштаб обчислення й залишимо цей максимум, ми його досягнемо, і наші результати погіршаться.
Ми можемо побачити, що станеться, коли масштабуємо нашу схему до 30 кубітів. Цікаво, що на багатьох ноутбуках симулятор Statevector починає не вкладатися в час приблизно на 24–28 кубітах. Ми могли б знайти обчислювальні обхідні шляхи. Але натомість прийміймо той факт, що квантові комп'ютери зможуть розв'язувати деякі задачі в масштабі, за якого класичні комп'ютери не встигають. У цьому й суть. Що ж тоді можна зробити, щоб перевірити результати квантових обчислень у таких випадках? Є кілька потенційних відповідей:
- Деякі задачі важко розв'язати, але легко перевірити (як-от розкладання на прості множники в алгоритмі Шора).
- Деякі задачі мають режими параметрів або різновиди, що спрощуються й можуть бути розв'язані класично чи навіть аналітично, щоб порівняти кілька точок. У цьому випадку ми обрали гамільтоніан, який є інтенсивним (ми поділили на кількість кубітів). Ідеальне очікуване значення має бути досить стабільним. Подивімося, як ідеальне очікуване значення змінюється з кількістю кубітів, і спробуймо зробити класичні прогнози щодо значення на 30 кубітах.
import numpy as np
import matplotlib.pyplot as plt

from qiskit import QuantumCircuit
from qiskit.quantum_info import Statevector, SparsePauliOp

num_qubits_max = 24

qubits = [4, 8, 12, 16, 20, 24]
exp_vals = []
for num_qubits in qubits:
    qc = QuantumCircuit(num_qubits)

    for i in range(num_qubits):
        qc.ry(0.7, i)
    for i in range(num_qubits - 1):
        qc.cx(i, i + 1)
    for i in range(num_qubits):
        qc.rz(np.pi / 5, i)
    for i in reversed(range(num_qubits - 1)):
        qc.cx(i, i + 1)
    qc.barrier()

    terms = []
    coeffs = []

    # XX interactions
    for i in range(num_qubits - 1):
        pauli = ["I"] * num_qubits
        pauli[i] = "X"
        pauli[i + 1] = "X"
        terms.append("".join(pauli))
        coeffs.append(1.0 / (num_qubits - 1))

    # Z fields
    for i in range(num_qubits):
        pauli = ["I"] * num_qubits
        pauli[i] = "Z"
        terms.append("".join(pauli))
        coeffs.append(0.5 / num_qubits)

    observable = SparsePauliOp(terms, coeffs)

    # Compute the ideal final state
    state = Statevector.from_instruction(qc)

    # Compute expectation value
    ideal_value = np.real(state.expectation_value(observable))
    exp_vals.append(ideal_value)

print(exp_vals)

plt.figure()
plt.plot(qubits, exp_vals, "o", label="Statevector")
plt.xlabel("Number of qubits")
plt.ylabel(r"$\langle O^{\otimes N} \rangle$")
plt.legend()
plt.show()
[np.float64(0.7181764372838925), np.float64(0.7181764372838922), np.float64(0.7181764372838931), np.float64(0.7181764372838906), np.float64(0.7181764372838907), np.float64(0.7181764372838709)]
Справді, ми бачимо, що обрали гамільтоніан і стан, які не змінюються з кількістю кубітів. Це дуже погане використання для дослідницького застосування квантових обчислень, але чудове для еталонного тестування методів пом'якшення помилок. Ми можемо впевнено використовувати це фіксоване очікуване значення як ідеальний результат, навіть коли збільшуємо кількість кубітів для тестування пом'якшення помилок.
num_qubits = 30

qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.7, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)

for i in range(num_qubits):
    qc.rz(np.pi / 5, i)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")

# This cell builds the observable

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)

# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)

# Compute the ideal final state
# This might time out above about 26 qubits. The Hamiltonian has been "normalized".
# The same expectation value calculated on the smaller example above is still valid.
# state = Statevector.from_instruction(qc)

# Compute expectation value
# ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.7181764372838709
# This took 5 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.5869884271731322
Тепер запускаємо цей більший circuit із ZNE.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.7096089981595511
Нарешті запускаємо 30-кубітний приклад із PEC.
# This took 4 min 57 sec on ibm_fez. Your actual runtime might vary.

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

value_pec = job_pec.result()[0].data.evs
print("PEC:", value_pec)
PEC: 0.3481257778627795
job_id_none = job_none.job_id()
job_id_zne = job_zne.job_id()
job_id_pec = job_pec.job_id()
print("job number with no mitigation:  ", job_id_none)
print("job number with ZNE  ", job_id_zne)
print("job number with PEC  ", job_id_pec)
job number with no mitigation:   d7uc79back5s73be1cv0
job number with ZNE   d7uc7c3ack5s73be1d40
job number with PEC   d7uc9k4inasc738smhu0
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
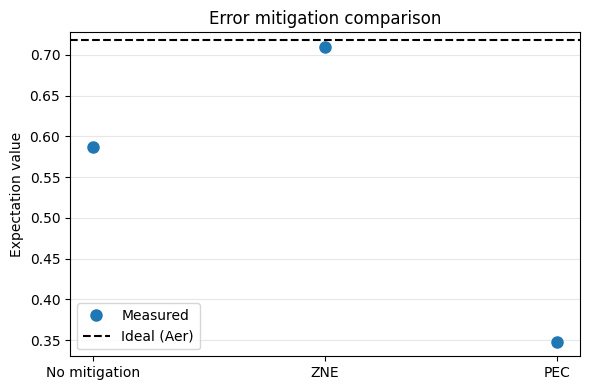
PEC не лише зайняв набагато більше часу, ніж інші варіанти, а й ми явно досягли порогу максимальних накладних витрат. Результати PEC сплатили ціну накладних витрат, але обмеження накладних витрат не дозволило достатньо точно скомпенсувати вивчену модель шуму. Це критично. На шести кубітах ми змогли скористатися PEC і отримати кращі результати лише з помірним збільшенням квантових накладних витрат (приблизно в 5 разів). На 30 кубітах ми заплатили значно вищу ціну (приблизно в 60 разів вищу), а результати були навіть гіршими, ніж непом'якшена оцінка. Це не означає, що PEC ніколи не може працювати з 30 кубітами; це може залежати від circuit. Висновок простий: експоненціальне зростання квантових накладних витрат ускладнює запуск для великих circuit.
Ключові висновки:
-
Пом'якшення помилок вимірювання часто допомагає й зазвичай має низькі накладні витрати: воно усуває зміщення, яке не масштабується з глибиною circuit, і чисто поєднується майже з усім.
-
Деякі методи не можна поєднувати. Навіть коли можна, переконайтеся, що ви поєднуєте їх узгоджено, щоб один не скасовував інший. Хороший приклад — перевірка того, що twirling увімкнено під час калібрування для M3, якщо ці методи поєднуються.
-
PEC і ZNE слід розглядати як альтернативи одне одному. Вони розв'язують ту саму задачу з протилежними компромісами:
-
PEC: дає незміщені очікувані значення ціною експоненціальної дисперсії.
-
ZNE зазвичай дає залишкове зміщення, що залежить від моделі екстраполяції, але за помірної вартості.
-
-
DD може допомогти за довгих періодів простою, але змінює модель шуму й може зробити недійсними припущення екстраполяції чи обернення.
-
Паулі-твірлінг не зменшує шум. Він змінює його форму й часто дозволяє іншим методам працювати краще (ZNE і PEC).