Сучасні робочі процеси
У цьому курсі розглянуто широкий спектр методів роботи з квантовим шумом і помилками. Ми свідомо уникали деяких рішень типу «чорна скринька», щоб побачити, як ці методи працюють. Тепер ми готові використовувати ці методи в їхній найсучаснішій формі. Зокрема, ми розглянемо кілька високооптимізованих інструментів обробки помилок, які приховують від нас частину складності. Ми також розглянемо Samplomatic та addons, як-от shaded lightcones (SLC), що дають нам дуже точний контроль над певними процесами пом'якшення.
У цьому відео доктор Кріс Портер дає огляд цих сучасних інструментів. Ми плануємо додати приклади робочих процесів до цього уроку пізніше. Проте цей урок уже містить усю інформацію, потрібну для використання цих інструментів і складання іспиту на бейдж.
Огляд
Ранні примітиви IBM Quantum, такі як Estimator і Sampler, надавали пом'якшення помилок через невелику кількість попередньо заданих рівнів. Пізніші випуски надали прямішим контроль над окремими техніками, зокрема вибір стратегії екстраполяції до нульового шуму, конфігурації Pauli twirling і параметри рандомізації. Проте ці налаштування залишалися переважно глобальними й застосовувалися однаково до всієї схеми.
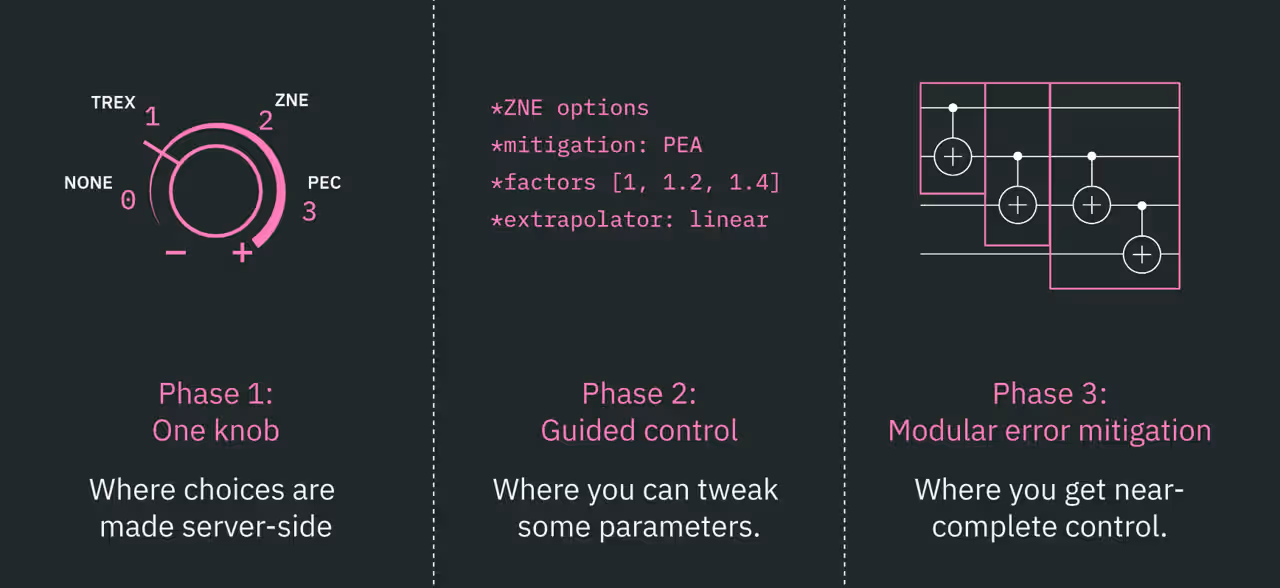
Зі зростанням складності квантових навантажень розробникам дедалі частіше потрібна можливість адаптувати стратегії виконання та пом'якшення до окремих ділянок схеми. Наступна діаграма окреслює кілька ключових інструментів, які розглядає цей урок, і показує, де вони розташовані в типовому робочому процесі.
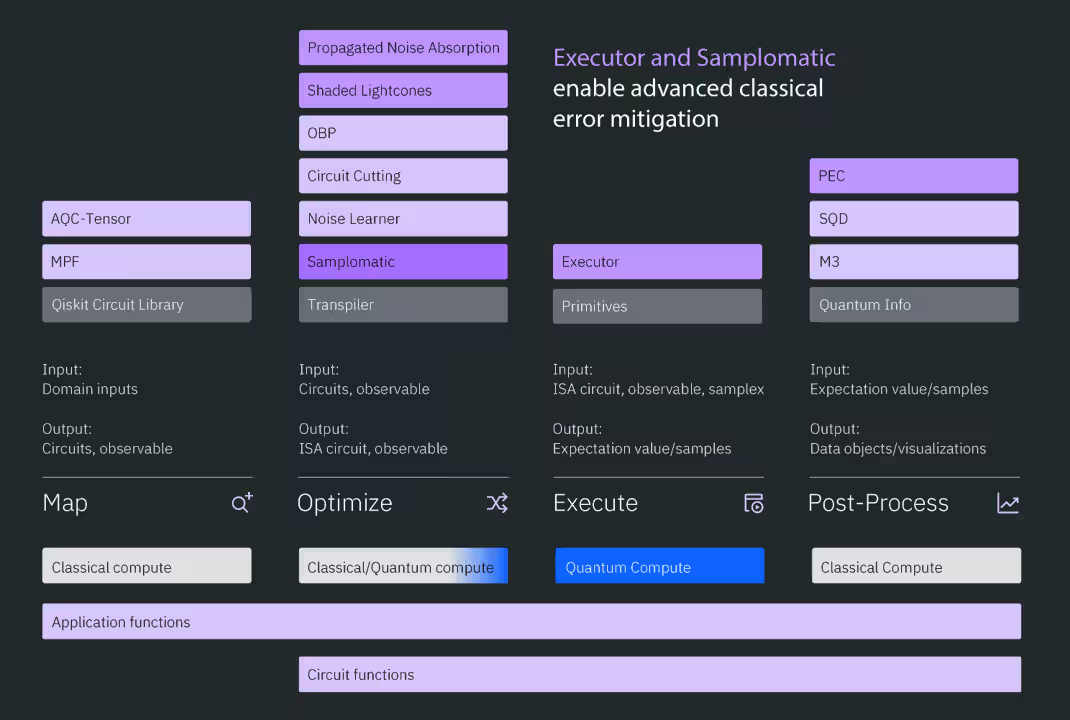
Модель спрямованого виконання відповідає потребі в модульному контролі над виконанням і об'єднує багато з цих інструментів.
Модель спрямованого виконання
Замість неявних рішень щодо виконання модель спрямованого виконання слідує директивам, наданим користувачем. Такий підхід підвищує прозорість і полегшує огляд та налагодження складних робочих процесів. Деякі ключові особливості цієї моделі:
-
Конфігурація для кожного шару через позначені ділянки схеми
-
Визначення унікальних і повторюваних шарів для ефективного навчання шуму
-
Робочі процеси пакетного виконання
-
Структурована постобробка
-
Тісна інтеграція з addons, як-от shaded lightcones
Модель побудована навколо двох ключових компонентів:
-
Samplomatic, який визначає рецепти виконання
-
Executor, який виконує ці рецепти та повертає вибірки
Більшість робочих процесів, що використовують Executor, можна реалізувати й за допомогою Sampler, оскільки обидва зрештою створюють вибірки. Ключова перевага Executor — ефективність. Такі завдання, як генерація конфігурацій twirling, часто виконуються набагато швидше в серверному середовищі майже реального часу, ніж на клієнті. Estimator і Sampler залишаються підтримуваними й можуть бути найзручнішим вибором для багатьох навантажень.
Однак перед виконанням потрібно побудувати й підготувати схему. Qiskit надає кілька addons, які допомагають зі створенням, симуляцією та оптимізацією схем. Щоб дізнатися більше про будь-який із наведених нижче інструментів, перейди за посиланнями.
Побудова квантових схем
Для деяких застосувань або нових підходів користувачам потрібно самостійно визначити, як відобразити свою задачу на квантову схему. Однак у багатьох галузях addons Qiskit можуть автоматизувати важливі частини цього процесу.
Optimization mapper
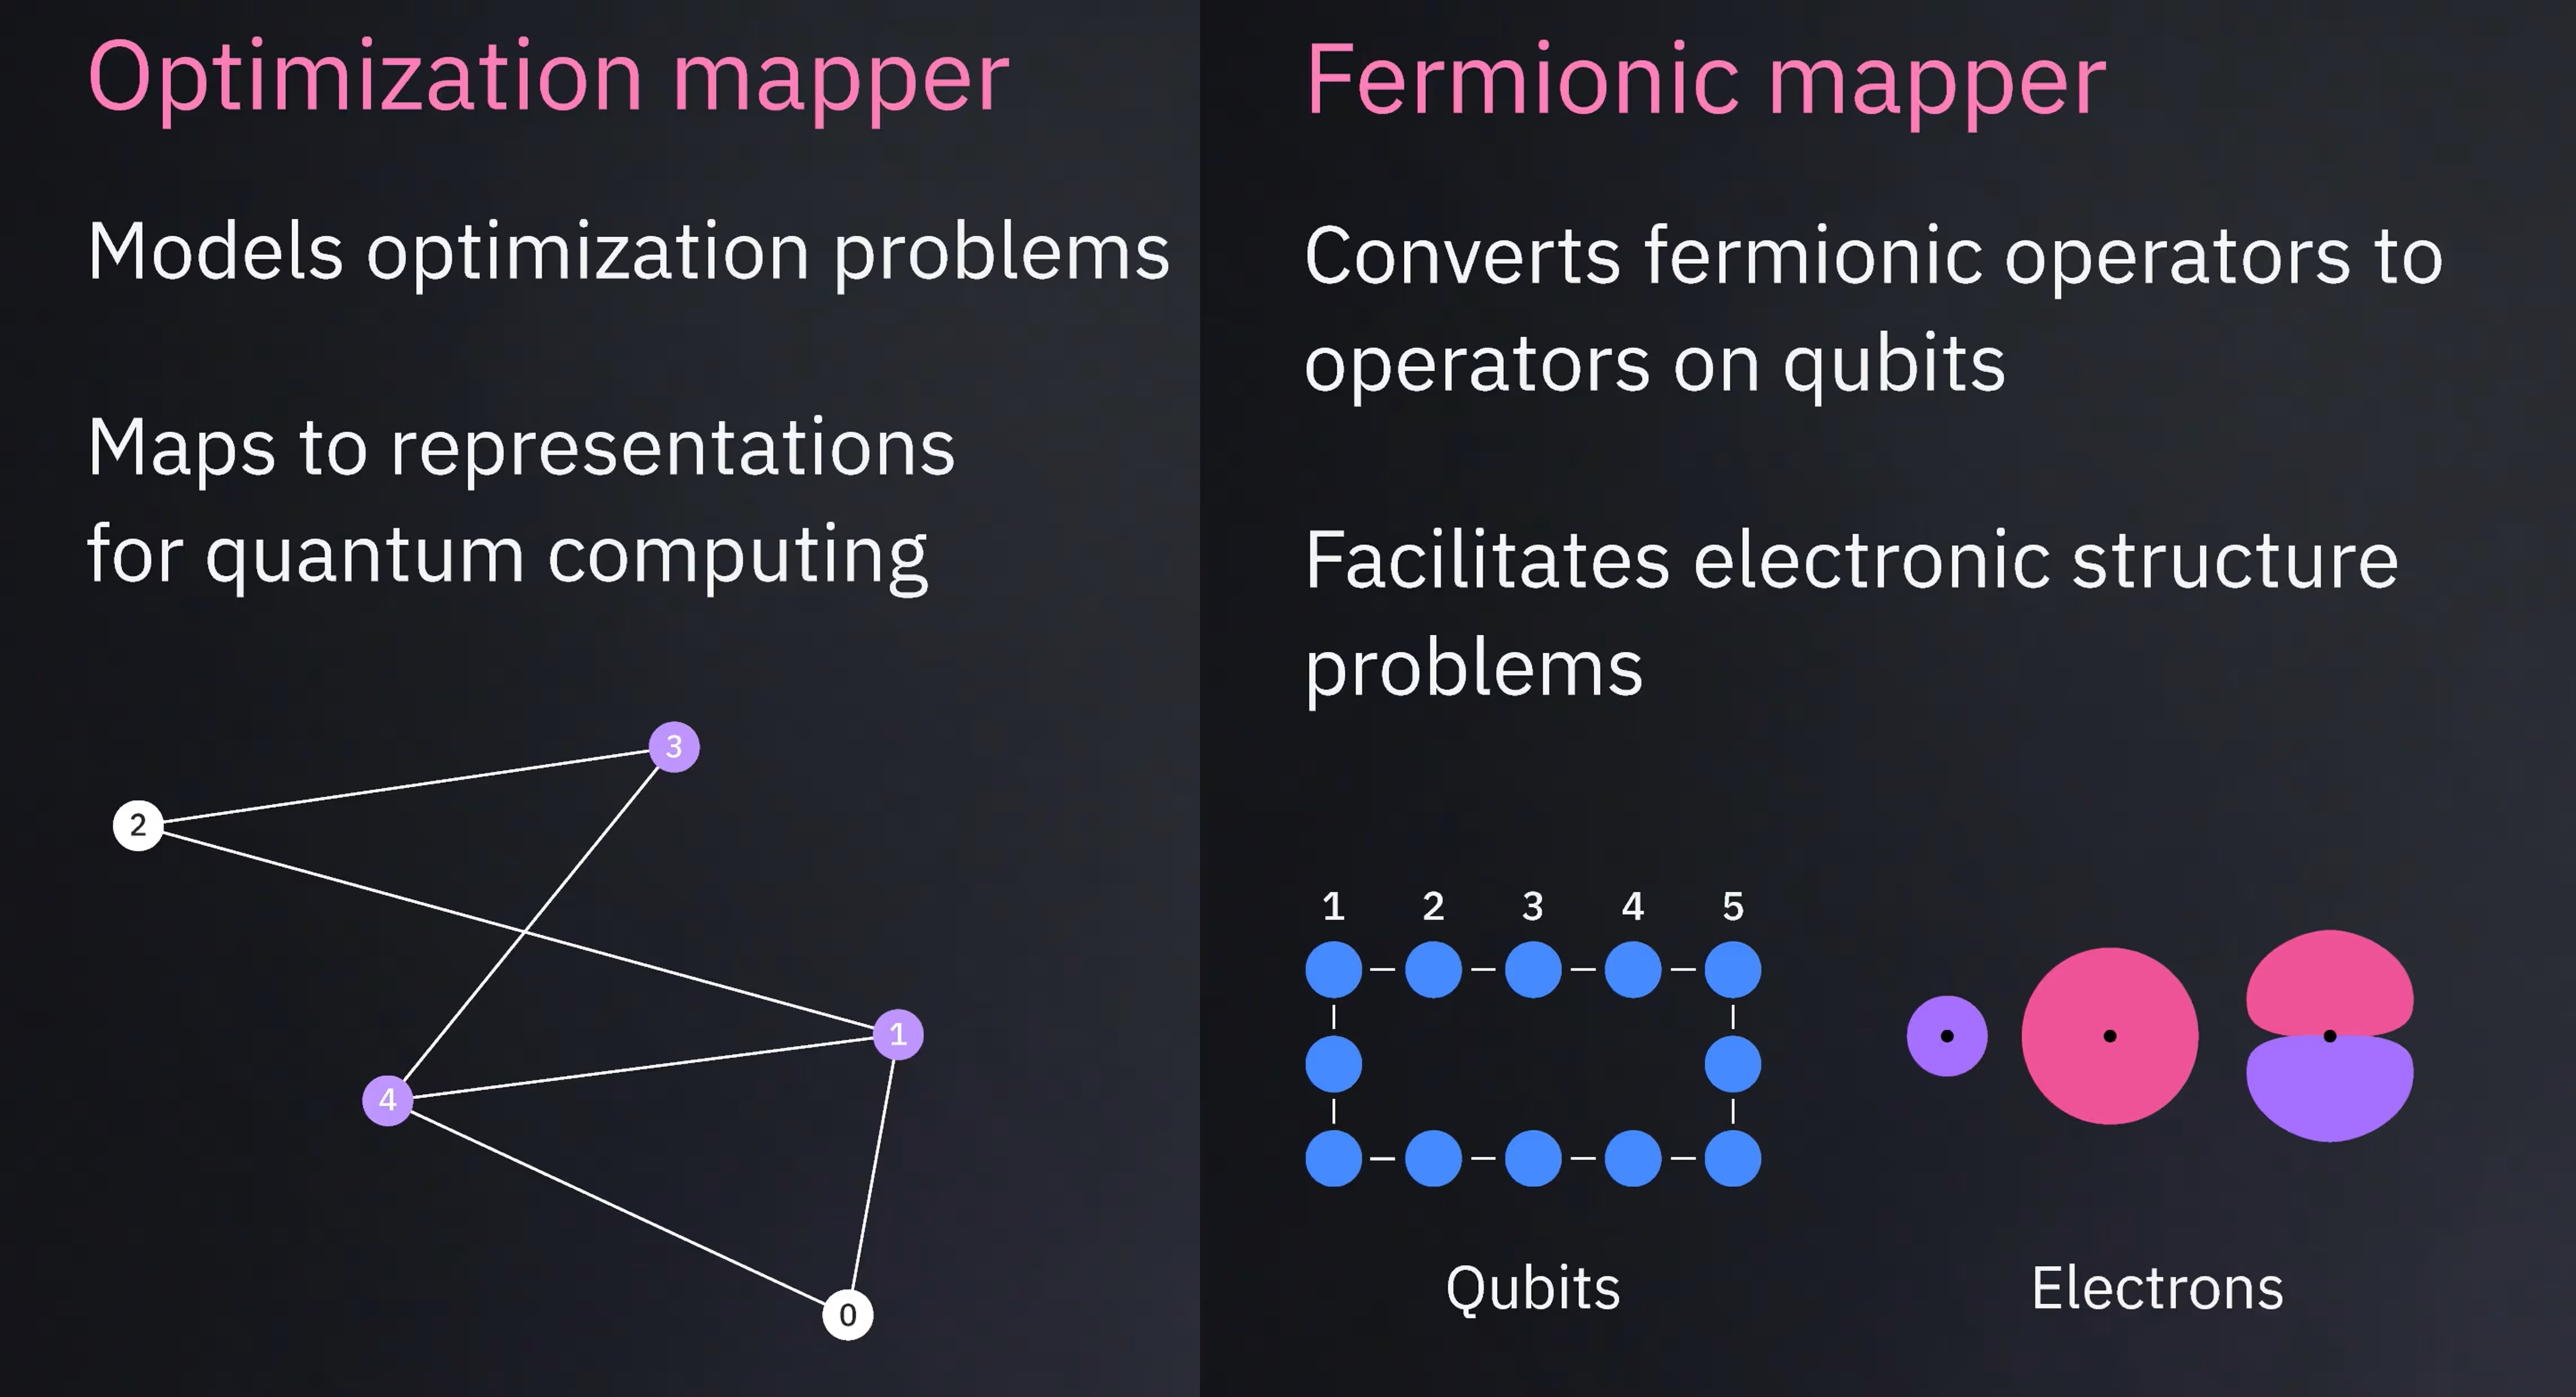
Optimization mapper допомагає виразити класичні задачі оптимізації у формах, придатних для квантових алгоритмів. Ключова функціональність:
-
Побудова цільових функцій і обмежень
-
Перетворення задач у формулювання QUBO
-
Генерація представлень у вигляді гамільтоніана або оператора
Fermionic mapper
Ферміонний мапер перетворює ферміонні оператори на кубітні оператори, придатні для квантового обладнання. Він підтримує відображення, як-от Джордана — Вігнера, яке перетворює оператори на нерозрізнюваних ферміонах на оператори Паулі на розрізнюваних кубітах зі збереженням ферміонної статистики. Цей аддон корисний для застосувань у квантовій хімії та матеріалознавстві.
Попередні два addons зосереджені на початковому відображенні структури задачі на квантову схему. Проте так само важливо ефективно відобразити часову еволюцію процесу на квантову схему та оптимізувати схему, зменшивши її глибину. Наступні кілька addons вирішують ці завдання.
Multi-product formulas (MPF)
Multi-product formulas підвищують точність симуляцій квантової часової еволюції, комбінуючи кілька наближень. Зокрема, ти створюєш схеми з різною кількістю кроків Троттера, щоб використати зважену комбінацію результатів схем. Для заданої цільової точності MPF часто може використовувати менш глибокі схеми, ніж стандартні методи Троттера. Ціною цього є те, що потрібно запускати кілька схем і комбінувати їхні результати класично.
AQC-Tensor
AQC-Tensor виконує наближену квантову компіляцію методами тензорних мереж. Типовий випадок використання — заміна частини глибокої схеми менш глибоким варіаційним наближенням. Отримана схема може досягати подібної точності зі значно меншою глибиною.

Транспіляція
Ти вже багато разів використовував(-ла) транспіляцію в цьому курсі. Ти знаєш, що після побудови абстрактної схеми її потрібно підготувати до виконання на обладнанні. Проте ми ще не розглядали детально різні етапи транспіляції.
Ключові етапи транспіляції:
-
Розміщення (layout): відображення логічних кубітів на фізичні кубіти
-
Трансляція: переписування операцій з використанням рідного набору вентилів бекенда
-
Маршрутизація: вставлення та оптимізація операцій SWAP, потрібних через зв'язність обладнання
Ці процеси взаємопов'язані. Наприклад, розміщення має мінімізувати глибину навіть після врахування маршрутизації. Розміщення також має уникати найбільш схильних до помилок кубітів і з'єднань. Ці етапи часто автоматизовані, але досвідчені користувачі можуть за потреби задати власні розміщення чи інші обмеження.

Щоб дізнатися більше про транспіляцію, дивись посібник Вступ до транспіляції.
Перевір своє розуміння
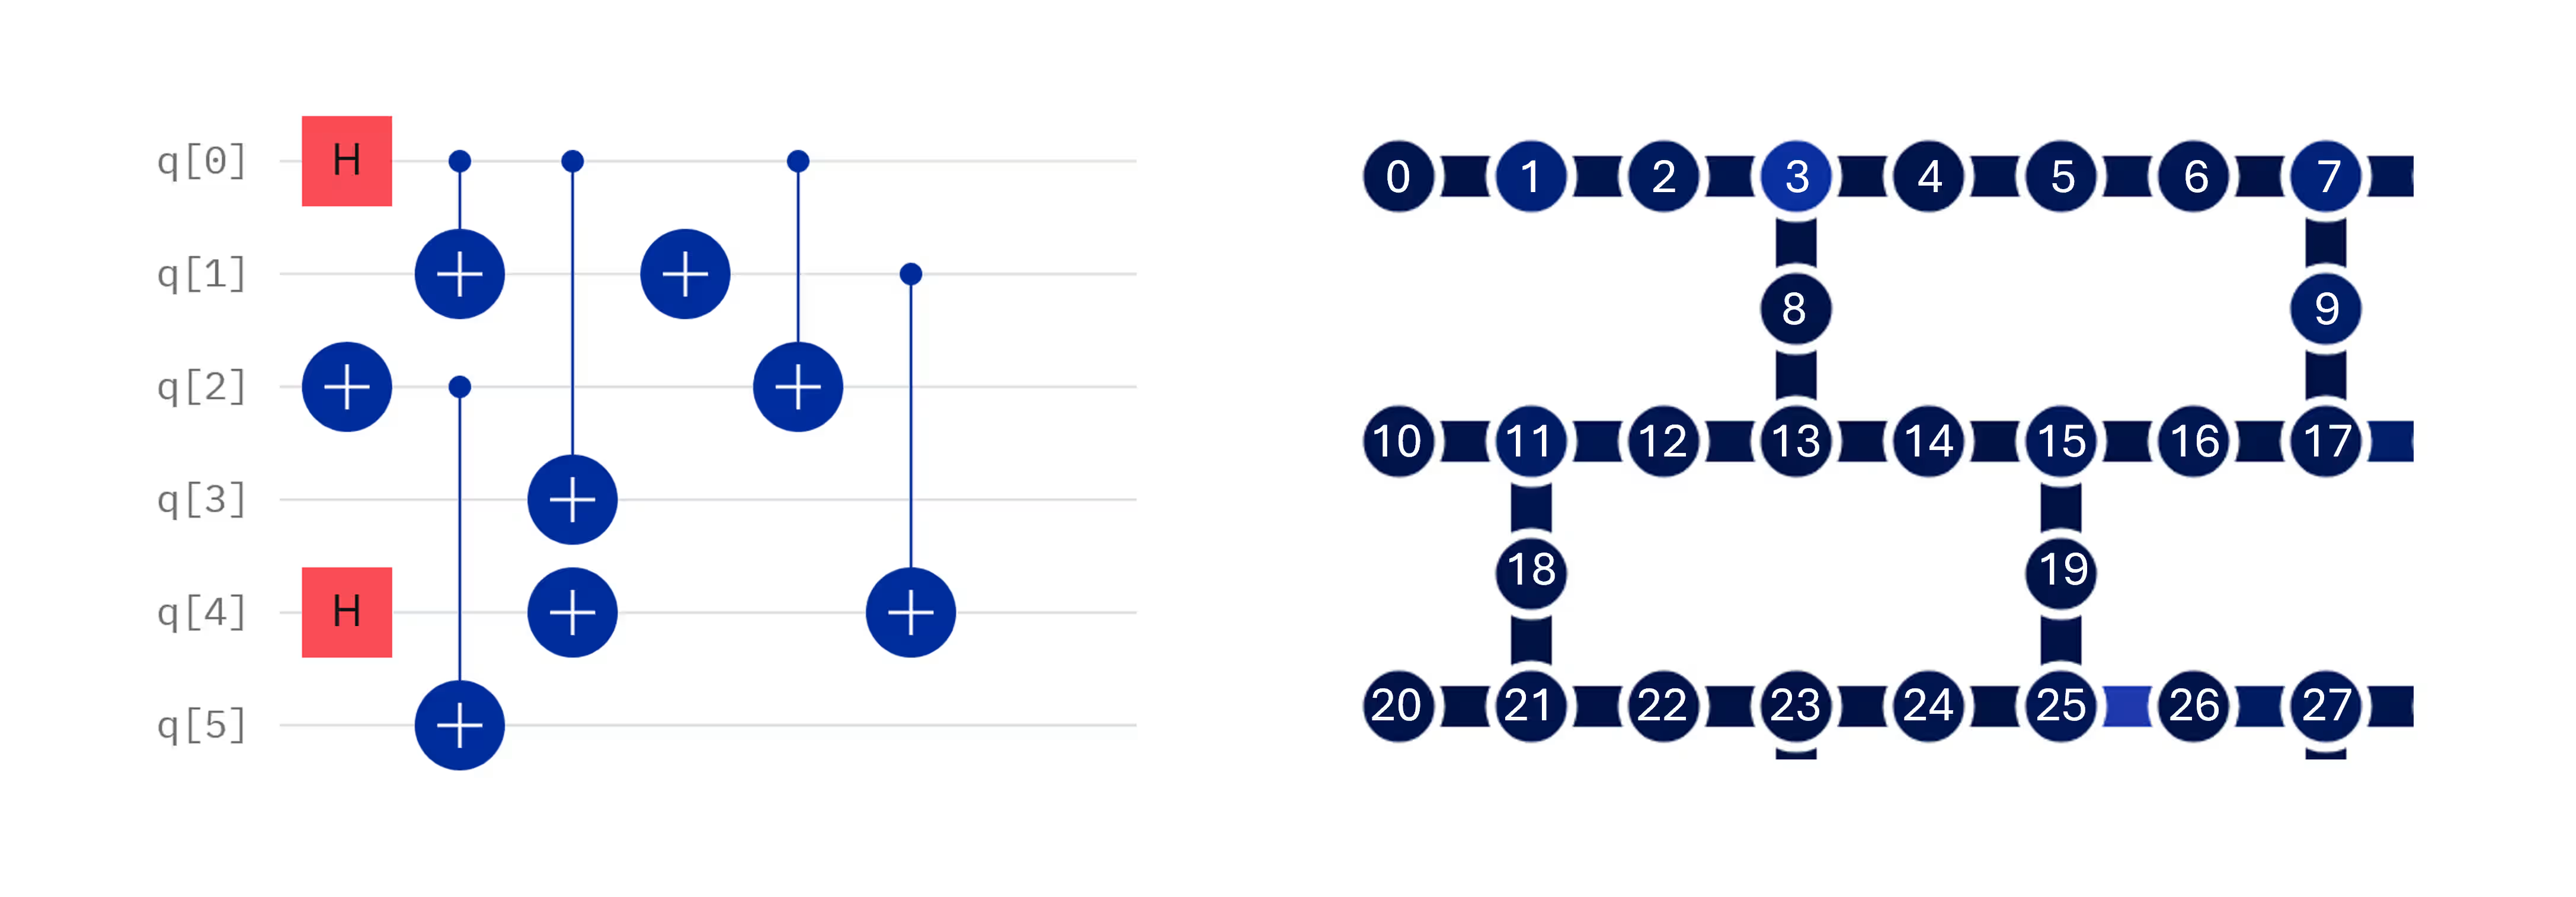
Подивись на наступну квантову схему й припусти, що тобі потрібно запустити її на квантовому комп'ютері з розташуванням heavy-hex, частину якого показано. (а) Запропонуй відображення номерів кубітів абстрактної схеми на номери кубітів фізичного квантового комп'ютера, яке мінімізує кількість потрібних вентилів SWAP. (б) Чи є твій вибір єдиним, чи можуть бути інші настільки ж добрі варіанти? (в) Навіть якщо твій вибір — єдине оптимальне розміщення для зменшення кількості вентилів SWAP, які причини можуть змусити транспайлер обрати інше відображення?
Відповідь
(а) Правильних відповідей може бути багато, але зверни увагу, що лише абстрактний кубіт 0 має заплутувальні (двокубітні) вентилі з трьома сусідами. Усі інші беруть участь у двокубітних операціях лише з двома сусідами. Цю схему можна відобразити на топологію heavy-hex без жодних вентилів SWAP. Прийнятне будь-яке розміщення, що це забезпечує. Використовуючи для позначення абстрактного кубіта нуль, а — для транспільованого кубіта нуль, одне з таких розміщень:
(б) Це розміщення не єдине. Багато інших розміщень узагалі уникають вентилів SWAP. Ще один приклад:
(в) Іноді конкретний кубіт на чипі більш схильний до помилок, ніж більшість інших. Також деякі з'єднання між кубітами більш схильні до помилок, ніж інші. Транспайлер намагається знайти розміщення, яке уникає зайвих вентилів SWAP, але також використовує кубіти та з'єднання з найвищою точністю, доступні на вибраному квантовому комп'ютері.
Зменшення впливу шуму та помилок
Кілька addons Qiskit зосереджені саме на зменшенні впливу шуму та недосконалостей обладнання.
Зворотне поширення оператора та шумозалежні перетворення схем
Ми вже обговорювали поширення оператора в контексті когерентних перевірок Паулі у корекції помилок. Проте поширення оператора корисне загальніше. Є два основні способи використання поширення оператора крізь квантову схему: (1) увібрати кілька останніх шарів квантової схеми у вимірювані спостережувані, та (2) врахувати ймовірні наслідки помилок у схемі й компенсувати їх, вимірюючи інше спостережуване. Наступні два інструменти використовують ці підходи.
Зворотне поширення оператора
Зворотне поширення оператора зменшує глибину кола, поглинаючи вентилі з кінця схеми у вимірюване спостережуване. Наприклад, розглянь наступне коло.

Ця схема містить шари обертань і заплутування, які виглядають нетривіальними, після яких іде драбина вентилів CNOT і вимірювання Z на кубіті 5. Ця схема має двокубітну глибину 7. Ця глибина вказана до транспіляції. На практиці зворотне поширення зазвичай застосовують після транспіляції, але цей приклад має лише навчальну мету. Пам'ятай, що існують правила поширення спостережуваного повз вентиль. Зокрема, коли вентиль CNOT має ціль і керування , спостережуване на стає при поширенні назад повз вентиль CNOT: . У цій прикладній схемі, якщо поширити спостережуване назад через усю драбину вентилів CNOT, отримаємо спостережуване , або в стандартних позначеннях Qiskit просто . Якщо вимірювати це спостережуване замість лише , можна видалити всю драбину вентилів CNOT, що зменшує двокубітну глибину з 7 до 2. Це спостережуване все одно потребує вимірювання лише в одному базисі на кожному кубіті, тому воно не збільшує потрібну кількість shots. Так буває не завжди. Загалом складніші спостережувані потребують більше shots, а іноді й більше вимірювань у різних базисах.
Загальна стратегія зворотного поширення оператора містить такі кроки:
-
Скоротити виконувану схему
-
Замінити початкове спостережуване розширеним спостережуваним
-
Обміняти глибину схеми на підвищені вимоги до семплювання
Попередня схема — очевидний приклад, у якому зворотне поширення вигідне. Проте загалом непросто визначити схеми, які найбільше виграють від зворотного поширення. Щоб вирішити, коли його використовувати, перевір, скільки глибини можна прибрати зі схеми, і зваж це зменшення проти підвищених вимог до семплювання.
Propagated noise absorption (PNA)
Поглинання поширеного шуму структурно подібне до зворотного поширення оператора. Однак замість того щоб поширювати оператор назад крізь ідеальні вентилі схеми, PNA включає вивчену модель шуму і поширює вплив шуму безпосередньо на спостережуване. PNA робить таке:
-
Вивчає поведінку шуму на обладнанні
-
Поширює модель шуму крізь схему
-
Створює змінене спостережуване, що компенсує шум вентилів
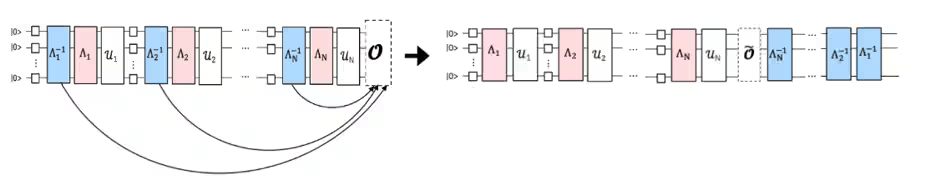
Коли змінене спостережуване вимірюється на шумному обладнанні, отримані очікувані значення краще наближають ідеальний результат без шуму. PNA має два типи накладних витрат. По-перше, потрібно вивчити модель шуму, що вимагає запуску додаткових схем. По-друге, PNA може створювати складніші спостережувані, що може збільшити вимоги до семплювання.
Розрізання схеми
Розрізання схем розбиває велику схему на менші підсхеми, які можна виконувати незалежно. Потім ти виконуєш достатньо вимірювань, щоб об'єднати результати. Розрізання схем робить таке:
-
Зменшує вимоги до апаратного забезпечення
-
Дозволяє виконувати обчислення, більші за доступну кількість кубітів (ширші схеми)
-
Допомагає подолати обмеження глибини та зв'язності (глибші схеми)
-
Відновлює початковий результат за допомогою класичної постобробки

Samplomatic
Багато технік з попередніх розділів доповнюють інші методи пригнічення та пом'якшення шуму, розглянуті в цьому курсі, зокрема:
-
Динамічне розв'язування
-
Паулі-твірлінг
-
M3
-
TREX
-
Екстраполяція до нульового шуму (ZNE)
-
Ймовірнісне скасування помилок (PEC)
У багатьох робочих процесах до різних ділянок однієї й тієї самої схеми можна застосовувати різні техніки. Як ми бачили, багато з цих технік також мають квантові накладні витрати. Тому іноді нам потрібен точний, детальний контроль над навчанням шуму, семплуванням і застосуванням послідовностей твірлінгу. Це одні з мотивів створення Samplomatic.
Samplomatic — це бібліотека з відкритим кодом, яка забезпечує налаштовувані робочі процеси семплювання, рандомізації та пом'якшення помилок.
Її перше завдання — проаналізувати схему та розділити її на марковані ділянки, або блоки. Ці блоки слугують двом цілям:
-
Вони наочно розбивають схему.
-
Вони створюють індексовані ділянки, які можна налаштовувати незалежно.
Користувачі можуть додавати анотації, що описують, як слід поводитися з кожним блоком під час виконання. Приклади:
-
Застосування Паулі-твірлінгу до всіх блоків
-
Застосування твірлінгу лише до вибраних блоків
-
Використання різних груп твірлінгу в різних ділянках
-
Введення навченого шуму в певні шари
-
Детальне налаштування стратегій пом'якшення
Samplomatic також визначає повторювані блокові ділянки. Оскільки ідентичні шари зазвичай мають схожі характеристики шуму, навчання шуму потрібно виконати лише один раз для кожного унікального шару.
Вихідні дані Samplomatic
Samplomatic створює два основні об'єкти:
-
Шаблонна схема
-
Samplex
Шаблонна схема — це розбита на блоки, транспільована, параметризована схема, готова до виконання. Samplex містить усю інформацію, необхідну для генерації та обробки варіантів схеми. Вміст samplex включає:
-
Значення параметрів для параметризованих схем
-
Вибір рандомізації
-
Розподіли семплування
-
Інформацію для постобробки
-
Додаткові метадані виконання
Формально, samplex — це розподіл імовірностей за параметрами шаблонної схеми разом із допоміжною інформацією, необхідною для виконання та постобробки. Важлива практична перевага полягає в тому, що і шаблонна схема, і samplex створюються локально на стороні клієнта. Тому ти можеш перевірити, валідувати та налагодити їх до того, як використаєш будь-які апаратні ресурси.
Samplomatic має багато переваг, зокрема детальний контроль адаптивного розподілу шотів і рандомізації. Він також має логістичні переваги, як-от структуровані робочі процеси постобробки. Одна з найважливіших переваг — повторне використання навченої інформації про шум для ідентичних шарів, що може заощадити значну кількість квантового обчислювального часу під час навчання шуму.
Затінені світлові конуси
Перш ніж вирішити, де застосовувати дорогі техніки пом'якшення, корисно визначити ділянки схеми, найважливіші для спостережуваного, що вимірюється. Ця потреба мотивує додаток shaded lightcones. Ідея світлового конуса походить з теорії відносності, де причинно-наслідкові зв'язки обмежені скінченною швидкістю поширення інформації.
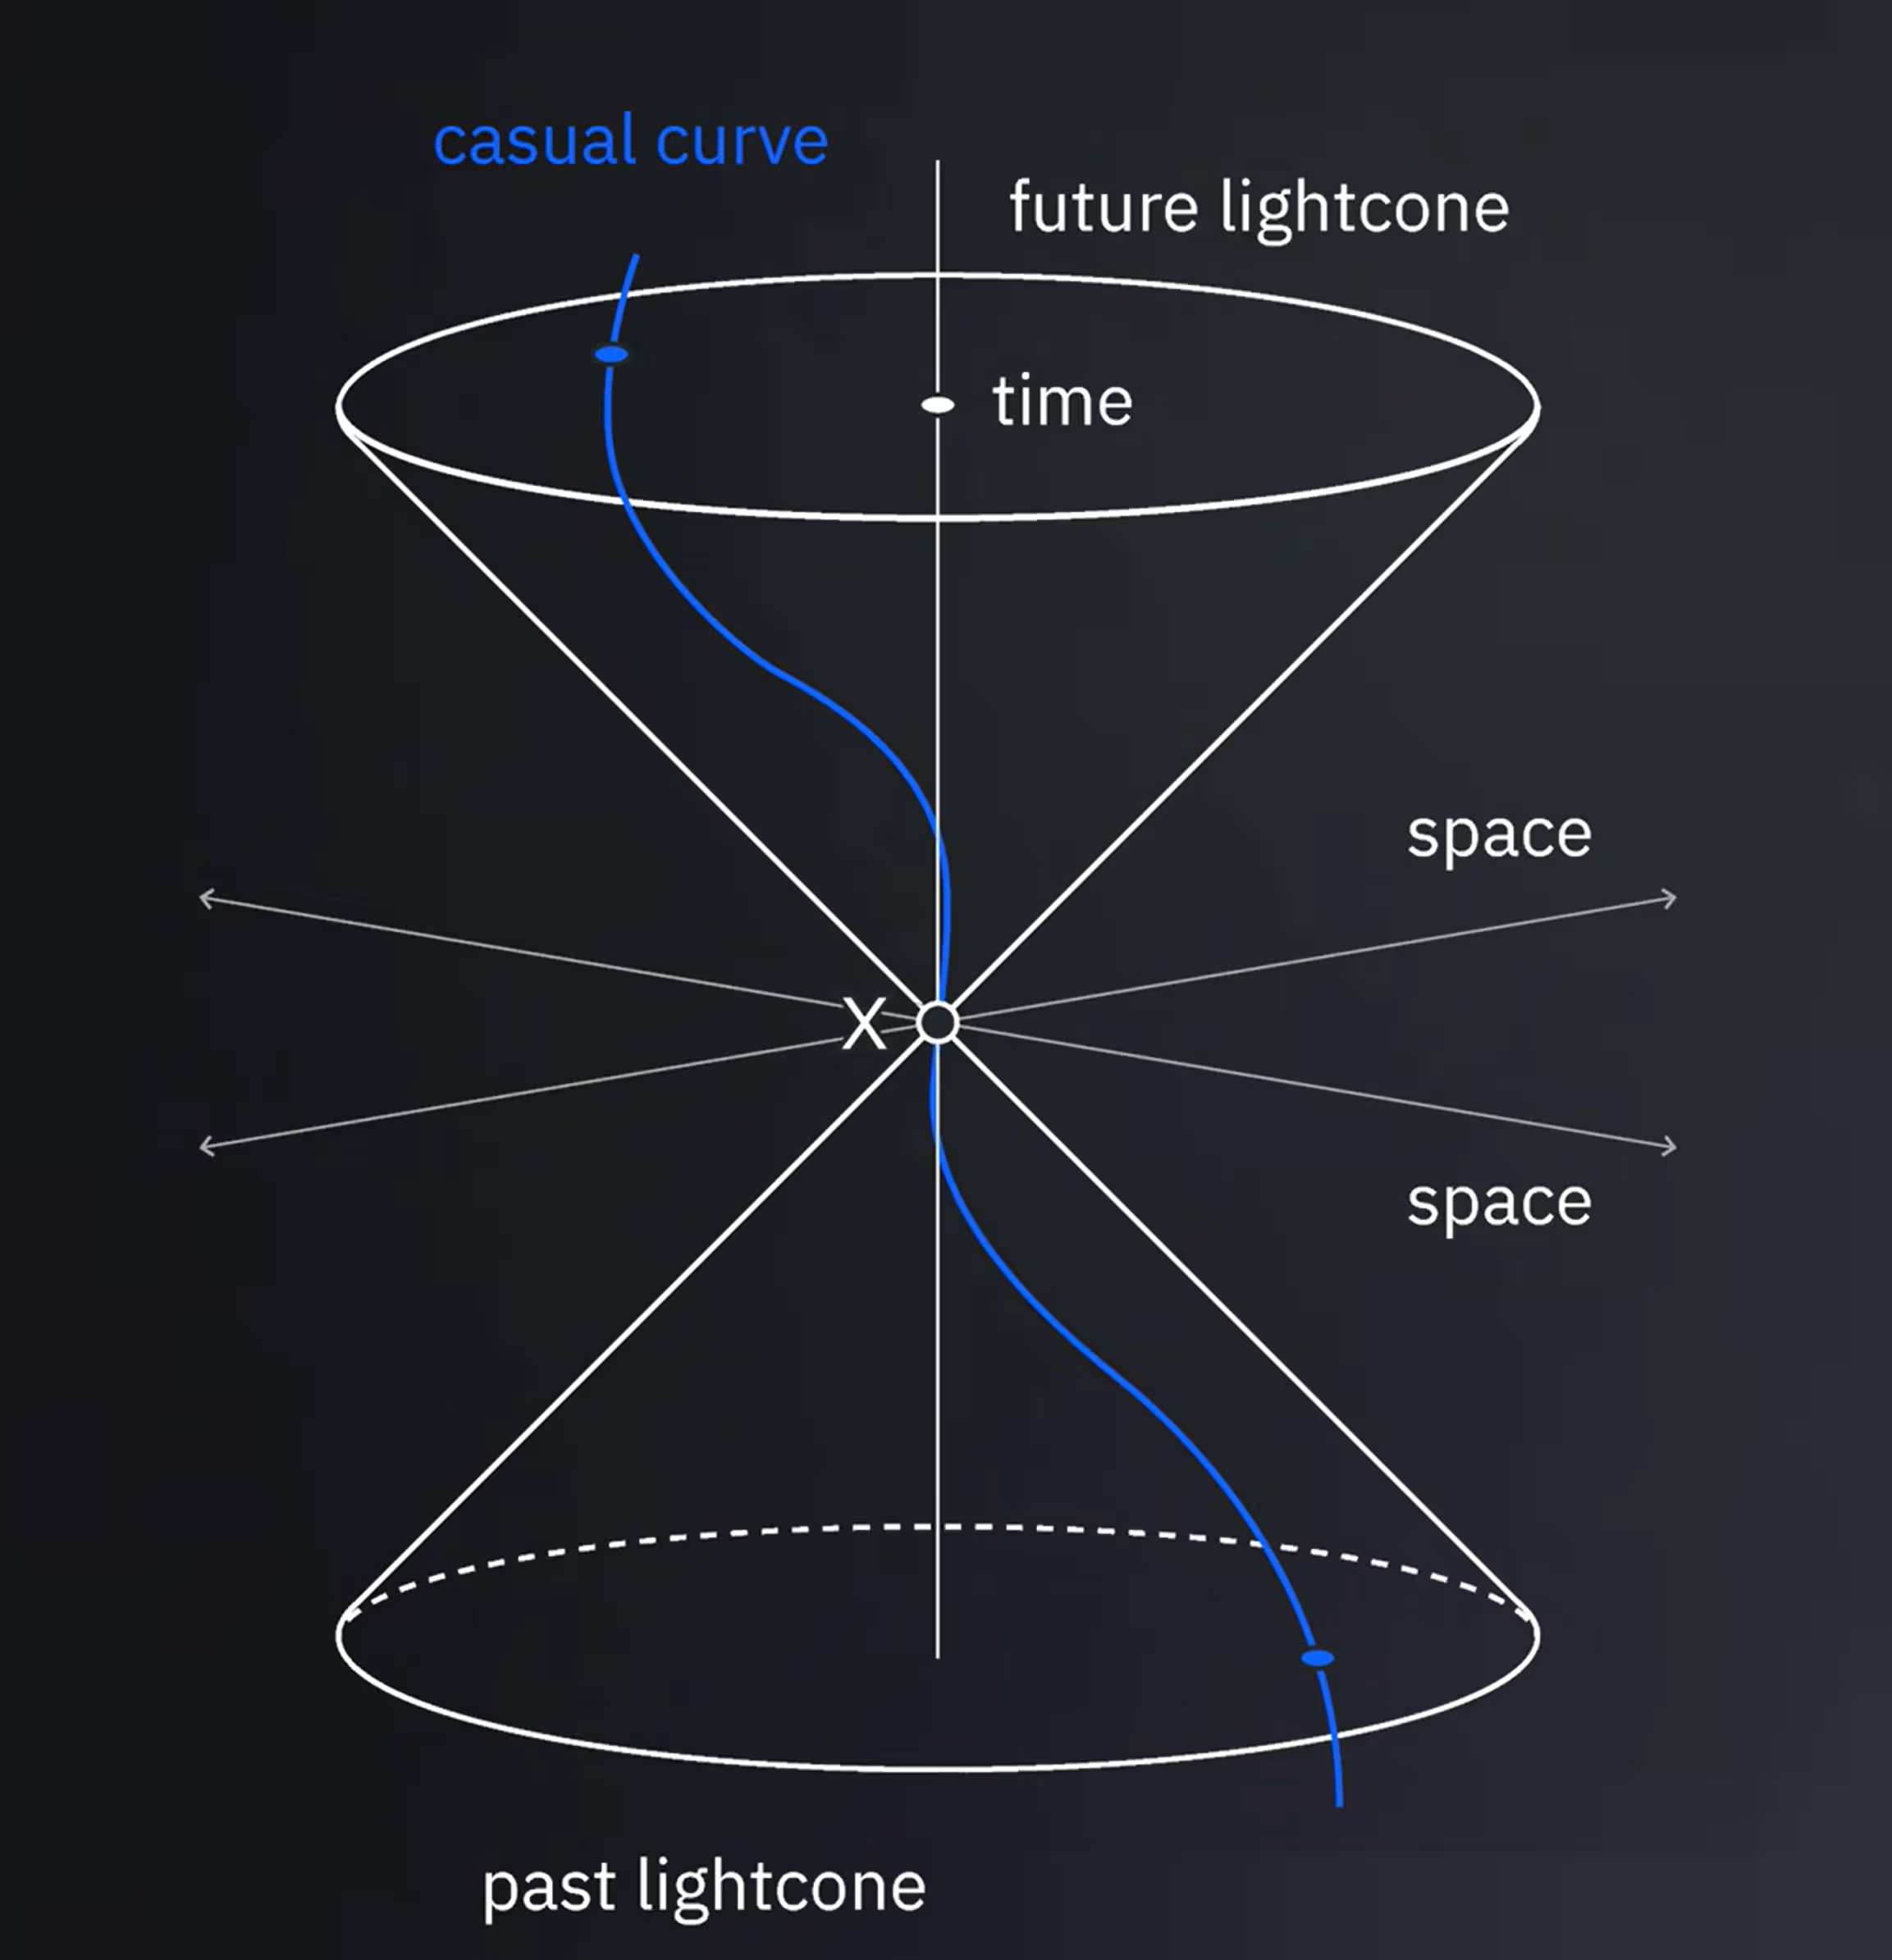
Подібна концепція застосовна до квантових схем.
Розглянь велику схему, в якій цікавить лише спостережувана з малою вагою. Спостережувана з малою вагою діє нетривіально лише на кількох кубітах. Такі спостережувані цікаві з багатьох причин. Наприклад, вони можуть представляти таке:
-
Окремі доданки у більшому гамільтоніані
-
Локалізовану область взаємодії
-
Інформацію, зібрану на невеликому наборі допоміжних кубітів
-
Інші спостережувані, що залучають лише кілька кубітів
Не кожна помилка в схемі може впливати на результат вимірювання. Це особливо стосується помилок Паулі або будь-якої помилки, яку можна змоделювати як набір операцій Паулі. Наприклад, подивись на таку схему:
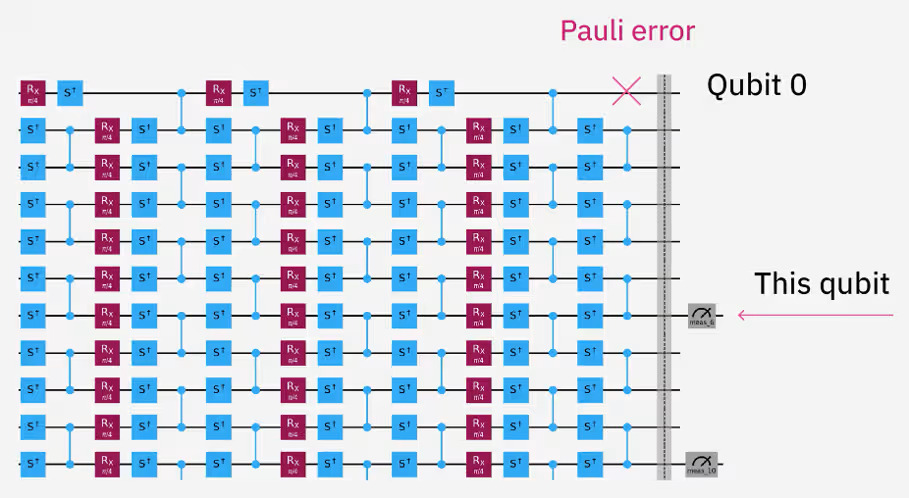
Помилка Паулі на кубіті 0 в останньому шарі не може вплинути на вимірювання кубіта 6, оскільки немає з'єднувального вентиля, який міг би поширити помилку від кубіта 0 до кубіта 6. Зауваж, що цей аргумент не застосовний до певних неунітарних помилок. Наприклад, T1-подібний перехід у основний стан на кубіті 0 колапсує кубіт 0 до базисного стану обчислень. Якщо кубіти 0 і 6 були раніше заплутані (як у цій схемі), неунітарна помилка на кубіті 0 може вплинути на кубіт 6. Подальше обговорення зосереджене на помилках, які можна подати як операції Паулі або як ймовірнісні суміші операцій Паулі.
В останньому шарі лише помилка Паулі на кубіті 5 або кубіті 6 може безпосередньо вплинути на вимірювання кубіта 6.
У заплутувальному шарі перед ним кубіти 5 і 6 заплутуються з кубітами 4 і 7 відповідно. Тому в цьому заплутувальному шарі або безпосередньо перед ним помилка Паулі на будь-якому з цих чотирьох кубітів може вплинути на подальше вимірювання. Ти можеш і далі простежувати схему назад, щоб знайти підмножину вентилів і кубітів, причинно пов'язаних із вимірюванням. Ця причинна множина утворює конусоподібну область у просторі (кубіти) та часі (шари), звідки походить термін «світловий конус». Точна форма області різниться від схеми до схеми. Оскільки цей аналіз залежить від зв'язності апаратного забезпечення та розміщення вентилів, він найкорисніший після транспіляції, маршрутизації та оптимізації розкладки.
Поза причинною зв'язністю
Затінені світлові конуси розширюють цю ідею, також враховуючи, які типи помилок мають значення.
Наприклад, зверни увагу на таке:
-
Помилка Z безпосередньо перед вимірюванням у базисі Z не впливає на результат вимірювання.
-
Помилка X безпосередньо перед вимірюванням у базисі Z може кардинально змінити результат.
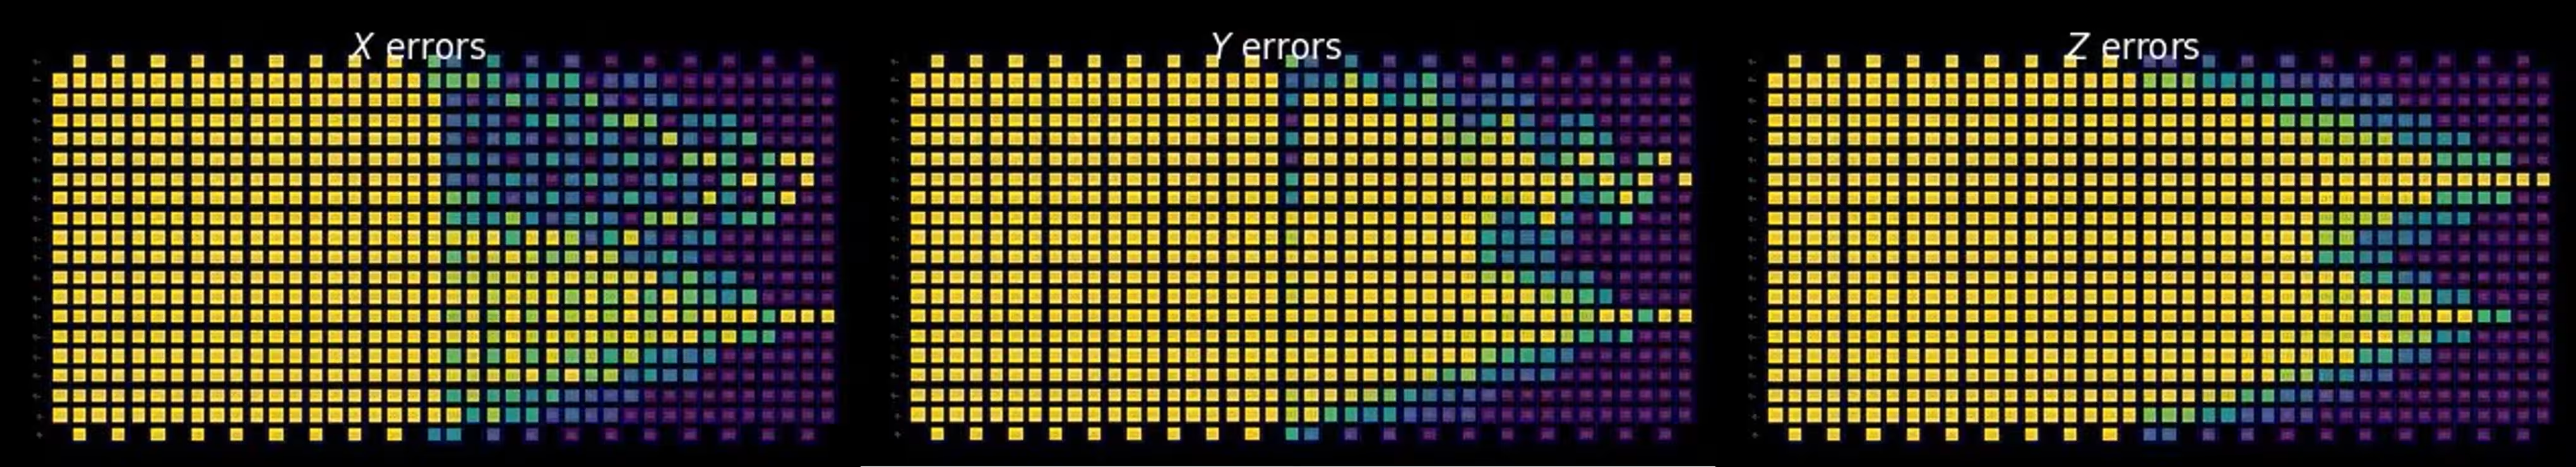
Тому деякі типи помилок заслуговують більших зусиль із пом'якшення, ніж інші. Ця відмінність може суттєво зменшити накладні витрати таких технік, як PEC. На практиці додаток генерує окремі аналізи чутливості для кожного з таких типів помилок:
-
X errors
-
Z errors
-
Помилки Y (або XZ з точністю до фази)
Ця чутливість до помилок зазвичай виглядає по-різному для кожного типу помилок, оскільки різні причинно пов'язані помилки по-різному впливають на вимірювання. Зауваж також, що чутливість змінюється по всій схемі. Помилка X безпосередньо перед вимірюванням може бути дуже руйнівною, тоді як помилка, що виникла багато шарів раніше, може мати менший вплив після поширення через сильно заплутаний стан.
Затінені світлові конуси кількісно описують цю відмінність, приписуючи значення чутливості потенційним помилкам по всій схемі.
Отримані карти показують таке:
-
Де помилки мають значення
-
Які типи помилок мають значення
-
Наскільки сильно вони впливають на кінцеву спостережувану
Затінені світлові конуси самі не пом'якшують помилки, але можуть допомогти зосередити зусилля з пом'якшення там, де вони дають найбільшу користь.
Навчання та введення шуму
Після того як схему побудовано, оптимізовано та анотовано, залишаються два взаємодоповнювальні завдання: навчання шуму та використання моделі шуму (наприклад, для введення шуму або поширення його наслідків).
NoiseLearnerV3
NoiseLearnerV3 — це поточний інструмент для навчання шуму. Попередній інтерфейс NoiseLearner приймав цілі схеми та створював моделі шуму Паулі-Ліндблада. NoiseLearnerV3 натомість працює безпосередньо з інструкціями схеми, розбитими на блоки. Підсумовуючи, NoiseLearnerV3 робить таке:
-
Приймає колекції маркованих шарів схеми
-
Повторно використовує інформацію з повторюваних шарів
-
Підтримує навчання шуму вимірювання
-
Підтримує постобробку навчених моделей
-
Уможливлює робочі процеси введення та масштабування шуму
Ця архітектура тісно узгоджується з шаровим робочим процесом Samplomatic. Зокрема, NoiseLearnerV3 використовує такі методи для кожного набору інструкцій:
-
Навчання Паулі-Ліндблада для операцій вентилів
-
Навчання на основі TREX для вимірювань
Потім ти можеш використати навчену модель шуму в багатьох методах, які ми вже розглянули. Наприклад, згадай, що екстраполяція до нульового шуму (ZNE) зі згортанням вентилів може призводити до нездоланно глибоких схем. Альтернативним методом масштабування шуму в такому випадку було семплування з відомої моделі шуму, що фактично збільшує рівень шуму, навіть на нецілі коефіцієнти. Цей метод, ймовірнісне підсилення помилок (PEA), — хороший приклад того, як можна використати модель шуму для пом'якшення помилок. Хороша модель шуму також потрібна для ймовірнісного скасування помилок (PEC) та поглинання поширеного шуму (PNA).
Коротко кажучи, з якісною моделлю шуму шум стає програмованим ресурсом, а не лише джерелом помилок.
Затінені світлові конуси проти NoiseLearnerV3
NoiseLearnerV3 і SLC тісно пов'язані, але мають різні вхідні дані та відповідають на різні запитання. SLC визначає, де зосередити зусилля з пом'якшення. NoiseLearnerV3 характеризує фактичний шум, присутній у цих ділянках. Ці процеси також передбачають різні види накладних витрат. У таблиці нижче підсумовано ці відмінності.
| Затінені світлові конуси | NoiseLearnerV3 | |
|---|---|---|
| Призначення | Визначає, де пом'якшення має значення | Навчається, як поводяться помилки |
| Накладні витрати | Переважно класичні накладні витрати | Потребує виконань на апаратному забезпеченні |
| Вихід | Створює карти чутливості | Створює описи каналів шуму |
| Вхід | Використовує структуру схеми та поширення операторів | Використовує структуру схеми та експериментальні апаратні дані |
Executor і виконання в середовищі виконання
Executor виконує заключний крок виконання. Він може працювати з будь-якими з таких вхідних даних:
-
Шаблонна схема та samplex, згенеровані Samplomatic
-
Звичайна квантова схема без Samplomatic
Завдяки цій гнучкості ти можеш застосовувати стільки компонентів спрямованого робочого процесу виконання, скільки потрібно.
Executor тісно співпрацює з Samplomatic, який керує вибором рандомізації, розподілом шотів, вибором введення шуму та пов'язаними метаданими виконання, як описано раніше.
Практичні приклади моделі спрямованого виконання дивись у посібнику Модель спрямованого виконання, а також у навчальних посібниках і документації з додатків Qiskit на IBM Quantum® Platform.
Висновок
Сучасні квантові робочі процеси дедалі більше спираються на набір взаємодоповнювальних інструментів, а не на єдиний примітив виконання.
Ці інструменти підтримують кожен етап робочого процесу:
-
Відображення задачі
-
Побудова схем
-
Транспіляція та оптимізація
-
Пригнічення помилок
-
Пом'якшення помилок
-
Навчання шуму
-
Структуроване виконання
-
Постобробка
Разом такі інструменти, як Samplomatic, Executor, NoiseLearnerV3, затінені світлові конуси, поглинання поширеного шуму, розрізання схем і AQC-Tensor, забезпечують значно більше контролю, ніж попередні моделі виконання.
Галузь продовжує швидко розвиватися. У міру того як квантові процесори стають більшими та більш зв'язними, ці техніки, імовірно, відіграватимуть дедалі важливішу роль у досягненні корисної квантової переваги та, зрештою, у безшовній інтеграції з робочими процесами відмовостійких квантових обчислень.