Порівняння налаштувань транспілятора
Версії пакетів
Код на цій сторінці розроблено з використанням наведених нижче залежностей. Рекомендуємо використовувати ці або новіші версії.
qiskit[all]~=2.5.2
qiskit-ibm-runtime~=0.47.0
Різні налаштування транспілятора забезпечують різні типи оптимізації схеми, нерідко ціною збільшення часу класичної обробки. Цей посібник проводить через повний процес створення, транспіляції та відправки схем, щоб продемонструвати перевірку продуктивності різних налаштувань.
Зауваж, що одне й те саме налаштування може покращити результати для однієї схеми і погіршити — для іншої. Обов'язково перевіряй отримані транспільовані схеми перед запуском на реальному залізі.
Налаштування та створення прикладу схеми
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"qiskit": "qiskit", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
# Create circuit to test transpiler on
from qiskit import QuantumCircuit
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit.circuit.library import grover_operator, DiagonalGate

# Use Statevector object to calculate the ideal output
from qiskit.quantum_info import Statevector
from qiskit.visualization import plot_histogram
from qiskit.transpiler import PassManager

from qiskit.circuit.library import XGate
from qiskit.quantum_info import hellinger_fidelity
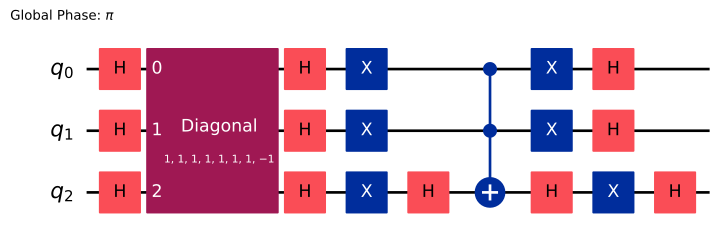
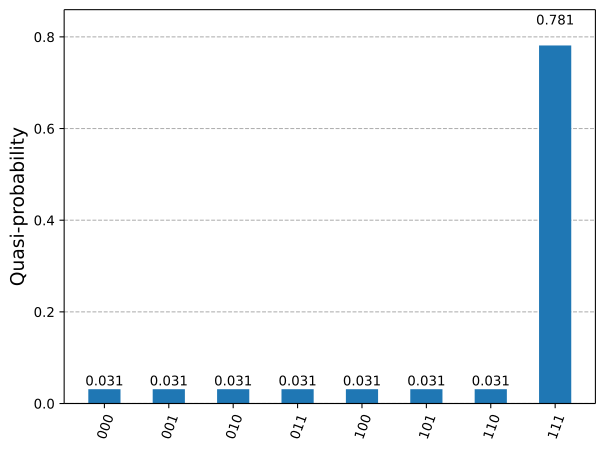
Створимо невелику схему, яку транспілятор спробує оптимізувати. У цьому прикладі будується схема, що реалізує алгоритм Гровера з оракулом, що позначає стан 111. Далі симулюємо ідеальний розподіл (той, який ти отримав би, запустивши схему на ідеальному квантовому комп'ютері нескінченну кількість разів), щоб порівняти його з результатами пізніше.
oracle = DiagonalGate([1] * 7 + [-1])
qc = QuantumCircuit(3)
qc.h([0, 1, 2])
qc = qc.compose(grover_operator(oracle))

qc.draw(output="mpl", style="iqp")
ideal_distribution = Statevector.from_instruction(qc).probabilities_dict()

plot_histogram(ideal_distribution)
Транспіляція
Далі транспілюємо схеми для QPU. Ти порівняєш продуктивність транспілятора зі значенням optimization_level рівним 0 (найнижчий) і 3 (найвищий). Найнижчий рівень оптимізації робить лише мінімально необхідне для запуску схеми на пристрої: відображає кубіти схеми на кубіти пристрою та додає вентилі SWAP для виконання всіх двокубітних операцій. Найвищий рівень оптимізації є значно розумнішим і використовує безліч прийомів для зменшення загальної кількості вентилів. Оскільки багатокубітні вентилі мають високий рівень помилок, а кубіти декогерують з часом, коротші схеми повинні давати кращі результати.
У цьому прикладі використовується апаратне забезпечення IBM Quantum®, але ти можеш спробувати будь-який QPU, сумісний з Qiskit. Твої результати можуть відрізнятися.
Наступна комірка транспілює qc для обох значень optimization_level, виводить кількість двокубітних вентилів і додає транспільовані схеми до списку. Деякі алгоритми транспілятора є рандомізованими, тому задається зерно для відтворюваності результатів.
# Use IBM Quantum Compute Service to run jobs on hardware
from qiskit_ibm_runtime import (
    QiskitRuntimeService,
    SamplerV2 as Sampler,
)
# Select the backend with the fewest number of jobs in the queue
service = QiskitRuntimeService()
backend = service.least_busy(
    operational=True, simulator=False, min_num_qubits=127
)
backend.name
'ibm_fez'
# Need to add measurements to the circuit
qc.measure_all()

# Find the correct two-qubit gate
twoQ_gates = set(["ecr", "cz", "cx"])
for gate in backend.basis_gates:
    if gate in twoQ_gates:
        twoQ_gate = gate

circuits = []
for optimization_level in [0, 3]:
    pm = generate_preset_pass_manager(
        optimization_level, backend=backend, seed_transpiler=0
    )
    t_qc = pm.run(qc)
    print(
        f"Two-qubit gates (optimization_level={optimization_level}): ",
        t_qc.count_ops()[twoQ_gate],
    )
    circuits.append(t_qc)
Two-qubit gates (optimization_level=0):  21
Two-qubit gates (optimization_level=3):  12
Оскільки вентилі CNOT зазвичай мають високий рівень помилок, схема, транспільована з optimization_level=3, повинна працювати значно краще.
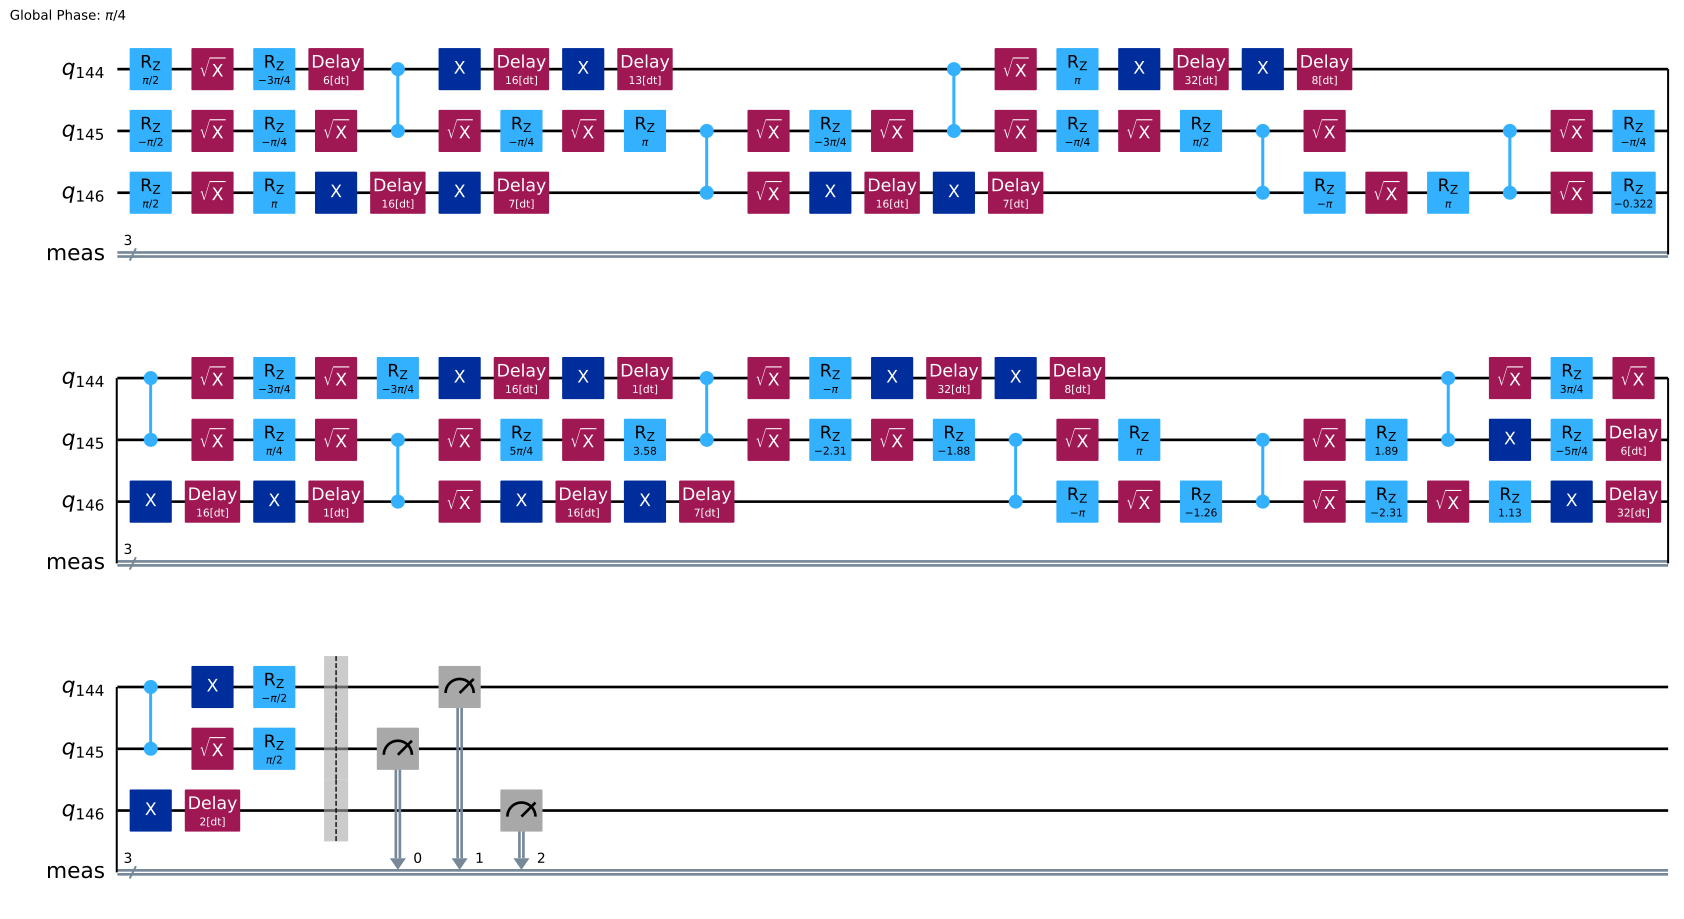
Ще один спосіб покращити продуктивність — динамічне роз'єднання: застосування послідовності вентилів до кубітів, що простоюють. Це компенсує частину небажаних взаємодій з навколишнім середовищем. Наступна комірка додає динамічне роз'єднання до схеми, транспільованої з optimization_level=3, і включає її до списку.
from qiskit_ibm_runtime.transpiler.passes.scheduling import (
    ASAPScheduleAnalysis,
    PadDynamicalDecoupling,
)

# Get gate durations so the transpiler knows how long each operation takes
durations = backend.target.durations()

# This is the sequence we'll apply to idling qubits
dd_sequence = [XGate(), XGate()]

# Run scheduling and dynamic decoupling passes on circuit
pm = PassManager(
    [
        ASAPScheduleAnalysis(durations),
        PadDynamicalDecoupling(durations, dd_sequence),
    ]
)
circ_dd = pm.run(circuits[1])

# Add this new circuit to our list
circuits.append(circ_dd)
circ_dd.draw(output="mpl", style="iqp", idle_wires=False)
Виконання схеми
На цьому етапі у тебе є список схем, транспільованих з різними налаштуваннями. Далі запусти ці схеми за допомогою примітива Sampler і збережи результати в result.
sampler = Sampler(backend)
job = sampler.run(
    [(circuit) for circuit in circuits],  # sample all three circuits
    shots=8000,
)
result = job.result()
Перегляд результатів
Нарешті, побудуй графіки результатів, отриманих на пристрої, і порівняй їх з ідеальним розподілом. Видно, що результати з optimization_level=3 ближчі до ідеального розподілу завдяки меншій кількості вентилів, а optimization_level=3 + dd — ще ближчі завдяки динамічному роз'єднанню.
binary_prob = [
    {
        k: v / res.data.meas.num_shots
        for k, v in res.data.meas.get_counts().items()
    }
    for res in result
]
plot_histogram(
    binary_prob + [ideal_distribution],
    bar_labels=False,
    legend=[
        "optimization_level=0",
        "optimization_level=3",
        "optimization_level=3 + dd",
        "ideal distribution",
    ],
)
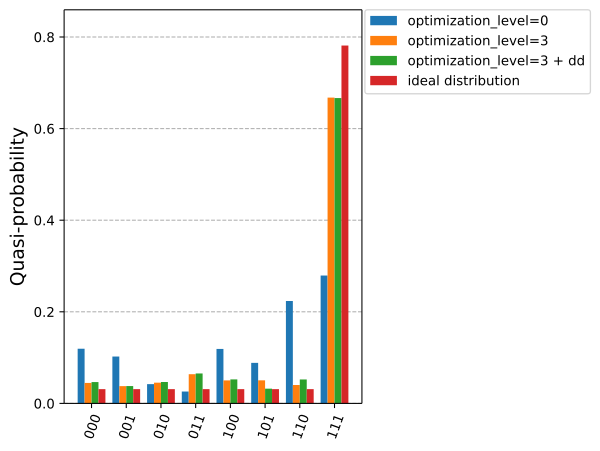
Ти можеш підтвердити це, обчисливши вірність Гелінгера між кожним набором результатів та ідеальним розподілом (чим вище, тим краще; 1 — ідеальна вірність).
for prob in binary_prob:
    print(f"{hellinger_fidelity(prob, ideal_distribution):.3f}")
0.717
0.982
0.981
Наступні кроки
-
Ознайомся з розширеними ресурсами з транспіляції, зокрема:
-
Переглянь доступні навчальні посібники.