Optimization Solver: функція Qiskit від Q-CTRL Fire Opal
Дивись довідник API
Qiskit Functions — це експериментальна функція, доступна лише користувачам IBM Quantum® Premium Plan, Flex Plan та On-Prem (через IBM Quantum Platform API) Plan. Вона перебуває у статусі попереднього релізу та може змінюватись.
Package versions
Код на цій сторінці розроблено з урахуванням таких вимог. Рекомендуємо використовувати ці версії або новіші.
qiskit-ibm-runtime~=0.47.0
sympy~=1.14.0
Огляд
За допомогою Fire Opal Optimization Solver ти можеш розв'язувати задачі оптимізації утилітарного масштабу на квантовому залізі без потреби в квантовій експертизі. Просто введи визначення задачі на високому рівні — і Solver зробить усе інше. Весь робочий процес є шумостійким і використовує Fire Opal Performance Management «під капотом». Solver стабільно надає точні рішення для класично складних задач навіть у повному масштабі на найбільших QPU від IBM®.
Solver є гнучким і може розв'язувати комбінаторні задачі оптимізації, визначені як цільові функції або довільні графи. Задачі не потрібно відображати на топологію пристрою. Розв'язуються як необмежені, так і обмежені задачі, з обмеженнями, що застосовуються як жорсткі обмеження Хеммінгової ваги 1, а не як штрафні терміни. Приклади, наведені в цьому посібнику, демонструють, як розв'язати необмежену та обмежену задачу оптимізації утилітарного масштабу, використовуючи різні типи вхідних даних для Solver. Перший приклад охоплює задачу max-cut на 156-вузловому 3-регулярному графі, тоді як другий приклад розв'язує задачу розбиття графа на 50 вузлах, визначену через цільову функцію.
Щоб отримати доступ до Optimization Solver, звернись до Q-CTRL.
Опис функції
Solver повністю оптимізує та автоматизує весь алгоритм — від придушення помилок на рівні заліза до ефективного відображення задачі та замкненої класичної оптимізації. «За лаштунками» конвеєр Solver зменшує помилки на кожному етапі, забезпечуючи підвищену продуктивність, необхідну для реального масштабування. Базовий робочий процес натхненний алгоритмом квантової наближеної оптимізації (QAOA) — гібридним квантово-класичним алгоритмом. Детальний опис повного робочого процесу Optimization Solver наведено в опублікованій статті.
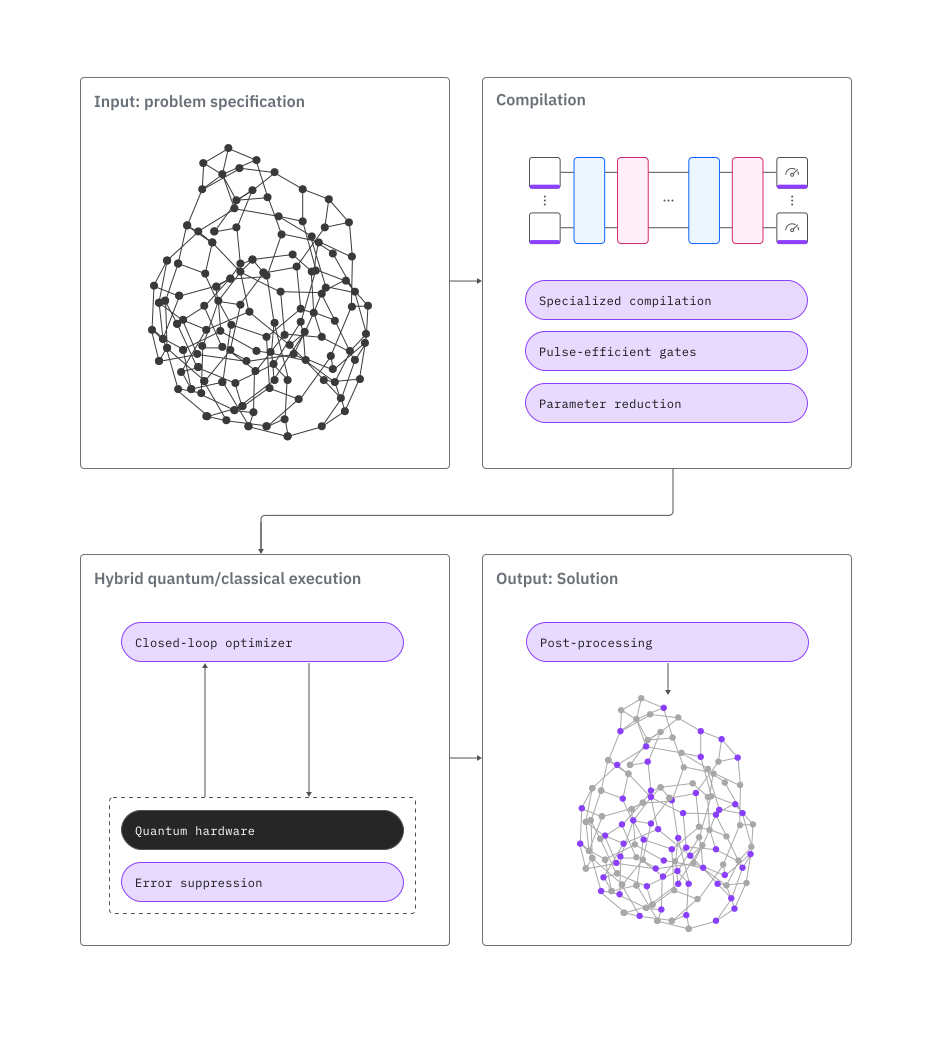
Щоб розв'язати загальну задачу за допомогою Optimization Solver:
- Визнач свою задачу як цільову функцію, граф або
SparsePauliOpспінового ланцюжка. - Підключись до функції через Qiskit Functions Catalog.
- Запусти задачу на Solver і отримай результати.
Підтримувані формати задач
-
Представлення цільової функції у вигляді поліноміального виразу. В ідеалі — створений у Python на основі існуючого об'єкта SymPy Poly та відформатований у рядок за допомогою sympy.srepr.
-
Графове представлення конкретного типу задачі. Граф слід створювати за допомогою бібліотеки networkx у Python. Потім його слід перетворити на рядок за допомогою функції networkx
nx.readwrite.json_graph.adjacency_data. -
Представлення задачі у вигляді спінового ланцюжка. Спіновий ланцюжок має бути представлений як об'єкт
SparsePauliOp; детальніше — у документації.
Якщо ти хочеш використовувати бекенд, який ця функція наразі не підтримує, звернись до Q-CTRL, щоб додати підтримку.
Бенчмарки
Продуктивність може залежати як від конкретного екземпляра задачі, так і від подальших етапів обробки. У деяких випадках класичні та квантово згенеровані вибірки можуть досягати подібної кінцевої якості розв'язку після еквівалентної постобробки. Тому оцінювання має враховувати весь робочий процес оптимізації.
Опубліковані результати бенчмаркінгу показують, що Solver успішно розв'язує задачі на понад 120 кубітах, навіть перевершуючи раніше опубліковані результати на пристроях квантового відпалу та пастки іонів. Наступні метрики бенчмарку дають приблизне уявлення про точність і масштабування типів задач на основі кількох прикладів. Фактичні метрики можуть відрізнятись залежно від різних характеристик задачі, таких як кількість доданків у цільовій функції (щільність) та їхня локальність, кількість змінних і порядок полінома.
«Кількість кубітів», що вказана, не є жорстким обмеженням, а лише приблизними порогами, при яких можна очікувати надзвичайно стабільної точності рішення. Задачі більшого розміру вже були успішно розв'язані, і тестування за межами цих порогів заохочується.
Довільне з'єднання кубітів підтримується для всіх типів задач.
| Тип задачі | Кількість кубітів | Приклад | Точність | Загальний час (с) | Використання Runtime (с) | Кількість ітерацій |
|---|---|---|---|---|---|---|
| Розріджено-зв'язані квадратичні задачі | 156 | 3-регулярний max-cut | 100% | 1764 | 293 | 16 |
| Бінарна оптимізація вищого порядку | 156 | Ізингова модель спінового скла | 100% | 1461 | 272 | 16 |
| Щільно-зв'язані квадратичні задачі | 50 | Повністю-зв'язаний max-cut | 100% | 1758 | 268 | 12 |
| Обмежена задача з жорсткими обмеженнями | 50 | Розбиття графа із щільністю ребер 8% | 100% | 1074 | 215 | 10 |
Початок роботи
Спочатку пройди автентифікацію за допомогою свого API-ключа IBM Quantum. Потім вибери функцію Qiskit наступним чином. (Цей фрагмент передбачає, що ти вже зберіг свій обліковий запис у локальному середовищі.)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"networkx": "networkx", "numpy": "numpy", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "sympy": "sympy"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(qunova/hivqe-chemistry),
 QiskitFunction(global-data-quantum/quantum-portfolio-optimizer),
 QiskitFunction(algorithmiq/tem),
 QiskitFunction(qedma/qesem),
 QiskitFunction(multiverse/singularity),
 QiskitFunction(ibm/circuit-function),
 QiskitFunction(q-ctrl/optimization-solver),
 QiskitFunction(colibritd/quick-pde),
 QiskitFunction(q-ctrl/performance-management),
 QiskitFunction(kipu-quantum/iskay-quantum-optimizer)]
# Access Function
solver = catalog.load("q-ctrl/optimization-solver")
Приклад: необмежена оптимізація
Запусти задачу максимального розрізу (Max-Cut). Наступний приклад демонструє можливості Solver на задачі Max-Cut на 156-вузловому, 3-регулярному незваженому графі, але ти також можеш розв'язувати задачі на зважених графах.
Окрім qiskit-ibm-catalog, для виконання цього прикладу тобі знадобляться такі пакети: networkx і numpy. Ти можеш встановити їх, розкоментувавши наступну комірку, якщо запускаєш цей приклад у ноутбуці з ядром IPython.
# %pip install networkx numpy
1. Визнач задачу
Ти можеш запустити задачу Max-Cut, визначивши задачу у вигляді графа та вказавши problem_type='maxcut'.
import networkx as nx
import numpy as np

# Generate a random graph with 156 nodes
maxcut_graph = nx.random_regular_graph(d=3, n=156, seed=8)
# Optionally, visualize the graph
nx.draw_networkx(
    maxcut_graph, nx.kamada_kawai_layout(maxcut_graph), node_size=100
)
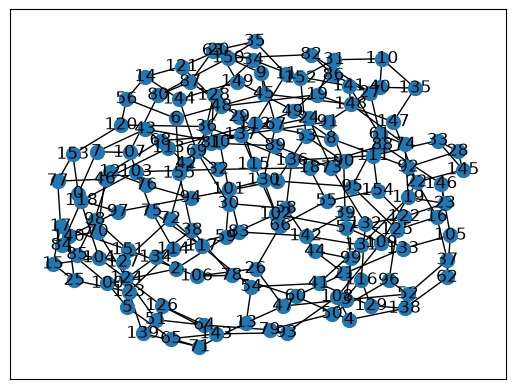
Solver приймає рядок як вхідне визначення задачі.
# Convert graph to string
problem_as_str = nx.readwrite.json_graph.adjacency_data(maxcut_graph)
2. Запусти задачу
При використанні графового методу вводу вкажи тип задачі.
# This cell is hidden from users
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend_name = service.least_busy(n_qubits=156).name
# Solve the problem
maxcut_job = solver.run(
    problem=problem_as_str,
    problem_type="maxcut",
    backend_name=backend_name,  # E.g. "ibm_fez"
)
Перевір статус робочого навантаження своєї функції Qiskit або отримай результати наступним чином:
# Print the ID so you can use it later, if necessary
print(maxcut_job.job_id)

# Get job status
print(maxcut_job.status())
34b53970-d95a-4e24-8763-fc6f3d112843
QUEUED
3. Отримай результат
Отримай оптимальне значення розрізу зі словника результатів.
variables_to_bitstring_index_map, який допомагає перевірити порядок.# Poll for results
maxcut_result = maxcut_job.result()
# Take the absolute value of the solution since the cost function is minimized
qctrl_maxcut = abs(maxcut_result["solution_bitstring_cost"])
# Print the optimal cut value found by the Optimization Solver
print(f"Optimal cut value: {qctrl_maxcut}")
Optimal cut value: 210.0
Ти можеш перевірити точність результату, розв'язавши задачу класично за допомогою відкритих солверів, таких як PuLP, якщо граф не є щільно зв'язаним. Для задач із високою щільністю може знадобитись використання просунутих класичних солверів для підтвердження рішення.
Приклад: обмежена оптимізація
Попередній приклад max-cut — це поширена задача квадратичної безумовної бінарної оптимізації. Optimization Solver від Q-CTRL також може розв'язувати задачі умовної оптимізації, передаючи жорсткі обмеження безпосередньо до Solver через вхід constraint, замість того щоб кодувати їх як штрафні члени в цільовій функції. Наразі Solver підтримує обмеження ваги Гемінга 1: кожне обмеження визначає групу змінних, у якій рівно одна змінна має дорівнювати 1, а решта — 0.
Наступний приклад демонструє, як побудувати цільову функцію та набір жорстких обмежень для задачі умовної оптимізації — розбиття графа, призначаючи кожен вузол графа рівно одній із кількох груп, мінімізуючи при цьому загальну вагу ребер, чиї кінцеві точки опиняються в одній групі.
Окрім пакетів qiskit-ibm-catalog і qiskit, для виконання цього прикладу тобі також знадобляться такі пакети: numpy, networkx і sympy. Ти можеш встановити їх, розкоментувавши наступну комірку, якщо запускаєш цей приклад у ноутбуці з ядром IPython.
# %pip install numpy networkx sympy
1. Визнач задачу
Визнач випадкову задачу розбиття графа, згенерувавши граф із вузлами, що мають випадкові ваги.
import networkx as nx
from sympy import Symbol, Poly, srepr

# To change the weights, change the seed to any integer.
rng_seed = 18
_rng = np.random.default_rng(rng_seed)
node_count = 50
edge_probability = 0.08
graph = nx.erdos_renyi_graph(
    node_count, edge_probability, seed=rng_seed, directed=False
)

# add node weights
min_weight = -1.0
max_weight = 1.0
for i in graph.nodes:
    weight = (max_weight - min_weight) * _rng.random() + min_weight
    graph.add_node(i, weight=weight)

# Optionally, visualize the graph
nx.draw_networkx(graph, nx.kamada_kawai_layout(graph), node_size=200)
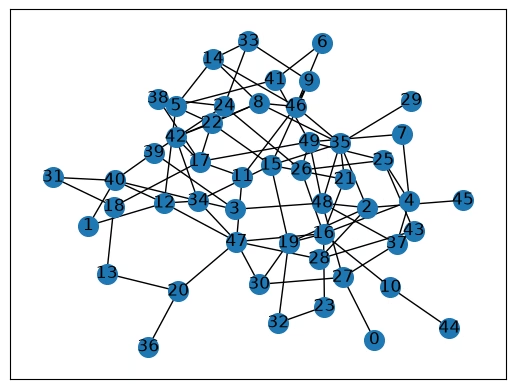
Стандартну модель оптимізації для зваженого розбиття графа можна сформулювати так. Розділи вузли графа на три групи , і нехай , якщо вузол призначено групі , і в іншому випадку. Мета — мінімізувати загальну вагу ребер, чиї кінцеві точки призначені одній групі, де вага ребра — це сумарна вага його двох кінцевих точок, :
# Construct the cost function.
group_count = 3
variables = [
    Symbol(f"n[{i},{g}]")
    for i in range(node_count)
    for g in range(group_count)
]
node_group_var = {
    (i, g): variables[i * group_count + g]
    for i in range(node_count)
    for g in range(group_count)
}
cost_function = Poly(0, *variables)

for i, j in graph.edges():
    edge_weight = graph.nodes[i]["weight"] + graph.nodes[j]["weight"]
    for g in range(group_count):
        cost_function += (
            edge_weight * node_group_var[(i, g)] * node_group_var[(j, g)]
        )
Кожен вузол має бути призначений рівно одній із трьох груп. Це обмеження ваги Гемінга 1: для кожного вузла рівно одна з має дорівнювати 1, а решта — 0:
Замість того щоб кодувати цю вимогу як штрафний член у цільовій функції, передай її безпосередньо до Solver як жорстке обмеження за допомогою входу constraint.
# Build the hard constraint: exactly one group per node.
constraint_dict = {
    str(tuple(f"n[{i},{g}]" for g in range(group_count))): 1
    for i in range(node_count)
}
print(f"Problem constraints: {constraint_dict}")
Problem constraints: {"('n[0,0]', 'n[0,1]', 'n[0,2]')": 1, "('n[1,0]', 'n[1,1]', 'n[1,2]')": 1, "('n[2,0]', 'n[2,1]', 'n[2,2]')": 1, "('n[3,0]', 'n[3,1]', 'n[3,2]')": 1, "('n[4,0]', 'n[4,1]', 'n[4,2]')": 1, "('n[5,0]', 'n[5,1]', 'n[5,2]')": 1, "('n[6,0]', 'n[6,1]', 'n[6,2]')": 1, "('n[7,0]', 'n[7,1]', 'n[7,2]')": 1, "('n[8,0]', 'n[8,1]', 'n[8,2]')": 1, "('n[9,0]', 'n[9,1]', 'n[9,2]')": 1, "('n[10,0]', 'n[10,1]', 'n[10,2]')": 1, "('n[11,0]', 'n[11,1]', 'n[11,2]')": 1, "('n[12,0]', 'n[12,1]', 'n[12,2]')": 1, "('n[13,0]', 'n[13,1]', 'n[13,2]')": 1, "('n[14,0]', 'n[14,1]', 'n[14,2]')": 1, "('n[15,0]', 'n[15,1]', 'n[15,2]')": 1, "('n[16,0]', 'n[16,1]', 'n[16,2]')": 1, "('n[17,0]', 'n[17,1]', 'n[17,2]')": 1, "('n[18,0]', 'n[18,1]', 'n[18,2]')": 1, "('n[19,0]', 'n[19,1]', 'n[19,2]')": 1, "('n[20,0]', 'n[20,1]', 'n[20,2]')": 1, "('n[21,0]', 'n[21,1]', 'n[21,2]')": 1, "('n[22,0]', 'n[22,1]', 'n[22,2]')": 1, "('n[23,0]', 'n[23,1]', 'n[23,2]')": 1, "('n[24,0]', 'n[24,1]', 'n[24,2]')": 1, "('n[25,0]', 'n[25,1]', 'n[25,2]')": 1, "('n[26,0]', 'n[26,1]', 'n[26,2]')": 1, "('n[27,0]', 'n[27,1]', 'n[27,2]')": 1, "('n[28,0]', 'n[28,1]', 'n[28,2]')": 1, "('n[29,0]', 'n[29,1]', 'n[29,2]')": 1, "('n[30,0]', 'n[30,1]', 'n[30,2]')": 1, "('n[31,0]', 'n[31,1]', 'n[31,2]')": 1, "('n[32,0]', 'n[32,1]', 'n[32,2]')": 1, "('n[33,0]', 'n[33,1]', 'n[33,2]')": 1, "('n[34,0]', 'n[34,1]', 'n[34,2]')": 1, "('n[35,0]', 'n[35,1]', 'n[35,2]')": 1, "('n[36,0]', 'n[36,1]', 'n[36,2]')": 1, "('n[37,0]', 'n[37,1]', 'n[37,2]')": 1, "('n[38,0]', 'n[38,1]', 'n[38,2]')": 1, "('n[39,0]', 'n[39,1]', 'n[39,2]')": 1, "('n[40,0]', 'n[40,1]', 'n[40,2]')": 1, "('n[41,0]', 'n[41,1]', 'n[41,2]')": 1, "('n[42,0]', 'n[42,1]', 'n[42,2]')": 1, "('n[43,0]', 'n[43,1]', 'n[43,2]')": 1, "('n[44,0]', 'n[44,1]', 'n[44,2]')": 1, "('n[45,0]', 'n[45,1]', 'n[45,2]')": 1, "('n[46,0]', 'n[46,1]', 'n[46,2]')": 1, "('n[47,0]', 'n[47,1]', 'n[47,2]')": 1, "('n[48,0]', 'n[48,1]', 'n[48,2]')": 1, "('n[49,0]', 'n[49,1]', 'n[49,2]')": 1}
Тобі не потрібно додавати кожну змінну до constraint. Будь-яка змінна, не включена до словника, залишається необмеженою, тож ти можеш поєднувати жорстко обмежені групи змінних із вільними змінними в одній задачі.
2. Запусти задачу
# Solve the problem
partition_job = solver.run(
    problem=srepr(cost_function),
    constraint=constraint_dict,
    backend_name="ibm_marrakesh",  # E.g. "ibm_marrakesh"
)
Перевір статус робочого навантаження своєї функції Qiskit або отримай результати наступним чином:
# Print the ID so you can use it later, if necessary
print(partition_job.job_id)

# Get job status
print(partition_job.status())
b8085944-f313-444e-be39-ea61b1b47ebd
QUEUED
3. Отримай результат
Отримай розв'язок і проаналізуй результати. Вартість розв'язку відображає загальну вагу ребер, чиї кінцеві точки опинилися в одній групі, тож нижча вартість означає краще розбиття графа.
partition_result = partition_job.result()
qctrl_cost = partition_result["solution_bitstring_cost"]
solution_bitstring = partition_result["solution_bitstring"]

# Print results
print(f"Total weight of same-group edges: {qctrl_cost}")
print(f"Solution bitstring: {solution_bitstring}")
Total weight of same-group edges: -36.5539
Solution bitstring: 100100100100100001100100100100100100100100100100100001010100010100100100100010001001100100100001100001100001010001001010100100100100100010100100100100
Підтримка
З будь-якими запитаннями або проблемами звернись до Q-CTRL.
Журнал змін
-
2026-08-10: Додано підтримку жорстких обмежень (ваги Гемінга 1) через вхід
constraint, і оновлено приклад умовної оптимізації, щоб використовувати їх. -
2026-02-11: Тепер підтримується
ibm_miami
Наступні кроки
-
Запроси доступ до Q-CTRL Optimization Solver.
-
Відвідай довідник API для цієї функції Qiskit.
-
Спробуй підручник Розв'язання задач бінарної оптимізації вищого порядку за допомогою Optimization Solver від Q-CTRL.
-
Ознайомся з кейсом Mazda.
-
Ознайомся з кейсом Network Rail.
-
Ознайомся з кейсом Australian Army.
-
Ознайомся з кейсом Transport for New South Wales.