Оптимізація квантової схеми
Toshinari Itoko (21 червня 2024)
Завантажити PDF оригінальної лекції. Зверни увагу, що деякі фрагменти коду можуть бути застарілими, оскільки це статичні зображення.
Приблизний час роботи QPU для цього експерименту — 15 с.
(Примітка: деякі комірки частини 2 скопійовано з ноутбука «Qiskit Deep dive», написаного Matthew Treinish — супроводжувачем Qiskit)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
# !pip install 'qiskit[visualization]'
# !pip install qiskit_ibm_runtime qiskit_aer
# !pip install jupyter
# !pip install matplotlib pylatexenc pydot pillow
import qiskit

qiskit.__version__
'2.0.2'
import qiskit_ibm_runtime

qiskit_ibm_runtime.__version__
'0.40.1'
import qiskit_aer

qiskit_aer.__version__
'0.17.1'
1. Вступ
Цей урок розглядає кілька аспектів оптимізації схем у квантових обчисленнях. Зокрема, ми побачимо цінність оптимізації схем, використовуючи вбудовані в Qiskit налаштування оптимізації. Потім заглибимося трохи далі й розглянемо, що ти можеш зробити як експерт у своїй предметній галузі, щоб будувати схеми розумним способом. Нарешті, ми детально розглянемо, що відбувається під час транспіляції та як це допомагає нам оптимізувати наші схеми.
2. Оптимізація схем має значення
Спочатку порівняємо результати запуску схем підготовки 5-кубітного стану GHZ () з оптимізацією та без неї.
from qiskit.circuit import QuantumCircuit
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit.primitives import BackendSamplerV2 as Sampler
from qiskit_ibm_runtime.fake_provider import FakeBrisbane

backend = FakeBrisbane()
Спочатку скористаємося схемою GHZ, синтезованою наївним способом:
num_qubits = 5

ghz_circ = QuantumCircuit(num_qubits)
ghz_circ.h(0)
[ghz_circ.cx(0, i) for i in range(1, num_qubits)]
ghz_circ.measure_all()
ghz_circ.draw("mpl")

2.1 Рівень оптимізації
optimization_level має чотири варіанти, від 0 до 3. Чим вищий рівень оптимізації, тим більше обчислювальних зусиль витрачається на оптимізацію схеми. Рівень 0 не виконує жодної оптимізації і робить лише мінімум роботи, щоб схема могла виконуватися на обраному бекенді. Рівень 3 витрачає найбільше зусиль (і зазвичай часу виконання), щоб спробувати оптимізувати схему. Рівень 1 є типовим рівнем оптимізації.
Ми транспілюємо схему без оптимізації (optimization_level=0) та з оптимізацією (optimization_level=2).
Ми бачимо велику різницю в довжині транспільованих схем.
pm0 = generate_preset_pass_manager(
    optimization_level=0, backend=backend, seed_transpiler=777
)
pm2 = generate_preset_pass_manager(
    optimization_level=2, backend=backend, seed_transpiler=777
)
circ0 = pm0.run(ghz_circ)
circ2 = pm2.run(ghz_circ)
print("optimization_level=0:")
display(circ0.draw("mpl", idle_wires=False, fold=-1))
print("optimization_level=2:")
display(circ2.draw("mpl", idle_wires=False, fold=-1))
optimization_level=0:
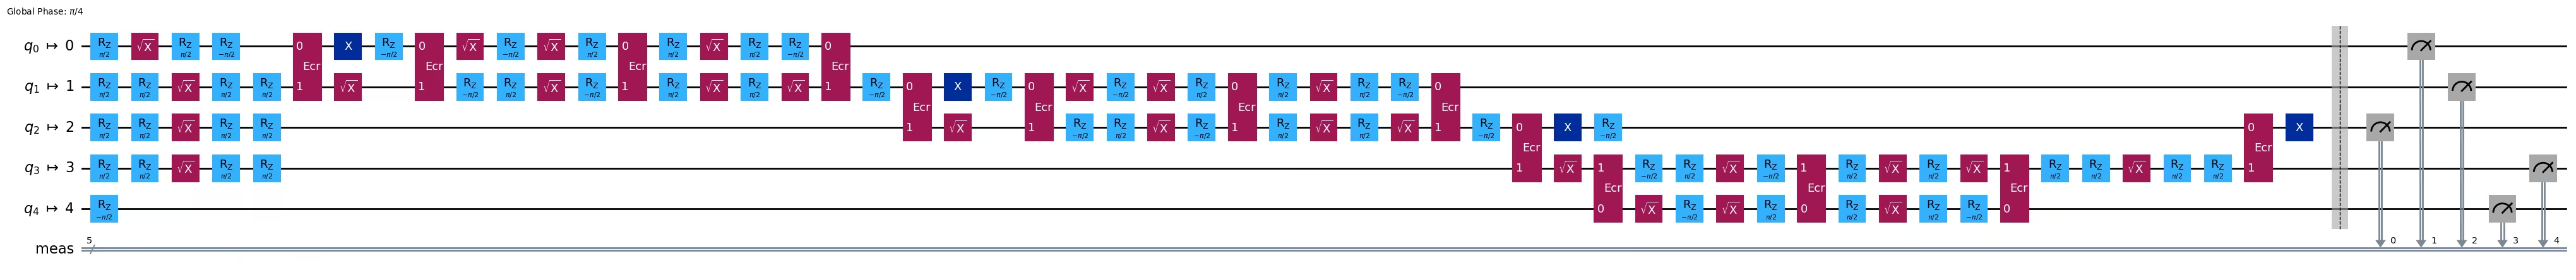
optimization_level=2:

2.2 Вправа
Спробуй також optimization_level=1 і порівняй отриману схему з двома наведеними вище. Зроби це, змінивши код вище.
Розв'язання:
pm1 = generate_preset_pass_manager(
    optimization_level=1, backend=backend, seed_transpiler=777
)
circ1 = pm1.run(ghz_circ)
print("optimization_level=1:")
display(circ1.draw("mpl", idle_wires=False, fold=-1))
optimization_level=1:

Запустимо на фейковому бекенді (зашумлена симуляція). Дивися Додаток 1 для того, як запустити на реальному бекенді.
# run the circuits on the fake backend (noisy simulator)
sampler = Sampler(backend=backend)
job = sampler.run([circ0, circ2], shots=10000)
print(f"Job ID: {job.job_id()}")
Job ID: 93a4ac70-e3ea-44ad-aea9-5045840c9076
# get results
result = job.result()
unoptimized_result = result[0].data.meas.get_counts()
optimized_result = result[1].data.meas.get_counts()
from qiskit.visualization import plot_histogram

# plot
sim_result = {"0" * 5: 0.5, "1" * 5: 0.5}
plot_histogram(
    [result for result in [sim_result, unoptimized_result, optimized_result]],
    bar_labels=False,
    legend=[
        "ideal",
        "no optimization",
        "with optimization",
    ],
)

3. Синтез схем має значення
Далі ми порівняємо результати виконання двох по-різному синтезованих схем підготовки 5-кубітного стану GHZ ().
# Original GHZ circuit (naive synthesis)
ghz_circ.draw("mpl")
# A cleverly-synthesized GHZ circuit
ghz_circ2 = QuantumCircuit(5)
ghz_circ2.h(2)
ghz_circ2.cx(2, 1)
ghz_circ2.cx(2, 3)
ghz_circ2.cx(1, 0)
ghz_circ2.cx(3, 4)
ghz_circ2.measure_all()
ghz_circ2.draw("mpl")

# transpile both with the same optimization level 2
circ_org = pm2.run(ghz_circ)
circ_new = pm2.run(ghz_circ2)
print("original synthesis:")
display(circ_org.draw("mpl", idle_wires=False, fold=-1))
print("new synthesis:")
display(circ_new.draw("mpl", idle_wires=False, fold=-1))
original synthesis:
new synthesis:

Новий синтез дає меншу глибину схеми. Чому?
Це пояснюється тим, що нову схему можна розмістити на лінійно пов'язаних кубітах, а отже, і на графі зв'язності типу «важкий гексагон» процесора IBM® Brisbane, тоді як оригінальна схема вимагає зіркоподібної зв'язності (вузол ступеня 4) і тому не може бути розміщена на графі зв'язності «важкий гексагон», де вузли мають ступінь не більше 3. Внаслідок цього оригінальна схема потребує маршрутизації кубітів, яка додає SWAP Gate, збільшуючи кількість Gate.
Те, що ми зробили в новій схемі, можна розглядати як ручний синтез схеми з урахуванням обмежень зв'язності. Іншими словами: ручне вирішення синтезу схеми та відображення схеми одночасно.
# run the circuits
sampler = Sampler(backend=backend)
job = sampler.run([circ_org, circ_new], shots=10000)
print(f"Job ID: {job.job_id()}")
Job ID: 19d635b0-4d8b-44c2-a76e-49e4b9078b1b
# get results
result = job.result()
synthesis_org_result = result[0].data.meas.get_counts()
synthesis_new_result = result[1].data.meas.get_counts()
# plot
sim_result = {"0" * 5: 0.5, "1" * 5: 0.5}
plot_histogram(
    [
        result
        for result in [
            sim_result,
            unoptimized_result,
            synthesis_org_result,
            synthesis_new_result,
        ]
    ],
    bar_labels=False,
    legend=[
        "ideal",
        "no optimization",
        "synthesis_org",
        "synthesis_new",
    ],
)

Загалом синтез схеми залежить від застосування, і програмному забезпеченню занадто складно охопити всі можливі застосування. Транспілятор Qiskit не має функцій синтезу схеми підготовки стану GHZ. У такому випадку варто розглянути ручний синтез схеми, як показано вище. У цьому розділі ми детально розглянемо, як працює транспілятор Qiskit, на прикладі наступної навчальної схеми.
# Build a toy example circuit
from math import pi
import itertools
from qiskit.circuit import QuantumCircuit
from qiskit.circuit.library import excitation_preserving

circuit = QuantumCircuit(4, name="Example circuit")
circuit.append(excitation_preserving(4, reps=1, flatten=True), range(4))
circuit.measure_all()

value_cycle = itertools.cycle([0, pi / 4, pi / 2, 3 * pi / 4, pi, 2 * pi])
circuit.assign_parameters(
    [x[1] for x in zip(range(len(circuit.parameters)), value_cycle)], inplace=True
)
circuit.draw("mpl")

3.1 Відображення повного процесу транспіляції Qiskit
Розглянемо проходи транспілятора (задачі) для optimization_level=1.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

# There is no need to read this entire image, but this outputs all the steps in the transpile() call
# for optimization level 1
pm = generate_preset_pass_manager(1, backend, seed_transpiler=42)
pm.draw()
Процес складається з шести етапів:
print(pm.stages)
('init', 'layout', 'routing', 'translation', 'optimization', 'scheduling')
3.2 Відображення окремого етапу
Спочатку відобразимо всі задачі (проходи транспілятора) етапу init.
pm.init.draw()
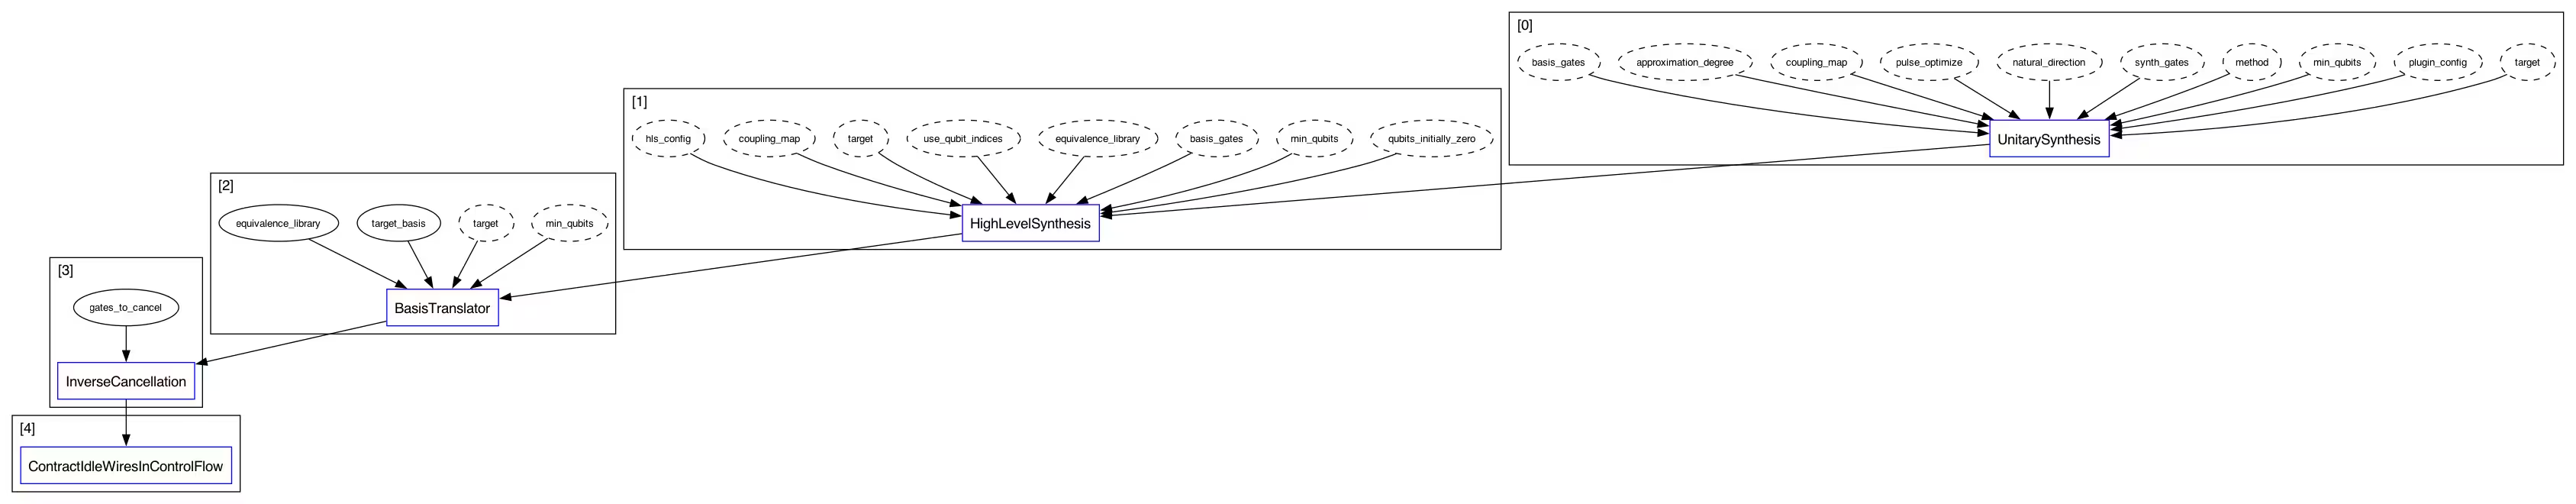
Можна запускати кожен окремий етап. Запустимо етап init для нашої схеми. Увімкнувши логування, ми зможемо побачити деталі виконання.
import logging

logger = logging.getLogger()
logger.setLevel("INFO")

init_out = pm.init.run(circuit)
init_out.draw("mpl", fold=-1)
INFO:qiskit.passmanager.base_tasks:Pass: UnitarySynthesis - 0.03576 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: HighLevelSynthesis - 0.16618 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: BasisTranslator - 0.07176 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: InverseCancellation - 0.27299 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: ContractIdleWiresInControlFlow - 0.00811 (ms)

3.3 Вправа
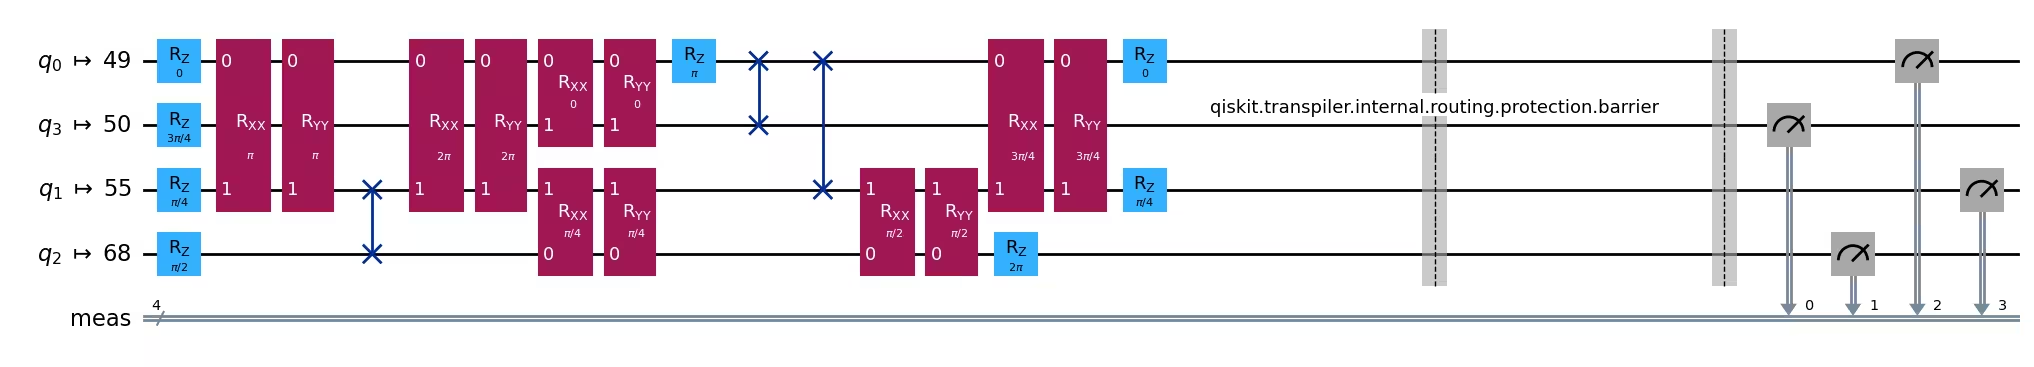
Відобрази проходи етапу layout і запусти цей етап для вихідної схеми етапу init (init_out), змінивши відповідні комірки вище.
Розв'язання:
display(pm.layout.draw())
layout_out = pm.layout.run(init_out)
layout_out.draw("mpl", idle_wires=False, fold=-1)
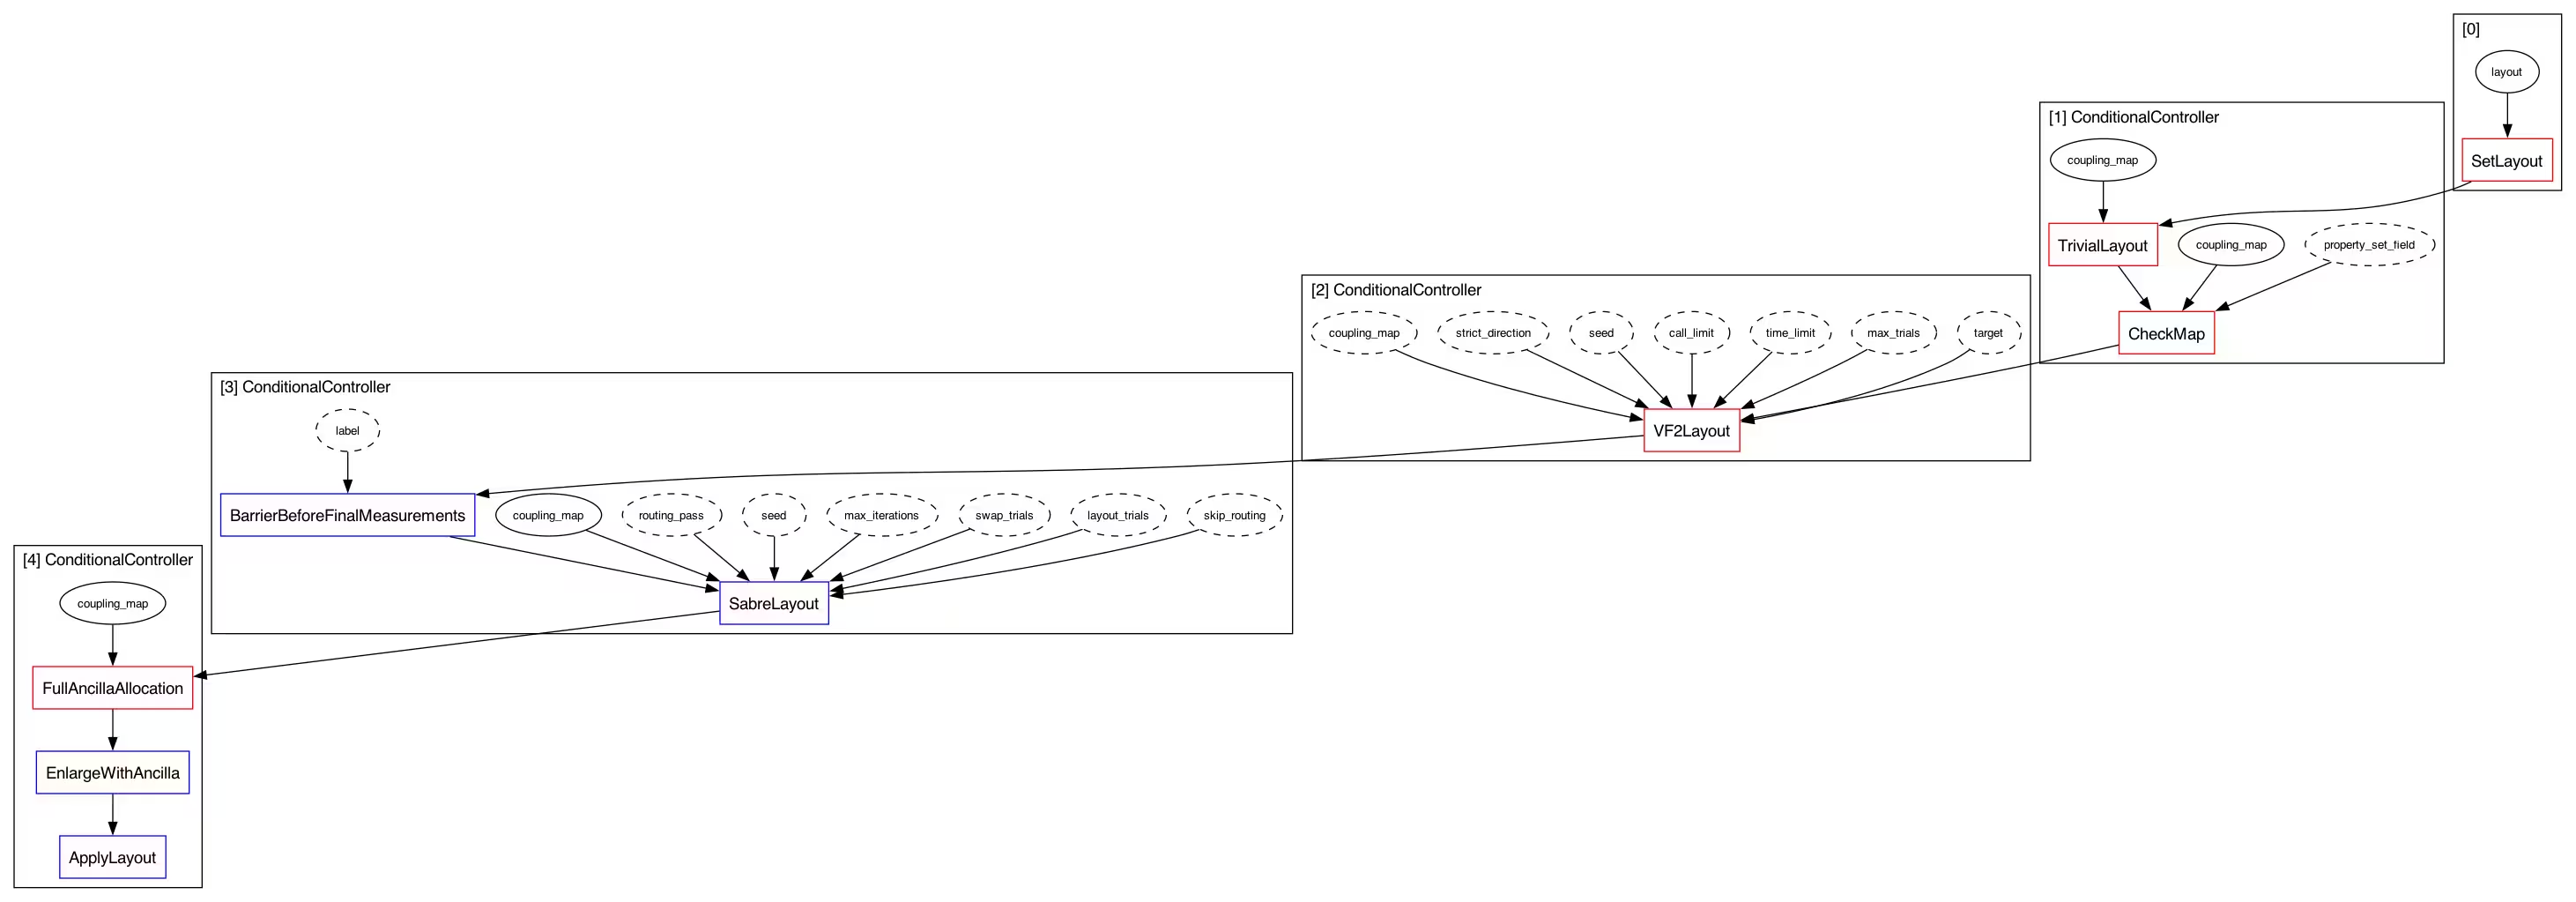
INFO:qiskit.passmanager.base_tasks:Pass: SetLayout - 0.01001 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: TrivialLayout - 0.07129 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: CheckMap - 0.08917 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: VF2Layout - 1.24431 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: BarrierBeforeFinalMeasurements - 0.02599 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: SabreLayout - 5.11169 (ms)
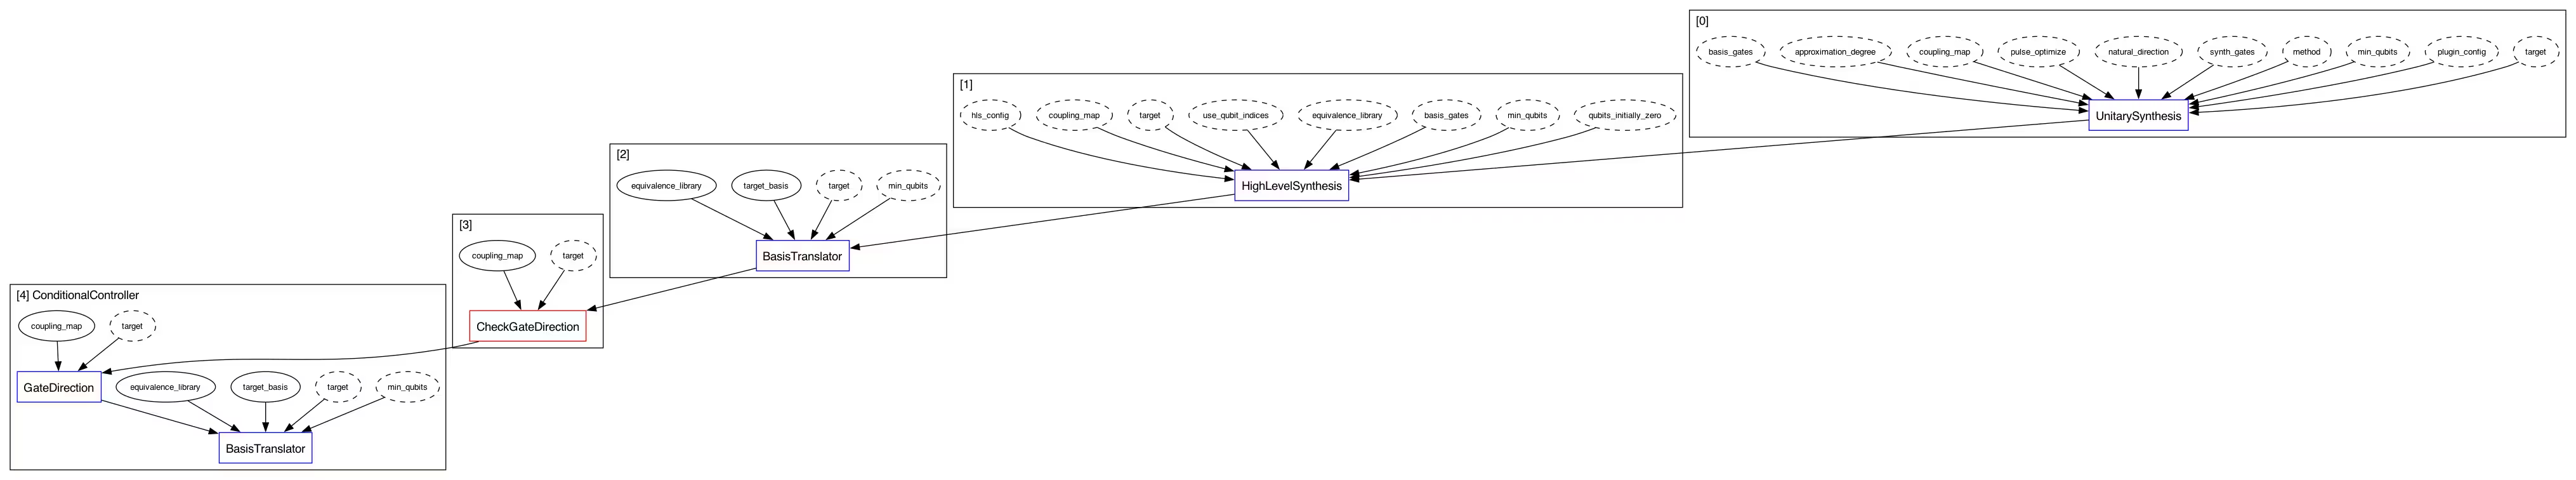
Зроби те саме для етапу translation.
Розв'язання:
display(pm.translation.draw())
basis_out = pm.translation.run(layout_out)
basis_out.draw("mpl", idle_wires=False, fold=-1)
INFO:qiskit.passmanager.base_tasks:Pass: UnitarySynthesis - 0.03386 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: HighLevelSynthesis - 0.02718 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: BasisTranslator - 2.64192 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: CheckGateDirection - 0.02217 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: GateDirection - 0.36502 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: BasisTranslator - 0.64778 (ms)

Примітка: окремі етапи не завжди можна запускати незалежно (оскільки деякі з них повинні передавати інформацію від одного попереднього етапу до наступного).
3.4 Стадія оптимізації
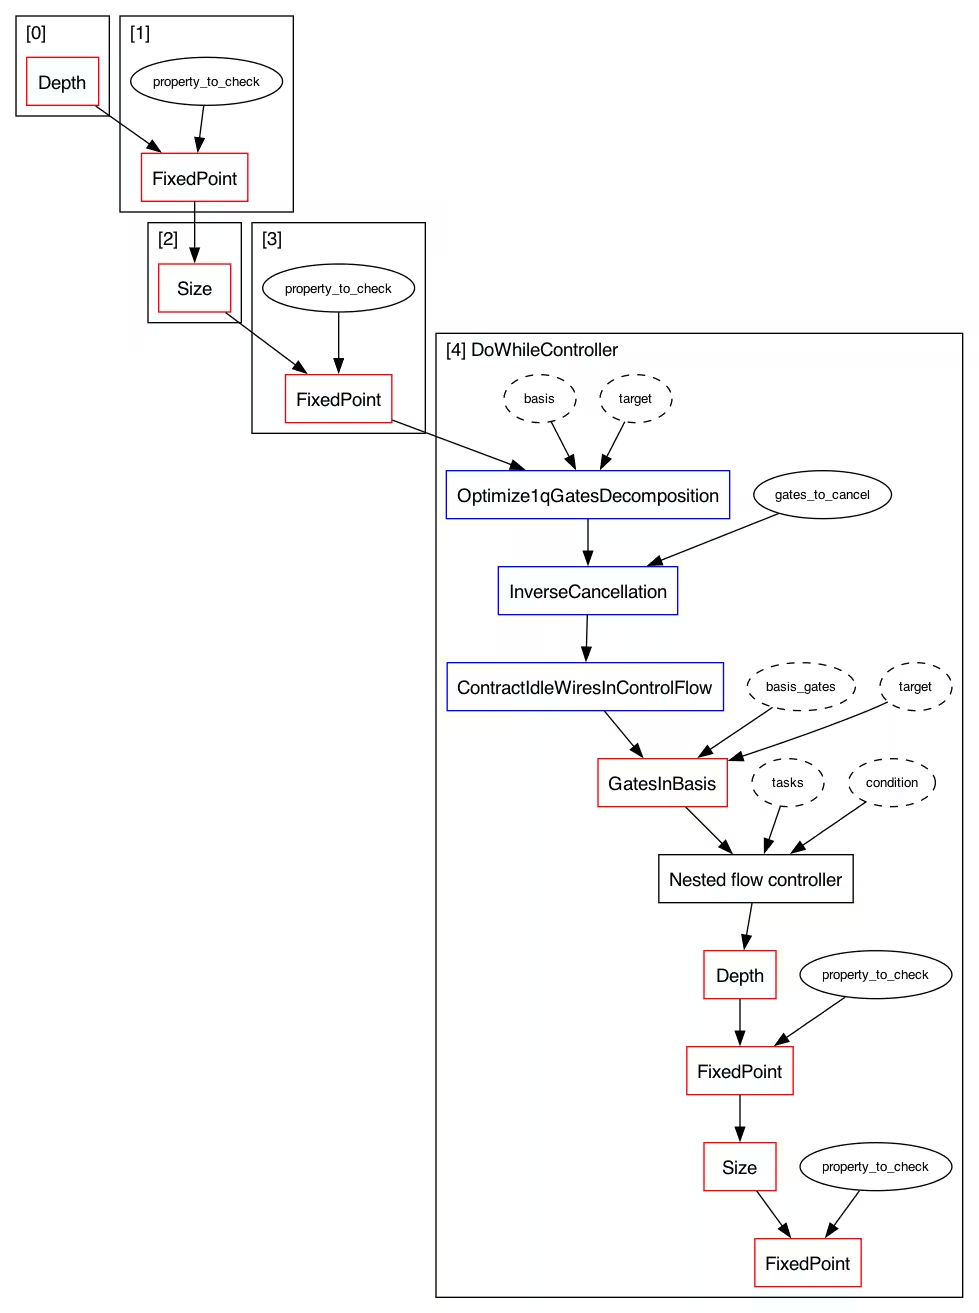
Остання стандартна стадія в конвеєрі — це оптимізація. Після того як Circuit вбудовано для цільового пристрою, він значно розширився. Здебільшого це пов'язано з неефективністю відношень еквівалентності під час трансляції базису та вставки SWAP. Стадія оптимізації намагається мінімізувати розмір і глибину Circuit. Вона виконує серію проходів у циклі do while, доки не досягне стабільного результату.
# pm.pre_optimization.draw()
pm.optimization.draw()
logger = logging.getLogger()
logger.setLevel("INFO")
opt_out = pm.optimization.run(basis_out)
INFO:qiskit.passmanager.base_tasks:Pass: Depth - 0.30112 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: FixedPoint - 0.03195 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: Size - 0.01216 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: FixedPoint - 0.01001 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: Optimize1qGatesDecomposition - 0.63729 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: InverseCancellation - 0.41723 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: ContractIdleWiresInControlFlow - 0.01192 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: GatesInBasis - 0.05484 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: Depth - 0.08583 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: FixedPoint - 0.20599 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: Size - 0.00787 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: FixedPoint - 0.00715 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: Optimize1qGatesDecomposition - 0.16809 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: InverseCancellation - 0.17190 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: ContractIdleWiresInControlFlow - 0.00691 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: GatesInBasis - 0.02408 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: Depth - 0.04935 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: FixedPoint - 0.00525 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: Size - 0.00620 (ms)
INFO:qiskit.passmanager.base_tasks:Pass: FixedPoint - 0.00286 (ms)
opt_out.draw("mpl", idle_wires=False, fold=-1)

4. Поглиблені приклади
4.1 Оптимізація двокубітних блоків за допомогою синтезу двокубітних унітарних матриць
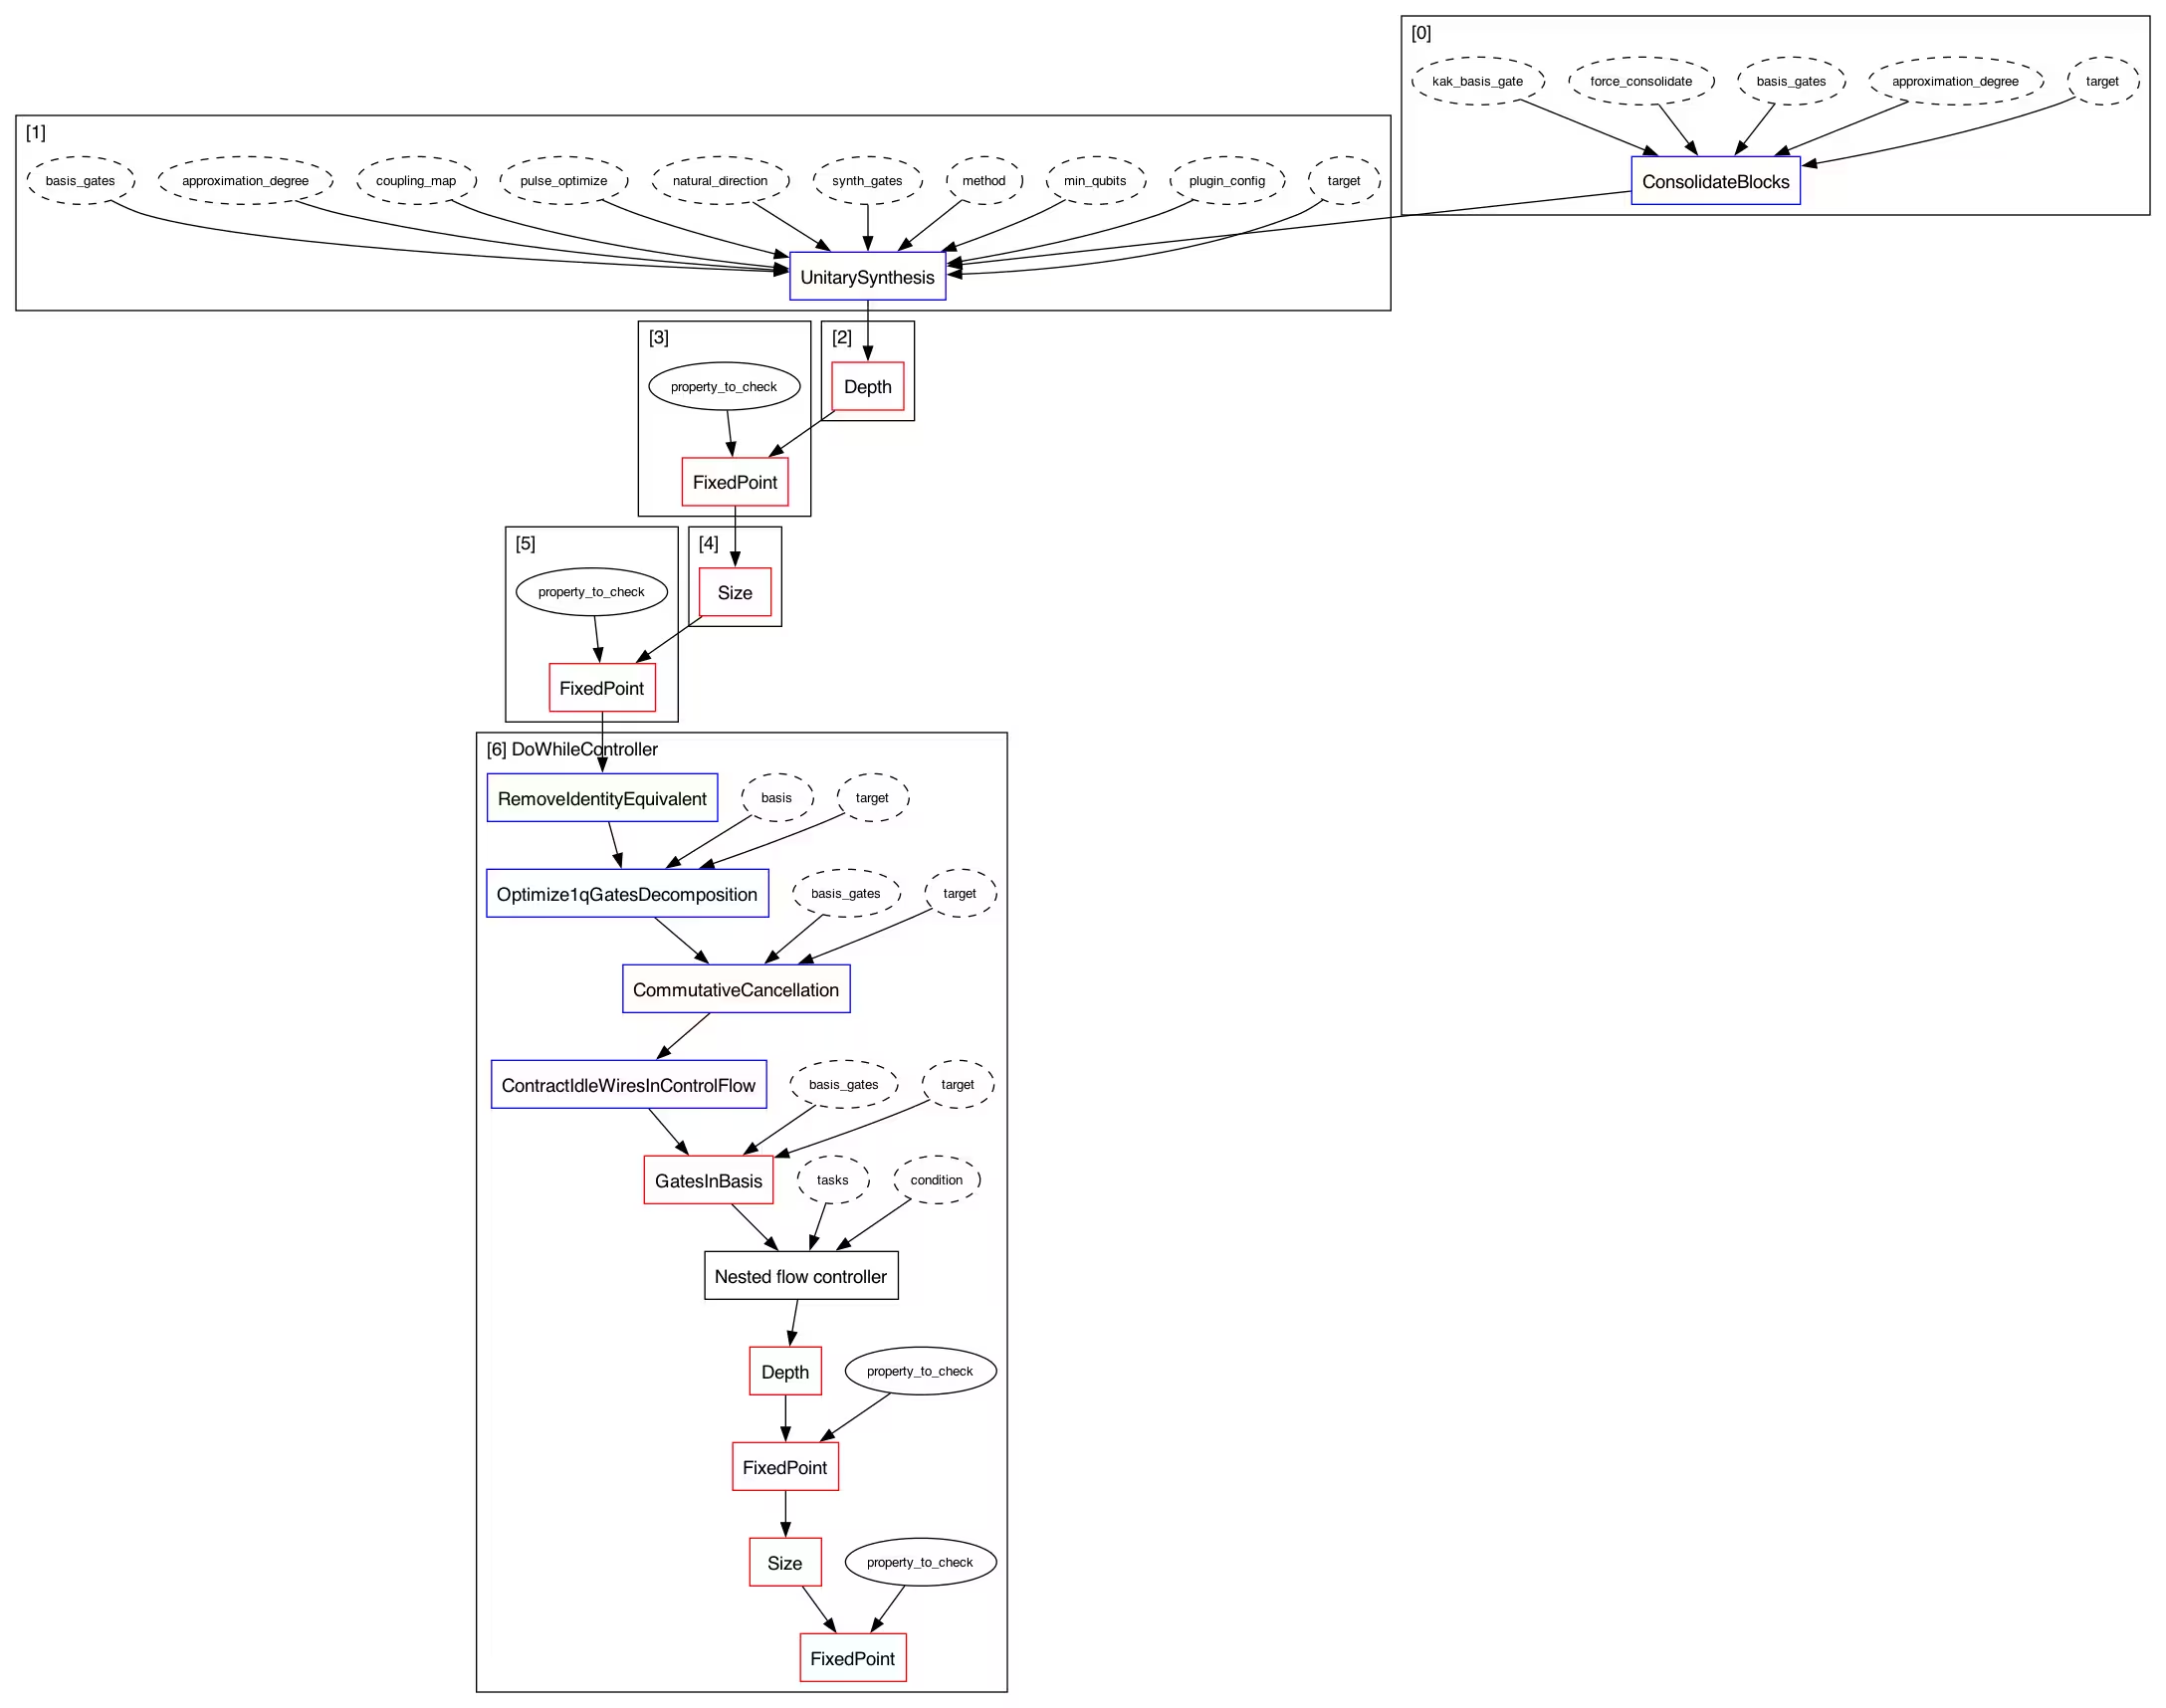
Для рівнів 2 і 3 передбачено додаткові проходи (Collect2qBlocks, ConsolidateBlocks, UnitarySynthesis) для глибшої оптимізації — а саме оптимізацію двокубітних блоків. (Порівняй потік стадії оптимізації для рівня 2 із показаним вище для рівня 1.)
Оптимізація двокубітних блоків складається з двох кроків: збирання та консолідація двокубітних блоків, а також синтез двокубітних унітарних матриць.
pm2 = generate_preset_pass_manager(2, backend, seed_transpiler=42)
pm2.optimization.draw()
from qiskit.transpiler import PassManager
from qiskit.transpiler.passes import (
    Collect2qBlocks,
    ConsolidateBlocks,
    UnitarySynthesis,
)

# Collect 2q blocks and consolidate to unitary when we expect that we can reduce the 2q gate count
# for that unitary
consolidate_pm = PassManager(
    [
        Collect2qBlocks(),
        ConsolidateBlocks(target=backend.target),
    ]
)
display(basis_out.draw("mpl", idle_wires=False, fold=-1))

consolidated = consolidate_pm.run(basis_out)
consolidated.draw("mpl", idle_wires=False, fold=-1)


# Synthesize unitaries
UnitarySynthesis(target=backend.target)(consolidated).draw(
    "mpl", idle_wires=False, fold=-1
)

logger.setLevel("WARNING")
У частині 2 ми побачили, що реальний потік квантового компілятора не такий простий — він складається з багатьох проходів (задач). Це здебільшого зумовлено вимогами програмної інженерії: забезпечити продуктивність для широкого спектра прикладних Circuit і підтримуваність програмного забезпечення. Transpiler Qiskit добре справляється з більшістю випадків, але якщо ти помітиш, що він не оптимізує твій Circuit належним чином, варто дослідити власну прикладну оптимізацію Circuit, як показано в частині 1. Технологія Transpiler розвивається — твій R&D-внесок вітається.
from qiskit.circuit import QuantumCircuit
from qiskit_ibm_runtime import QiskitRuntimeService, Sampler
service = QiskitRuntimeService()
backend = service.backend("ibm_brisbane")
sampler = Sampler(backend)
circ = QuantumCircuit(3)
circ.ccx(0, 1, 2)
circ.measure_all()
circ.draw("mpl")

sampler.run([circ]) # IBMInputValueError will be raised
4.2 Чому оптимізація Circuit має значення
Спочатку порівняємо результати запуску схем підготовки 5-кубітного стану GHZ () з оптимізацією та без неї.
from qiskit.circuit import QuantumCircuit
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit_ibm_runtime import QiskitRuntimeService, Sampler
service = QiskitRuntimeService()
# backend = service.backend('ibm_brisbane')
backend = service.least_busy(
    operational=True, simulator=False, min_num_qubits=127
)  # Eagle
backend
Спочатку скористаємося схемою GHZ, синтезованою наївним способом:
num_qubits = 5

ghz_circ = QuantumCircuit(num_qubits)
ghz_circ.h(0)
[ghz_circ.cx(0, i) for i in range(1, num_qubits)]
ghz_circ.measure_all()
ghz_circ.draw("mpl")
Ми транспілюємо схему без оптимізації (optimization_level=0) та з оптимізацією (optimization_level=2).
Як бачиш, є велика різниця в довжині транспільованих схем.
pm0 = generate_preset_pass_manager(
    optimization_level=0, backend=backend, seed_transpiler=777
)
pm2 = generate_preset_pass_manager(
    optimization_level=2, backend=backend, seed_transpiler=777
)
circ0 = pm0.run(ghz_circ)
circ2 = pm2.run(ghz_circ)
print("optimization_level=0:")
display(circ0.draw("mpl", idle_wires=False, fold=-1))
print("optimization_level=2:")
display(circ2.draw("mpl", idle_wires=False, fold=-1))
optimization_level=0:

optimization_level=2:

# run the circuits
sampler = Sampler(backend)
job = sampler.run([circ0, circ2], shots=10000)
job_id = job.job_id()
print(f"Job ID: {job_id}")
Job ID: d13rnnemya70008ek1zg
# REPLACE WITH YOUR OWN JOB IDS
job = service.job(job_id)
# get results
result = job.result()
unoptimized_result = result[0].data.meas.get_counts()
optimized_result = result[1].data.meas.get_counts()
from qiskit.visualization import plot_histogram

# plot
sim_result = {"0" * 5: 0.5, "1" * 5: 0.5}
plot_histogram(
    [result for result in [sim_result, unoptimized_result, optimized_result]],
    bar_labels=False,
    legend=[
        "ideal",
        "no optimization",
        "with optimization",
    ],
)

4.3 Чому синтез Circuit має значення
Далі ми порівняємо результати виконання двох по-різному синтезованих схем підготовки 5-кубітного стану GHZ ().
# Original GHZ circuit (naive synthesis)
ghz_circ.draw("mpl")
# A better GHZ circuit (smarter synthesis), you learned in a previous lecture
ghz_circ2 = QuantumCircuit(5)
ghz_circ2.h(2)
ghz_circ2.cx(2, 1)
ghz_circ2.cx(2, 3)
ghz_circ2.cx(1, 0)
ghz_circ2.cx(3, 4)
ghz_circ2.measure_all()
ghz_circ2.draw("mpl")
circ_org = pm2.run(ghz_circ)
circ_new = pm2.run(ghz_circ2)
print("original synthesis:")
display(circ_org.draw("mpl", idle_wires=False, fold=-1))
print("new synthesis:")
display(circ_new.draw("mpl", idle_wires=False, fold=-1))
original synthesis:
new synthesis:

# run the circuits
sampler = Sampler(backend)
job = sampler.run([circ_org, circ_new], shots=10000)
job_id = job.job_id()
print(f"Job ID: {job_id}")
Job ID: d13rp283grvg008j12fg
# REPLACE WITH YOUR OWN JOB IDS
job = service.job(job_id)
# get results
result = job.result()
synthesis_org_result = result[0].data.meas.get_counts()
synthesis_new_result = result[1].data.meas.get_counts()
# plot
sim_result = {"0" * 5: 0.5, "1" * 5: 0.5}
plot_histogram(
    [result for result in [sim_result, synthesis_org_result, synthesis_new_result]],
    bar_labels=False,
    legend=[
        "ideal",
        "synthesis_org",
        "synthesis_new",
    ],
)

4.4 Загальне розкладання однокубітного Gate
from qiskit import QuantumCircuit, transpile
from qiskit.circuit import Parameter
from qiskit.circuit.library.standard_gates import UGate

phi, theta, lam = Parameter("φ"), Parameter("θ"), Parameter("λ")
qc = QuantumCircuit(1)
qc.append(UGate(theta, phi, lam), [0])
qc.draw(output="mpl")

transpile(qc, basis_gates=["rz", "sx"]).draw(output="mpl")

4.5 Оптимізація однокубітних блоків
from qiskit import QuantumCircuit

qc = QuantumCircuit(1)
qc.x(0)
qc.y(0)
qc.z(0)
qc.rx(1.23, 0)
qc.ry(1.23, 0)
qc.rz(1.23, 0)
qc.h(0)
qc.s(0)
qc.t(0)
qc.sx(0)
qc.sdg(0)
qc.tdg(0)
qc.draw(output="mpl")
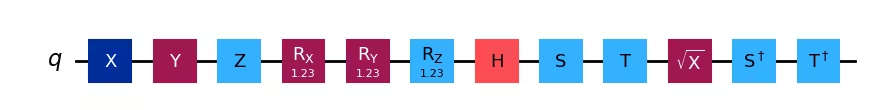
from qiskit.quantum_info import Operator

Operator(qc)
Operator([[ 0.45292511-0.57266982j, -0.66852684-0.14135058j],
          [ 0.14135058+0.66852684j, -0.57266982+0.45292511j]],
         input_dims=(2,), output_dims=(2,))
from qiskit import transpile

qc_opt = transpile(qc, basis_gates=["rz", "sx"])
qc_opt.draw(output="mpl")

Operator(qc_opt)
Operator([[ 0.45292511-0.57266982j, -0.66852684-0.14135058j],
          [ 0.14135058+0.66852684j, -0.57266982+0.45292511j]],
         input_dims=(2,), output_dims=(2,))
Operator(qc).equiv(Operator(qc_opt))
True
4.6 Розкладання Тоффолі
qc = QuantumCircuit(3)
qc.ccx(0, 1, 2)
qc.draw(output="mpl")

from qiskit import QuantumCircuit, transpile

qc = QuantumCircuit(3)
qc.ccx(0, 1, 2)
qc = transpile(qc, basis_gates=["rz", "sx", "cx"])
qc.draw(output="mpl")

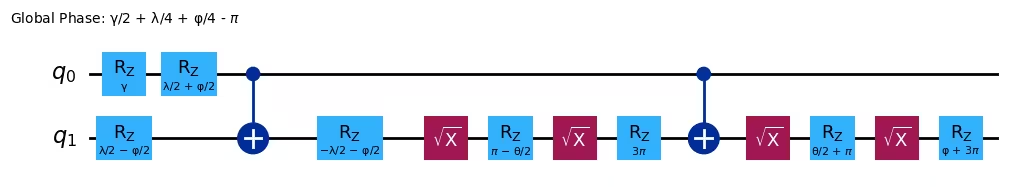
4.7 Розкладання Gate CU
from qiskit.circuit.library.standard_gates import CUGate

phi, theta, lam, gamma = Parameter("φ"), Parameter("θ"), Parameter("λ"), Parameter("γ")
qc = QuantumCircuit(2)
# qc.cu(theta, phi, lam, gamma, 0, 1)
qc.append(CUGate(theta, phi, lam, gamma), [0, 1])
qc.draw(output="mpl")

from qiskit.circuit.library.standard_gates import CUGate

phi, theta, lam, gamma = Parameter("φ"), Parameter("θ"), Parameter("λ"), Parameter("γ")
qc = QuantumCircuit(2)
qc.append(CUGate(theta, phi, lam, gamma), [0, 1])
qc = transpile(qc, basis_gates=["rz", "sx", "cx"])
qc.draw(output="mpl")
4.8 CX, ECR, CZ рівнозначні з точністю до локальних Кліффордів
Зверни увагу: (Адамар), (Z-обертання на ), (Z-обертання на ), (Паулі X) — усі є Gate Кліффорда.
qc = QuantumCircuit(2)
qc.cx(0, 1)
qc.draw(output="mpl", style="bw")

qc = QuantumCircuit(2)
qc.cx(0, 1)
transpile(qc, basis_gates=["x", "s", "h", "sdg", "ecr"]).draw(output="mpl", style="bw")

qc = QuantumCircuit(2)
qc.cx(0, 1)
transpile(qc, basis_gates=["h", "cz"]).draw(output="mpl", style="bw")

Використовуємо однокубітні базисні Gate IBM Backend: "rz", "sx" та "x".
qc = QuantumCircuit(2)
qc.cx(0, 1)
transpile(qc, basis_gates=["rz", "sx", "x", "ecr"]).draw(output="mpl", style="bw")

qc = QuantumCircuit(2)
qc.cx(0, 1)
transpile(qc, basis_gates=["rz", "sx", "x", "cz"]).draw(output="mpl", style="bw")

# Check Qiskit version
import qiskit

qiskit.__version__
'2.0.2'