Оновлення властивостей бекенда за допомогою бенчмаркінгу в реальному часі
Оцінка використання: 3 хвилини на ibm_kingston (ПРИМІТКА: Це лише оцінка. Твій фактичний час виконання може відрізнятися.)
Результати навчання
-
Чому властивості, повідомлені QPU, можуть відставати від поточної поведінки пристрою, і коли варто виміряти їх самостійно
-
Що вимірює кожен з п'яти стандартних характеризаційних експериментів (зчитування, рандомізований бенчмаркінг одного кубіта, шаруватий рандомізований бенчмаркінг двох кубітів, та )
-
Як запустити повний набір характеризації одним викликом або крок за кроком і отримати назад об'єкт бекенда з оновленими властивостями
-
Як порівняти виміряні властивості з повідомленими, і чому деякі відмінності відображають методологію вимірювання, а не дрейф пристрою
Передумови
-
Робочий процес шаблонів Qiskit
-
Режими виконання Qiskit Runtime, зокрема batch mode
-
Як досліджувати інформацію про QPU, таку як властивості бекенда та дані калібрування
Довідкова інформація
Кожен QPU IBM Quantum® повідомляє набір властивостей, що описують, наскільки добре зараз працює кожен з його кубітів: часи релаксації (), часи когерентності (), похибки зчитування та похибки одно- і двокубітних гейтів. Ці числа мають практичне значення. Транспілятор використовує їх, щоб вирішити, на яких фізичних кубітах має виконуватися твоє коло, техніки пом'якшення похибок покладаються на них, і ти можеш використовувати їх, щоб оцінити, чи достатньо добре працює пристрій для експерименту.
Повідомлені властивості беруться з процедур калібрування, що зазвичай виконуються приблизно раз на день. Проте надпровідникові кубіти можуть дрейфувати на коротших часових масштабах, а тимчасові дефекти (так звані дворівневі системи) можуть тимчасово погіршити кубіт, який під час калібрування виглядав чудово. Крім того, завдання часто транспілюється задовго до фактичного виконання, тому рішення, засновані на повідомлених властивостях, можуть спиратися на застарілу інформацію. Туторіал Бенчмаркінг у реальному часі для вибору кубітів показує, наскільки сильно ці властивості можуть змінюватися від дня до дня, і будує повний робочий процес характеризації вручну з окремих Qiskit Experiments.
Цей туторіал показує спрощену версію цього робочого процесу, використовуючи утиліту BackendCharacterization з Qiskit Device Benchmarking, яка об'єднує побудову експериментів, надсилання завдань та підгонку кривих у кілька викликів. Ти витрачаєш приблизно 70 секунд часу QPU і отримуєш назад об'єкт бекенда, властивості якого відображають пристрій прямо зараз, готовий до порівняння з повідомленими значеннями або передачі до подальших інструментів.
Характеризаційні експерименти
Набір вимірює п'ять властивостей, кожну за допомогою стандартного експерименту:
-
Похибка зчитування (
readout): Кожен кубіт готується у стані або і одразу вимірюється. Ймовірність зчитати неправильний стан дає похибку підготовки та вимірювання стану (SPAM). -
Похибка однокубітного гейта (
rb_1q): Рандомізований бенчмаркінг (RB) запускає послідовності випадкових однокубітних кліфордівських гейтів, які в ідеалі складаються в тотожність. Спосіб, яким ймовірність виживання спадає з довжиною послідовності, дає середню похибку на гейт, незалежну від похибок SPAM. -
Похибка двокубітного гейта (
rb_2q): Та сама ідея RB, застосована до повних шарів неперекривних двокубітних гейтів, що виконуються одночасно, як в експерименті пошарової точності (layer fidelity). Оскільки багато гейтів виконуються одночасно, отримані рівні похибок включають ефекти перехресних завад і ближчі до того, з чим фактично стикається глибоке коло. -
(
t1): Кожен кубіт збуджується та вимірюється після зростаючих затримок. Спад населеності збудженого стану дає час релаксації. -
(
t2): Експеримент з луною Гана поміщає кожен кубіт у суперпозицію, застосовує імпульс луни посередині затримки і вимірює, як швидко втрачається фазова когерентність. За замовчуванням використовується одна луна; наприкінці цього туторіалу продемонстровано багатолунний варіант (у стилі CPMG).
Що робить і чого не робить оновлення
Пам'ятай про три пункти під час використання цього робочого процесу:
-
Оновлені властивості існують лише в об'єкті бекенда, поверненому тобі. Нічого не змінюється ані на самому пристрої, ані в даних калібрування, які IBM Quantum повідомляє іншим користувачам.
-
Виміряні значення — це знімок, зроблений за певною методологією. Деякі з них, зокрема шаруваті двокубітні похибки та паралельні однолунні значення , вимірюються інакше, ніж повідомлені дані калібрування, тож частина будь-якої розбіжності, яку ти спостерігаєш, є методологічною, а не дрейфом. Цей туторіал вказує, де це трапляється.
-
Сама характеризація коштує часу QPU (приблизно 70 секунд для повного набору на процесорі Heron r2), що є ціною актуальної інформації.
Робочий процес слідує чотирьом крокам шаблону Qiskit:
-
Крок 1: Відображення класичних вхідних даних у квантову задачу. Обери пристрій та набір властивостей для вимірювання.
-
Крок 2: Оптимізація задачі для виконання на квантовому обладнанні. Утиліта будує експериментальні кола безпосередньо в нативних гейтах пристрою та розпаралелює їх по чипу.
-
Крок 3: Виконання за допомогою примітивів Qiskit. Експерименти виконуються як завдання Sampler всередині пакета.
-
Крок 4: Постобробка та повернення результату в бажаному класичному форматі. Підгони дані вимірювань у карти похибок для кожного кубіта, онови бекенд і порівняй виміряні властивості з повідомленими.
Вимоги
Перед початком цього туторіалу переконайся, що в тебе встановлено таке:
-
Qiskit SDK v2.0 або новіша, з підтримкою візуалізації
-
Qiskit Runtime v0.40 або новіша (
pip install qiskit-ibm-runtime) -
Qiskit Device Benchmarking, який також встановлює Qiskit Experiments (
pip install git+https://github.com/qiskit-community/qiskit-device-benchmarking.git)
Налаштування
Імпортуй необхідні бібліотеки.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "qiskit_device_benchmarking": "git+https://github.com/qiskit-community/qiskit-device-benchmarking.git", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import logging
import sys

import numpy as np
from qiskit_ibm_runtime import Batch, QiskitRuntimeService

from qiskit_device_benchmarking.utilities.characterization_utils import (
    BackendCharacterization,
    plot_characterization_comparison,
)
Набір характеризації будує кілька експериментів, надсилає декілька завдань і підганяє результати, що загалом може зайняти кілька хвилин. Увімкни журналювання рівня INFO, щоб кожен етап виводив свій прогрес у міру виконання.
logger = logging.getLogger("qiskit_device_benchmarking")
logger.setLevel(logging.INFO)
logger.addHandler(logging.StreamHandler(stream=sys.stdout))
Маломасштабний приклад на симуляторі
Цей туторіал не містить прикладу симулятора. Робочий процес вимірює фізичні недосконалості конкретного пристрою: наскільки швидко його кубіти релаксують і дефазуються, і як часто його гейти та зчитування дають похибки. Ідеальний симулятор не має жодної з цих недосконалостей, тож нічого характеризувати. Ти міг би приєднати синтетичну модель шуму до фейкового бекенда, але тоді експерименти лише повернули б числа, які ти сам туди вклав. З цієї причини ми переходимо безпосередньо до апаратного забезпечення, розбитого на чотири кроки шаблону Qiskit.
Великомасштабний приклад на реальному обладнанні
Крок 1: Відображення класичних вхідних даних у квантову задачу
У цьому робочому процесі "задача" — це сам пристрій: класичні вхідні дані — це QPU, який ти хочеш характеризувати, і список властивостей для вимірювання, а квантові експерименти — це характеризаційні кола, згенеровані з них.
Спочатку вибери бекенд. Цей туторіал використовує ibm_kingston, 156-кубітний процесор Heron r2; ти можеш замінити його на будь-який пристрій IBM Quantum, до якого маєш доступ (або обрати його за допомогою service.least_busy()).
service = QiskitRuntimeService()
device = "ibm_kingston"
backend = service.backend(device)
Далі вибери, які властивості вимірювати. Ти можеш передати будь-яку підмножину таких експериментів:
-
readout: SPAM-експеримент (підготовка та вимірювання стану) -
rb_1q: ізольований рандомізований бенчмаркінг одного кубіта -
rb_2q: одночасний рандомізований бенчмаркінг двох кубітів з експерименту пошарової точності -
t2: експеримент з луною Гана (одна луна за замовчуванням) -
t1: експеримент релаксації
Запусти повний набір, щоб отримати повну картину пристрою; вилучи записи зі списку, якщо тебе цікавлять лише деякі властивості й ти хочеш заощадити час QPU.
experiments = ["readout", "rb_1q", "rb_2q", "t1", "t2"]
Крок 2: Оптимізація задачі для виконання на квантовому обладнанні
У більшості туторіалів це той момент, коли ти б транспілював свої кола. Тут BackendCharacterization бере це на себе внутрішньо. Він будує експериментальні кола безпосередньо в нативних гейтах пристрою, запускає однокубітні експерименти на всіх кубітах паралельно та планує двокубітний бенчмаркінг по неперетинних шарах карти зв'язності так, щоб увесь пристрій було охоплено кількома завданнями. Завдяки цій паралелізації весь набір споживає лише приблизно 70 секунд часу QPU.
Ініціалізуй клас, який керує робочим процесом:
# Initialize the class used to run the experiments
characterizer = BackendCharacterization(backend)
Крок 3: Виконання за допомогою примітивів Qiskit
Метод run_experiments будує кола та надсилає їх як завдання Sampler. Запусти його всередині контексту Batch, щоб завдання були заплановані разом на QPU, а метод повертає керування, щойно всі завдання надіслано. (Ти також можеш запустити його поза пакетом або всередині Session.)
Ти можеш побачити попередження про те, що backend передається, поки контекстний менеджер сесії відкритий. Це очікувано і його можна безпечно ігнорувати.
# Run the characterization experiments inside a Batch
with Batch(backend=backend):
    jobs = characterizer.run_experiments(experiments=experiments)
base_primitive.get_mode_service_backend:WARNING:2026-07-14 14:23:02,051: A backend was passed in as the mode but a session context manager is open so this job will run inside this session/batch instead of in job mode.
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7tfu6hjac73ffba2g', 'd9b7tjug26ic73dfju3g', 'd9b7u3u6hjac73ffban0', 'd9b7u7rv6alc73csmicg']
Readout job submitted: d9b7u8bv6alc73csmidg
T1 experiment submitted: ['d9b7u8ug26ic73dfjuqg']
T2 (Hahn) experiment submitted: ['d9b7u9fu62qs738othg0']
Single-qubit RB submitted: ['d9b7v8m6hjac73ffbc40', 'd9b7veeg26ic73dfk040']
Метод повертає надіслані завдання у вигляді словника, ключами якого є експерименти, що корисно для відстеження їх на панелі IBM Quantum Platform або для налагодження.
# Print all the job IDs for debugging purposes
jobs
{'rb_2q': [<RuntimeJobV2('d9b7tfu6hjac73ffba2g', 'sampler')>,
  <RuntimeJobV2('d9b7tjug26ic73dfju3g', 'sampler')>,
  <RuntimeJobV2('d9b7u3u6hjac73ffban0', 'sampler')>,
  <RuntimeJobV2('d9b7u7rv6alc73csmicg', 'sampler')>],
 'readout': [<RuntimeJobV2('d9b7u8bv6alc73csmidg', 'sampler')>],
 't1': [<RuntimeJobV2('d9b7u8ug26ic73dfjuqg', 'sampler')>],
 't2': [<RuntimeJobV2('d9b7u9fu62qs738othg0', 'sampler')>],
 'rb_1q': [<RuntimeJobV2('d9b7v8m6hjac73ffbc40', 'sampler')>,
  <RuntimeJobV2('d9b7veeg26ic73dfk040', 'sampler')>]}
Крок 4: Постобробка та повернення результату в бажаному класичному форматі
Аналіз результатів
Метод analyze_results чекає на завершення завдань і підганяє дані вимірювань: експоненційні спади для і , спади ймовірності виживання для експериментів RB та матриці присвоєння для зчитування. Він повертає словник карт похибок, по одному запису для кожної виміряної властивості, кожна з яких відображає кубіт (або пару кубітів) на його виміряне значення.
error_maps = characterizer.analyze_results()
print(f"The following error maps are available: {list(error_maps.keys())}")
readout_q0 = error_maps["readout_error"][0]
print(f"For example, readout error for qubit 0 is {readout_q0}")
The following error maps are available: ['readout_error', 'oneq_error_x', 'oneq_error_sx', 'lf_error_map', 't1_map', 't2_map']
For example, readout error for qubit 0 is 0.007600000000000051
Карти охоплюють похибку зчитування, похибки однокубітних гейтів x і sx, шаруваті двокубітні похибки (lf_error_map, з експерименту пошарової точності) та часи і у секундах.
Оновлення властивостей бекенда
Метод update_backend записує виміряні значення у властивості копії бекенда та повертає її. Оригінальний об'єкт backend зберігає повідомлені дані калібрування, щоб ми могли порівняти їх, як показано нижче. Пам'ятай, що це оновлення суто локальне для твоєї сесії Python; воно не змінює нічого на пристрої чи для інших користувачів.
backend_updated = characterizer.update_backend()
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
Порівняння виміряних властивостей з повідомленими
Наостанок, побудуй графік виміряних властивостей у реальному часі відносно значень, які повідомляє бекенд. На кожній панелі кубіти (або пари кубітів) відсортовані за виміряним значенням, тому виміряна крива є гладкою за побудовою, а розкид повідомлених значень навколо неї показує, де вони розходяться. Для однокубітного RB показано один графік, оскільки та сама виміряна похибка на гейт присвоюється як гейту x, так і гейту sx. Межі осей обираються з основної маси даних, щоб кілька екстремальних викидів не стискали графіки; будь-які точки поза діапазоном підраховуються в анотації на графіку (або передай ylim, щоб перевизначити межі).
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated.properties().to_dict(),
    plots=["readout", "rb_1q", "rb_2q", "t1", "t2"],
)
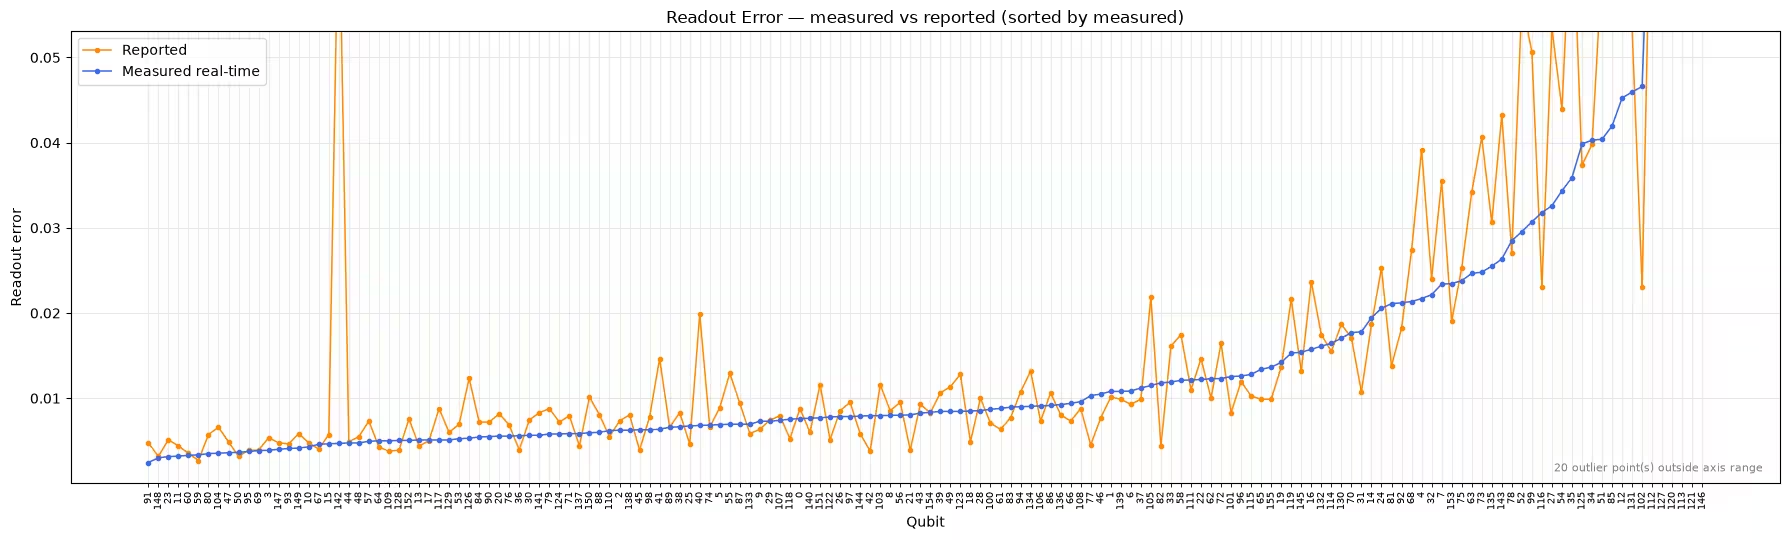
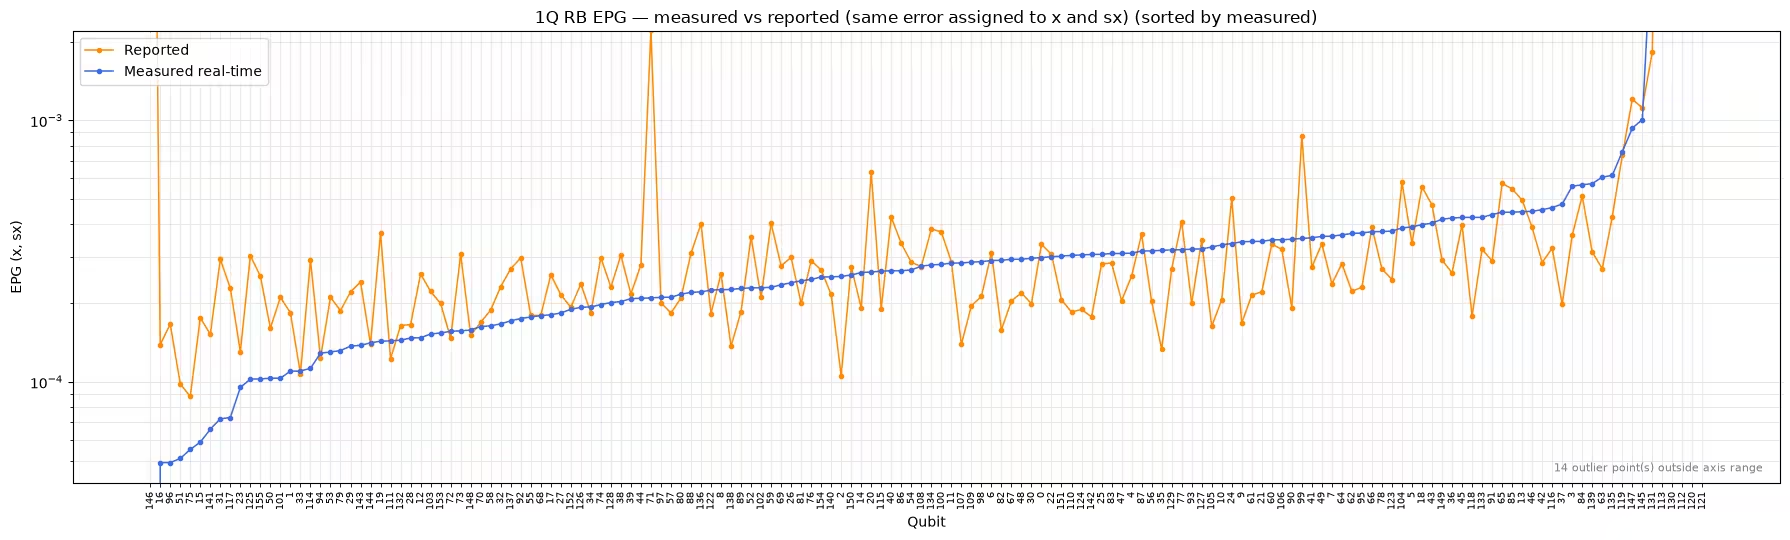
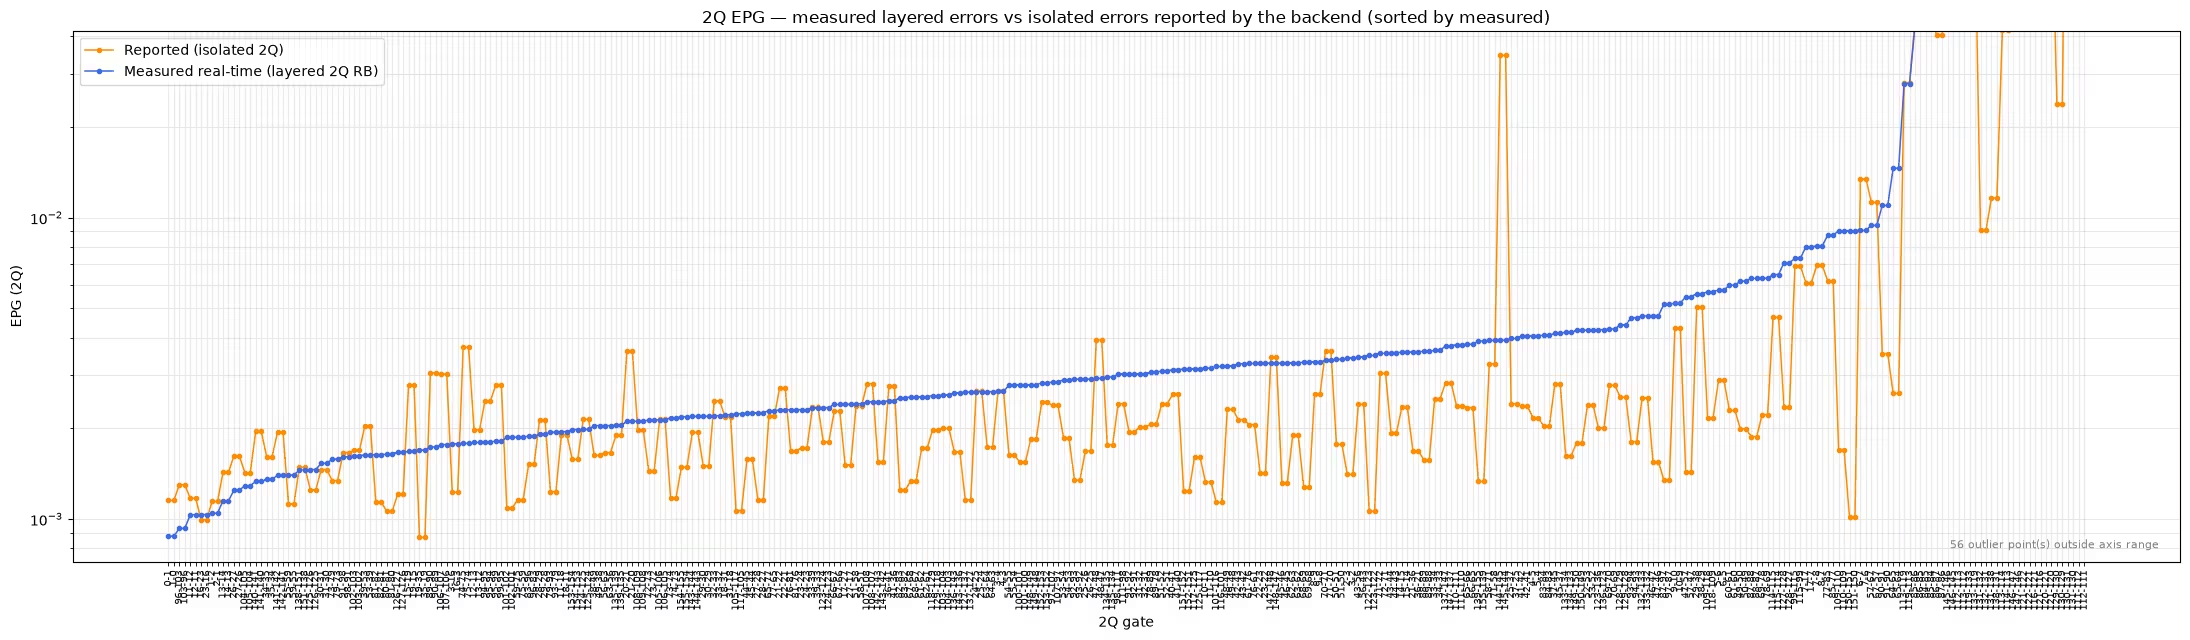
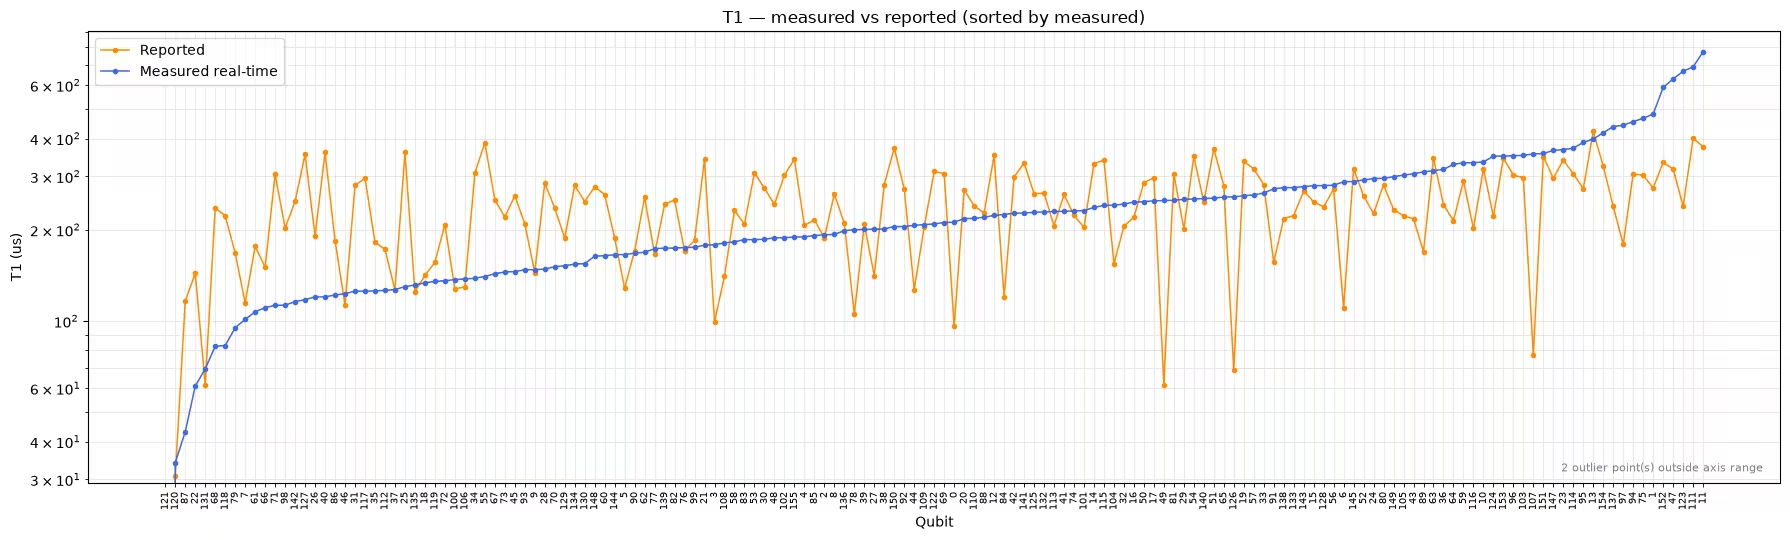
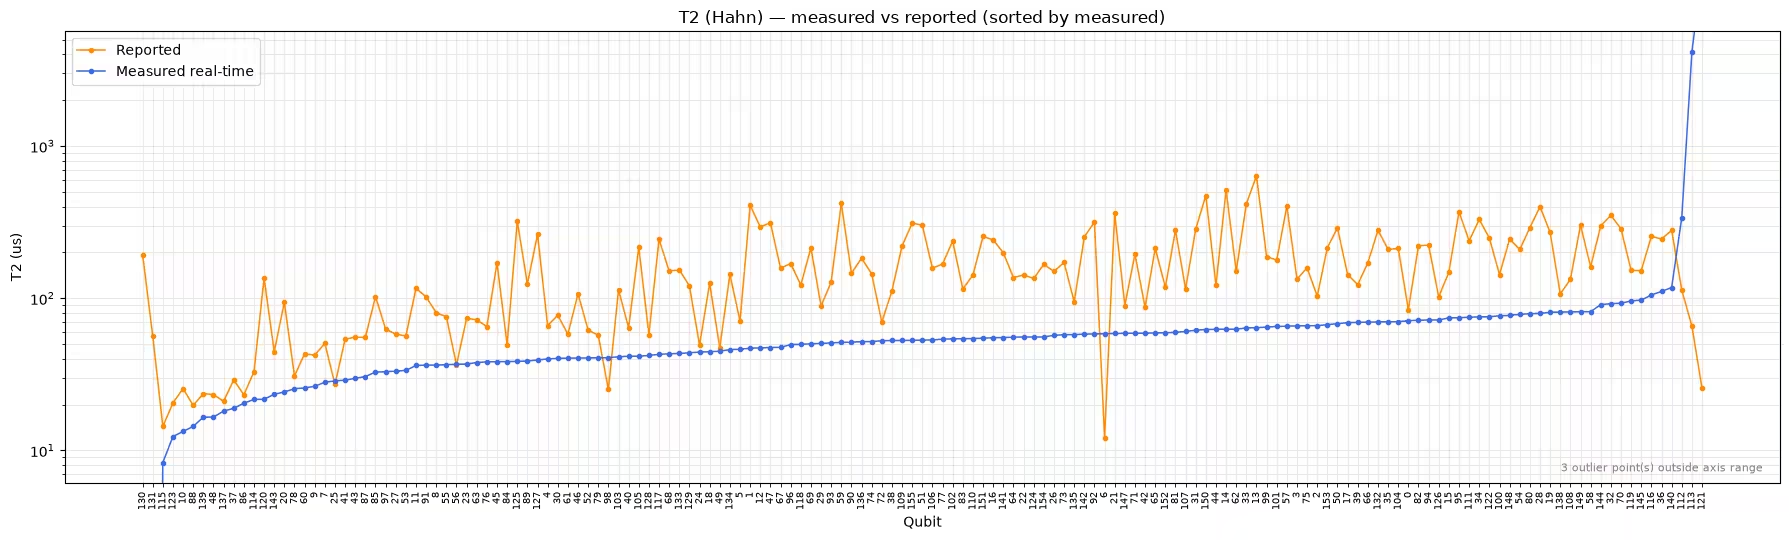
Ці графіки потребують уважного читання, оскільки не кожна розбіжність між двома кривими означає, що пристрій дрейфував:
-
Похибки зчитування та однокубітні похибки: Виміряні значення відповідають повідомленим для більшості кубітів, тоді як повідомлене значення для кількох кубітів сильно відхиляється від виміряної кривої. Ці локалізовані розбіжності — це і є дрейф, для виявлення якого призначений цей робочий процес.
-
: Два набори даних розсіяні навколо один одного без систематичного зміщення, що узгоджується з природним коливанням у часі.
-
Двокубітні похибки: Виміряні значення систематично перебувають вище повідомлених. Це очікувано, оскільки повідомлені значення вимірюються на ізольованих гейтах, тоді як експеримент пошарової точності запускає багато гейтів одночасно і, відповідно, включає перехресні завади. Шаруваті числа більш релевантні для глибоких кіл, але вони не є прямо порівнянними з повідомленими даними калібрування.
-
: Виміряні значення перебувають значно нижче повідомлених для більшості кубітів. Знову ж таки, методологія відіграє велику роль, як розглядається в наступному розділі.
Перевірка результатів окремих експериментів
Ти також можеш перевірити сирі результати окремих характеризаційних експериментів через властивість experiment_data, яка повертає базові об'єкти ExperimentData Qiskit Experiments. Наприклад, наступне відображає виміряну криву спаду одного кубіта, що корисно для перевірки якості підгонки перед тим, як довіряти отриманому числу.
t1_data = characterizer.experiment_data["t1"]

# Each qubit has its own fit figure
n_figs = len(t1_data.figure_names)
print(f"{n_figs} figures available, e.g. {t1_data.figure_names[0]}")

# Show the T1 decay curve of the first qubit
t1_data.figure(0)
156 figures available, e.g. T1_Q0_c78ef792.svg

Вимірювання T2 з послідовністю імпульсів динамічного розв'язання
За замовчуванням експеримент застосовує одну луну Гана та вимірює всі кубіти паралельно, що, як показав наведений вище графік порівняння, може давати помітно нижчі значення , ніж повідомляє бекенд. Одна з гіпотез — кількість лун: повідомлені значення можуть бути каліброваними з динамічним розв'язанням (dynamical decoupling), яке пригнічує низькочастотний шум. Щоб перевірити це, запусти характеризацію лише з t2_num_echoes, встановленим у більше значення, що застосовує послідовність імпульсів луни в стилі CPMG. Затримки в обох випадках представляють загальний час вільної еволюції, тому підігнані значення безпосередньо порівнювані з результатами з однією луною.
# Run a T2-only characterization using a CPMG-style train of 8 echoes
characterizer_dd = BackendCharacterization(backend)
backend_updated_dd = characterizer_dd.run_and_update(
    experiments=["t2"], t2_num_echoes=8
)
Building T2 experiments
T2 (Hahn) experiment submitted: ['d9b96s6g26ic73dflcn0']
Updating T2
# Compare the multi-echo T2 against the backend-reported values
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated_dd.properties().to_dict(),
    plots=["t2"],
    title_prefix="8-echo CPMG",
)

# Compare medians across the reported values, the single-echo run,
# and the 8-echo run
reported_t2s = [
    prop["value"]
    for qubit in backend.properties().to_dict()["qubits"]
    for prop in qubit
    if prop["name"] == "T2"
]
t2_reported = np.median(reported_t2s)
t2_single = np.median(list(error_maps["t2_map"].values())) * 1e6
t2_dd = (
    np.median(list(characterizer_dd.analyze_results()["t2_map"].values()))
    * 1e6
)
print(
    f"Median T2 — reported: {t2_reported:.0f} us | "
    f"single echo: {t2_single:.0f} us | 8-echo CPMG: {t2_dd:.0f} us"
)
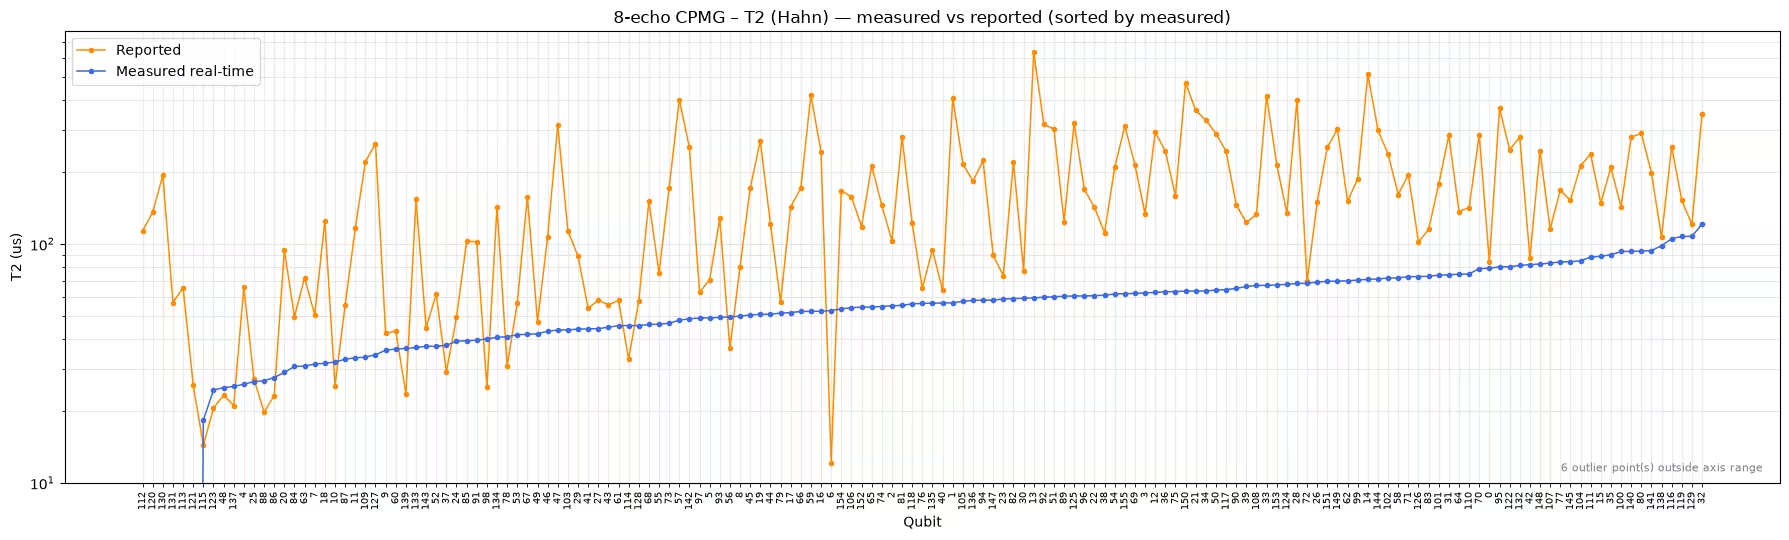
Median T2 — reported: 142 us | single echo: 53 us | 8-echo CPMG: 56 us
У цьому запуску додаткові луни майже не змінили результат: медіана з 8 лунами (56 µс) близька до медіани з однією луною (53 µс), і обидві залишаються значно нижчими за повідомлену медіану (142 µс). Сама лише кількість лун не пояснює цю розбіжність; тут задіяні інші методологічні відмінності, такі як деталі процедури калібрування, вимірювання всіх кубітів паралельно, а не окремо, тощо.
Практичний висновок полягає в тому, що порівняння (і пошарової двокубітної похибки) між методологіями слід робити обережно. Оновлені значення являють собою самоузгоджений знімок, зроблений в умовах, близьких до реального навантаження, що робить їх добре придатними для порівняння кубітів між собою або відстеження пристрою з часом. Проте розбіжність відносно повідомлених калібрувальних даних не є автоматично доказом дрейфу.
Кроки 1–4, стиснуті в один виклик
Для повсякденного використання проміжні результати рідко потрібні. Метод run_and_update об'єднує все, що ти зробив вище (побудову, надсилання, підгонку та оновлення) в один виклик, який повертає оновлений бекенд. Він приймає той самий список experiments (і передає такі опції, як t2_num_echoes), і так само може бути обгорнутий у контекст Batch або Session.
Наступна комірка не повертає управління, доки всі завдання та постобробка не будуть завершені.
# Initialize a fresh characterizer
characterizer = BackendCharacterization(backend)

# Run all of the experiments and update the backend in a single call
backend_updated = characterizer.run_and_update(experiments=experiments)
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7oqnu62qs738otat0', 'd9b7p76g26ic73dfjolg', 'd9b7pnm6hjac73ffb57g', 'd9b7q4fu62qs738otce0']
Readout job submitted: d9b7q4mg26ic73dfjprg
T1 experiment submitted: ['d9b7q57u62qs738otcfg']
T2 (Hahn) experiment submitted: ['d9b7q5m6hjac73ffb5pg']
Single-qubit RB submitted: ['d9b7r4e6hjac73ffb71g', 'd9b7reu6hjac73ffb7d0']
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
Оновлений об'єкт backend_updated тепер готовий до використання скрізь, де властивості бекенда впливають на твій робочий процес. Спробуй застосувати цей процес разом із туторіалом Real-time benchmarking for qubit selection, щоб обрати найкращі кубіти під час транспіляції кола. Оскільки пристрій постійно дрейфує, оновлюй властивості якомога ближче до моменту фактичного виконання свого робочого навантаження.
Наступні кроки
Якщо ця робота здалася тобі цікавою, тебе можуть зацікавити такі матеріали:
- Використовуй оновлені властивості для вибору кращих кубітів у туторіалі Real-time benchmarking for qubit selection
- Дізнайся, як повідомлені калібрувальні дані представлені в посібнику QPU information
- Ознайомся з окремими експериментами характеризації в документації Qiskit Experiments
- Переглянь додаткові бенчмарки на рівні пристрою в репозиторії Qiskit Device Benchmarking