Класифікація кредитного ризику за допомогою Quantum Feature Extraction від Rimay компанії Kipu Quantum
Qiskit Functions — це експериментальна функція, доступна лише користувачам IBM Quantum® Premium Plan, Flex Plan і On-Prem (через IBM Quantum Platform API) Plan. Вони мають статус попереднього випуску і можуть змінюватися.
Оцінка використання: 2 хвилини на процесорі Nighthawk r2. (ПРИМІТКА: це лише оцінка. Фактичний час виконання може відрізнятися.)
Результати навчання
-
Підготувати табличні дані з категоріальними та числовими стовпцями для Qiskit Function Rimay.
-
Підігнати квантове відображення ознак на навчальних даних і відобразити тестові дані в тому самому запуску.
-
Навчити класичні моделі на квантово-перетворених ознаках — окремо та разом з оригінальними ознаками.
-
Порівняти результати з суто класичною базовою лінією.
Передумови
Перш ніж почати цей навчальний посібник, ти маєш бути знайомий з такими темами:
-
Кероване навчання класифікації за допомогою scikit-learn
Передісторія
Багато задач машинного навчання в індустрії мають справу з малими або середніми табличними наборами даних, де додавання даних неможливе, а точність моделі виходить на плато. Типовий приклад — кредитний скоринг. Кредитор використовує кілька десятків атрибутів, щоб вирішити, чи ймовірно, що заявник поверне кредит.
Rimay, Qiskit Function від Kipu Quantum, додає до такого конвеєра крок квантової передобробки. Вона реалізує алгоритм оцифрованого контрдіабатичного квантового вилучення ознак [1]. Кожна вхідна ознака відображається на один кубіт. Значення ознак і взаємна інформація між ознаками задають локальні поля та зв'язки гамільтоніана спінового скла. Контрдіабатична динаміка потім еволюціонує квантову систему до її низькоенергетичних станів, а одно- та двочастинкові середні значення, виміряні наприкінці, стають новими, квантово-перетвореними ознаками. Ці ознаки відображають нелінійні кореляції між входами, і ти можеш подати їх у будь-яку класичну модель.
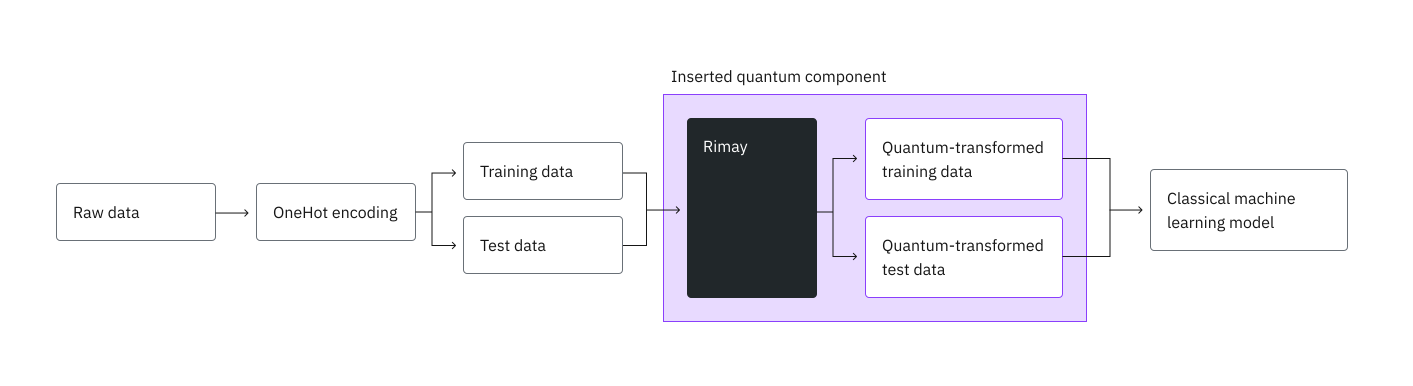
Цей посібник використовує німецький кредитний набір даних з OpenML [2], з 1000 заявників і 20 атрибутами, щоб навчити класифікатор випадкового лісу. Спочатку ти встановлюєш класичну базову лінію, потім надсилаєш дані до Rimay і, нарешті, навчаєш модель того самого типу на квантово-перетворених ознаках — окремо та разом з оригінальними ознаками.
Вимоги
Перш ніж почати цей навчальний посібник, переконайся, що встановлено такі пакети:
-
Клієнт IBM Quantum Compute (
pip install qiskit-ibm-runtime) -
Qiskit Functions (
pip install qiskit-ibm-catalog) -
scikit-learn (
pip install scikit-learn) -
pandas (
pip install pandas) -
Matplotlib (
pip install matplotlib)
Тобі також потрібен доступ до функції Rimay з каталогу Qiskit Functions.
Налаштування
Імпортуй пакети та визнач дві допоміжні функції: одну, що навчає випадковий ліс, і другу, що обчислює метрики, які використовуються в усьому посібнику.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "sklearn": "scikit-learn"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from qiskit_ibm_catalog import QiskitFunctionsCatalog
from sklearn.datasets import fetch_openml
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import (
    accuracy_score,
    f1_score,
    precision_score,
    recall_score,
    roc_auc_score,
)
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder

def train_random_forest(x, y, n_estimators, max_depth):
    """Train a random forest classifier with fixed hyperparameters."""
    model = RandomForestClassifier(
        n_estimators=n_estimators,
        max_depth=max_depth,
        min_samples_split=5,
        min_samples_leaf=1,
        max_features="sqrt",
        random_state=42,
        n_jobs=-1,
    )
    return model.fit(x, y)

def evaluate(model, x, y):
    """Return the classification metrics of a trained model on a test set."""
    y_pred = model.predict(x)
    y_proba = model.predict_proba(x)[:, 1]
    return {
        "Accuracy": accuracy_score(y, y_pred),
        "AUC": roc_auc_score(y, y_proba),
        "F1 score": f1_score(y, y_pred),
        "Precision": precision_score(y, y_pred),
        "Recall": recall_score(y, y_pred),
    }
Налаштування облікових даних IBM Quantum
Автентифікуйся за допомогою свого ключа API IBM Quantum Platform, завантаж функцію Rimay і вибери найменш завантажений квантовий процесор, доступний для твого екземпляра.
catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")
rimay = catalog.load("kipu-quantum/rimay")

backend = catalog.least_busy(operational=True, simulator=False)
print(backend.name, backend.num_qubits)
ibm_fez 156
Крок 1: Відобрази класичні входи на квантову задачу
Rimay відображає кожну числову вхідну ознаку на один кубіт, тому перший крок — перетворити вихідну таблицю на числові ознаки.
Завантаження набору даних
Завантаж німецький кредитний набір даних безпосередньо з OpenML. Стовпець class містить мітку: good для заявників, які повернули кредит, і bad для тих, хто не повернув.
df = fetch_openml(data_id=31, as_frame=True).frame
print(df.shape)
df.head()
(1000, 21)
checking_status  duration                  credit_history  \
0              <0         6  critical/other existing credit
1        0<=X<200        48                   existing paid
2     no checking        12  critical/other existing credit
3              <0        42                   existing paid
4              <0        24              delayed previously

               purpose  credit_amount    savings_status employment  \
0             radio/tv           1169  no known savings        >=7
1             radio/tv           5951              <100     1<=X<4
2            education           2096              <100     4<=X<7
3  furniture/equipment           7882              <100     4<=X<7
4              new car           4870              <100     1<=X<4

   installment_commitment     personal_status other_parties  ...  \
0                       4         male single          none  ...
1                       2  female div/dep/mar          none  ...
2                       2         male single          none  ...
3                       2         male single     guarantor  ...
4                       3         male single          none  ...

   property_magnitude age  other_payment_plans   housing existing_credits  \
0         real estate  67                 none       own                2
1         real estate  22                 none       own                1
2         real estate  49                 none       own                1
3      life insurance  45                 none  for free                1
4   no known property  53                 none  for free                2

                  job num_dependents  own_telephone foreign_worker class
0             skilled              1            yes            yes  good
1             skilled              1           none            yes   bad
2  unskilled resident              2           none            yes  good
3             skilled              2           none            yes  good
4             skilled              2           none            yes   bad

[5 rows x 21 columns]
Кодування ознак
Перетвори мітку на двійкове значення та закодуй 13 категоріальних стовпців за допомогою one-hot кодування. Код відкидає першу категорію кожного стовпця, щоб уникнути надлишкових ознак, у результаті чого виходить 48 числових ознак.
y = (df["class"] == "good").astype(int)

features = df.drop(columns="class")
categorical_cols = [
    col for col in features.columns if features[col].dtype.name == "category"
]
encoder = OneHotEncoder(
    sparse_output=False, handle_unknown="ignore", drop="first"
)
encoded = pd.DataFrame(
    encoder.fit_transform(features[categorical_cols]),
    columns=encoder.get_feature_names_out(categorical_cols),
    index=features.index,
)
x = pd.concat([features.drop(columns=categorical_cols), encoded], axis=1)
print(f"{x.shape[1]} features")
48 features
Розділення на навчальну та тестову вибірки
Відклади 20% заявників як тестову вибірку. Стратифіковане розділення зберігає однакову частку хороших і поганих кредитів в обох вибірках.
x_train, x_test, y_train, y_test = train_test_split(
    x, y, test_size=0.2, random_state=42, stratify=y
)
print(f"Training set: {x_train.shape}, test set: {x_test.shape}")
Training set: (800, 48), test set: (200, 48)
Встановлення класичної базової лінії
Навчи випадковий ліс на класичних ознаках. На кроці 4 ти порівняєш квантово-перетворені ознаки з його метриками.
baseline = train_random_forest(
    x_train, y_train, n_estimators=500, max_depth=12
)
results = {"Classical": evaluate(baseline, x_test, y_test)}
pd.DataFrame(results).T
Accuracy       AUC  F1 score  Precision    Recall
Classical     0.765  0.781071  0.845902   0.781818  0.921429
Завантаження даних до Rimay
Rimay читає свої входи з CSV-файлів, які ти завантажуєш до функції. Ознаки та мітки йдуть в окремі файли. Ти також завантажуєш тестову вибірку, щоб Rimay відобразив її тим самим відображенням, яке підігнано на навчальній вибірці.
x_train.to_csv("x_train.csv", index=False)
y_train.to_csv("y_train.csv", index=False)
x_test.to_csv("x_test.csv", index=False)

for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
Крок 2: Оптимізуй задачу для виконання на квантовому обладнанні
Rimay будує та транспілює схеми для процесора, який ти вибираєш, тому оптимізувати схему вручну не потрібно. Вкажи кількість шотів на схему в межах таких обмежень:
-
Кожна ознака потребує одного кубіта, тому процесор повинен мати щонайменше стільки кубітів, скільки ознак у наборі даних.
-
Rimay виконує одну схему на рядок, навчальні та тестові рядки разом. Одне завдання може запросити щонайбільше 10 мільйонів виконань, тому кількість рядків, помножена на
shots, має вкладатися в цей бюджет.
Перевір обидва обмеження, перш ніж подавати завдання.
Завдання також має завершитися протягом 24 годин, включно з часом очікування його схем у черзі, інакше його буде зупинено без результату.
shots = 5000

n_rows = len(x_train) + len(x_test)
n_features = x_train.shape[1]
print(f"Qubits needed: {n_features} of {backend.num_qubits} available")
print(f"Executions: {n_rows * shots:,} of 10,000,000 allowed")
Qubits needed: 48 of 156 available
Executions: 5,000,000 of 10,000,000 allowed
Обчислення розміру функції
Кожне завдання виконується з розміром функції S, M або L, який визначає обчислювальні ресурси, на яких воно працює. Для Rimay розмір залежить від кількості рядків, які відображає завдання, навчальних і тестових разом. Якщо ти запитаєш замалий розмір, завдання завершиться помилкою 4600. Розміри та їхні обмеження описано в розділі Function sizes посібника з Rimay.
Наступна комірка визначає калькулятор розміру. Він виконується на твоїй машині, читає лише дані, які ти йому передаєш, і нічого не подає.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Передай набори даних у тому ж порядку, що й файли в input_file, разом з режимом запуску:
size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Крок 3: Виконай за допомогою примітивів Qiskit
Запусти Rimay в режимі fit-transform. Він підганяє квантове відображення ознак на x_train.csv і y_train.csv та відображає ним і навчальну, і тестову вибірки. Порядок файлів у input_file має значення. Перелічи навчальні ознаки, навчальні мітки, а потім необов'язкові тестові ознаки. Передай розмір, який ти обчислив, як function_size.
job = rimay.run(
    mode="fit-transform",
    input_file=[
        "x_train.csv",
        "y_train.csv",
        "x_test.csv",
    ],  # This order matters
    backend_name=backend.name,
    shots=shots,
    function_size=size,
)
print(job.job_id)
de5094df-bb17-4924-9605-d6196a4aa999
Моніторинг завдання
Перевіряй статус завдання, поки воно виконується. job.result() блокує виконання, доки завдання не завершиться.
print(job.status())
INITIALIZING
result = job.result()
print(result["output_files"])
['de5094df-bb17-4924-9605-d6196a4aa999_xq_train.csv', 'de5094df-bb17-4924-9605-d6196a4aa999_xq_test.csv']
Результат містить mapping_id, який ідентифікує відображення, підігнане цим запуском. У цьому посібнику він тобі не потрібен, оскільки тестову вибірку було відображено в тому самому запуску. Збережи цей ID, якщо хочеш пізніше відображати нові рядки за допомогою mode="transform". Це єдиний спосіб отримати доступ до підігнаного відображення, а без нього тобі доведеться підганяти та оплачувати нове. Відображення побудоване для розташування кубітів цього процесора, тому наступний запуск transform має передати той самий backend_name.
mapping_id = result["mapping_id"]
Крок 4: Постобробка та повернення результату в потрібному класичному форматі
Завантаження квантово-перетворених ознак
Завантаж файли, які записало завдання, використовуючи імена з output_files. Кожне ім'я починається з ID завдання, тож файли цього запуску залишаються доступними після наступних запусків. Передай target_name, щоб кожен файл зберігався під власним іменем.
train_file, test_file = result["output_files"]
for file_name in (train_file, test_file):
    catalog.file_download(file_name, rimay, target_name=file_name)

xq_train = pd.read_csv(train_file).to_numpy()
xq_test = pd.read_csv(test_file).to_numpy()
print(f"Quantum-transformed features: {xq_train.shape[1]}")
586kiB [00:00, 1.13MiB/s]
147kiB [00:00, 336kiB/s]
Quantum-transformed features: 99
Навчання на квантово-перетворених ознаках
Навчи випадковий ліс лише на квантово-перетворених ознаках.
quantum = train_random_forest(
    xq_train, y_train, n_estimators=900, max_depth=15
)
results["Quantum"] = evaluate(quantum, xq_test, y_test)
Навчання на об'єднаних класичних і квантових ознаках
Об'єднай оригінальні та квантово-перетворені ознаки в стек і навчи ту саму модель на цій комбінації.
xh_train = np.hstack([x_train.to_numpy(), xq_train])
xh_test = np.hstack([x_test.to_numpy(), xq_test])

hybrid = train_random_forest(
    xh_train, y_train, n_estimators=900, max_depth=15
)
results["Hybrid"] = evaluate(hybrid, xh_test, y_test)
Порівняння результатів
Порівняй три моделі на тестовій вибірці.
comparison = pd.DataFrame(results).T
print(comparison.round(3))

comparison[["Accuracy", "AUC", "F1 score"]].T.plot.bar(rot=0, figsize=(8, 4))
plt.ylim(0.5, 1.0)
plt.ylabel("Score on the test set")
plt.title("Random forest on classical, quantum, and hybrid features")
plt.show()
Accuracy    AUC  F1 score  Precision  Recall
Classical     0.765  0.781     0.846      0.782   0.921
Quantum       0.730  0.784     0.827      0.750   0.921
Hybrid        0.730  0.791     0.825      0.756   0.907

AUC вимірює, наскільки добре модель ранжує хороші кредити вище за погані, незалежно від порогу рішення, що робить його найінформативнішою метрикою на цьому незбалансованому наборі даних (70% хороших кредитів). У бенчмарках Kipu Quantum квантово-перетворені ознаки самі по собі досягли AUC, подібного до класичної базової лінії, а гібридна модель, що поєднує обидва типи, досягла найвищих AUC та F1-міри. Отже, квантово-перетворені ознаки додають інформацію, якої класичні ознаки самі по собі не дають.
Очищення (необов'язково)
Підігнане відображення залишається доступним, доки ти його не видалиш. Якщо ти не хочеш відображати ним подальші дані, видали його. Видалення не виконує жодної квантової роботи, не використовує час QPU і його не можна скасувати.
# rimay.run(mode="delete", mapping_id=mapping_id).result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': 'eUCy4EnZM7G9jYo5b2Pu-TuCXK7zX_wPTT67g9J1dVE',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Висновок
Чого ти досяг
У цьому посібнику ти зробив таке:
-
Підготував реальний набір даних про кредитний ризик з категоріальними та числовими атрибутами для квантового вилучення ознак.
-
Встановив класичну базову лінію на основі випадкового лісу.
-
Використав Rimay, щоб підігнати квантове відображення ознак на квантовому обладнанні та відобразити навчальну й тестову вибірки за один запуск.
-
Навчив ту саму модель на квантово-перетворених і на об'єднаних ознаках та порівняв їх з базовою лінією.
Ключові висновки
-
Rimay вбудовується в наявний конвеєр машинного навчання як один додатковий крок передобробки. Ти зберігаєш свою підготовку даних і свою класичну модель.
-
Кількість кубітів обмежує кількість вхідних ознак, а кількість рядків, помножена на
shots, обмежує розмір одного завдання. -
Використовуй квантово-перетворені ознаки разом з оригінальними як типовий варіант, оскільки модель може використати обидва типи.
Наступні кроки
- Прочитай посібник з Rimay, щоб дізнатися про всі входи, відображати нові дані за допомогою
mode="transform"і побачити додаткові бенчмарки. - Прочитай, як квантове вилучення ознак застосували до класифікації супутникових зображень [3].
Посилання
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.