Rimay Quantum Feature Extraction — Qiskit Function від Kipu Quantum
Див. довідник API.
Qiskit Functions — це експериментальна функція, доступна лише користувачам IBM Quantum® Premium Plan, Flex Plan та On-Prem (через IBM Quantum Platform API) Plan. Вони перебувають у статусі попереднього випуску і можуть змінюватися.
Огляд
Rimay доповнює класичні конвеєри машинного навчання ознаками, згенерованими на квантовому обладнанні. Функція приймає класичні табличні дані та повертає набір квантово перетворених ознак. Коли квантова система обробляє дані, вона генерує багаті ознаки, що відображають нелінійні зв'язки між вхідними даними. Ти можеш використовувати згенеровані ознаки окремо або разом з початковими ознаками для навчання будь-якої класичної моделі. На малих і середніх наборах даних квантово перетворені ознаки можуть покращити якість прогнозування порівняно з суто класичними базовими моделями.
Ця функція створена для таких користувачів:
-
Команди з науки про дані, які мають наявний конвеєр машинного навчання на малих і середніх табличних наборах даних, де якість прогнозування досягла плато. Ти додаєш Rimay як один додатковий крок попередньої обробки, не будуючи жодних квантових схем самостійно.
-
Дослідники, які вивчають квантові методи для задач машинного навчання.
Опис
Алгоритм квантового вилучення ознак [1] поєднує два принципи квантового машинного навчання. Перший — квантові карти ознак, які вбудовують дані у високовимірний гільбертів простір і тому дають виразніші представлення. Другий — квантові обчислення на резервуарі, які використовують динаміку квантової багаточастинкової системи як нелінійне перетворення вхідних даних.
Rimay кодує значення ознак і взаємну інформацію між ознаками в локальні поля та коефіцієнти зв'язку гамільтоніана спінового скла. Контрдіабатична квантова динаміка еволюціонує систему до її низькоенергетичних станів, які містять нелінійні суміші кореляцій у вхідних даних. Rimay вилучає ці кореляції, вимірюючи одно- та двочастинкові середні значення. Ці середні значення — це квантово перетворені ознаки, які ти подаєш у свою модель машинного навчання.
Робочий процес
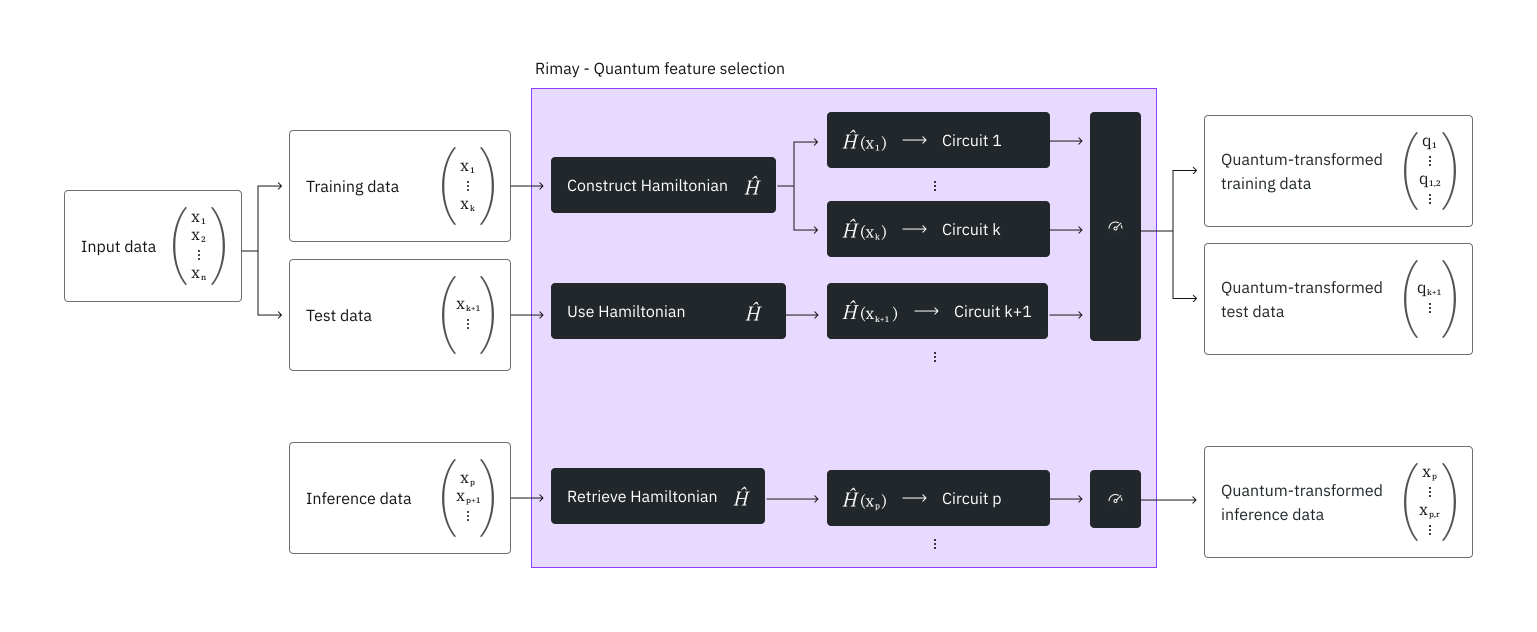
-
Попередньо обробити табличні дані так, як ти робиш для класичного машинного навчання. Rimay потребує числових ознак, тож перетвори категоріальні ознаки на числові, наприклад за допомогою
OneHotEncoderзі scikit-learn. -
Розділи дані на навчальну та тестову вибірки й завантаж обидві у функцію, як показано в розділі Приклад.
-
Rimay використовує навчальні дані, щоб побудувати гамільтоніан, який представляє дані. Кожна ознака відповідає одному кубіту, а повна навчальна вибірка визначає, які ознаки, а отже й кубіти, взаємодіють. Rimay зберігає цю структуру, щоб відображати тестові та пізніші дані для виведення за допомогою того самого гамільтоніана.
-
Для кожного зразка значення ознак задають локальні поля гамільтоніана, а взаємна інформація між ознаками задає коефіцієнти зв'язку структури з кроку 3. Rimay дигіталізує контрдіабатичну еволюцію цього гамільтоніана в схему й запускає схеми на QPU.
-
Rimay вимірює отримані бітові рядки, а потім обчислює одночастинкові середні значення та двочастинкові середні значення фізично зв'язаних кубітів.
-
Ти завантажуєш середні значення у вигляді, який можна подати безпосередньо у свою модель або об'єднати з початковими ознаками.
Через таку структуру кількість кубітів, потрібних для запуску, дорівнює кількості ознак, а кількість схем, які він надсилає, дорівнює кількості зразків.
Після підгонки відображення ти можеш пропускати через нього нові дані, наприклад для виведення. Тоді Rimay отримує гамільтоніан, створений під час підгонки, і будує з нього схеми для нових зразків.
Інтегруй Rimay у свій конвеєр машинного навчання
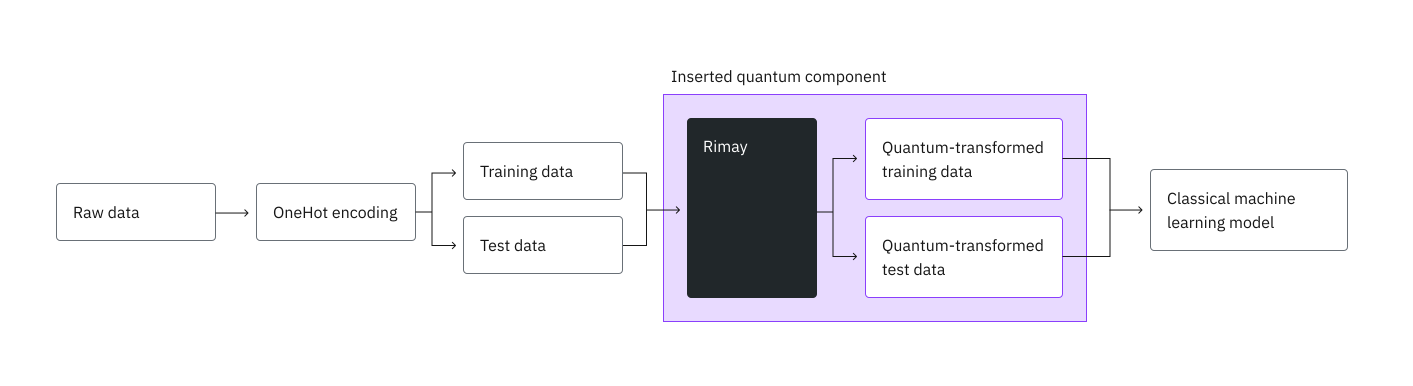
Як і в класичному конвеєрі, ти починаєш з попередньої обробки необроблених даних, наприклад за допомогою one-hot кодування категоріальних ознак, і розділяєш їх на навчальну та тестову вибірки. Замість того щоб подавати обидві вибірки безпосередньо у свою модель, ти спершу подаєш їх у Rimay і навчаєш модель на квантово перетворених ознаках.
Бенчмарки
Kipu Quantum протестувала Rimay на наборі даних German credit з OpenML [2], який класифікує 1000 кредитних заявників як добрих або поганих кредитних ризиків. Він має 13 категоріальних і сім числових атрибутів. One-hot кодування категоріальних атрибутів дає 48 числових ознак. У бенчмарку 20% зразків відкладено як тестову вибірку.
Як базову лінію було навчено кілька класичних моделей на класичних ознаках. З Rimay випадковий ліс навчали двома способами: лише на квантово перетворених ознаках (Random forest Q) і на квантово перетворених ознаках, об'єднаних з класичними (Random forest H, від hybrid). У таблиці наведено лише випадковий ліс, бо він показав найкращий результат на квантово перетворених ознаках.
| Модель | Ознаки | Точність (Accuracy) | AUC | F1 score | Precision | Recall |
|---|---|---|---|---|---|---|
| CatBoost | Класичні | 0.775 | 0.781 | 0.850 | 0.795 | 0.914 |
| Random forest | Класичні | 0.765 | 0.781 | 0.846 | 0.782 | 0.921 |
| XGBoost | Класичні | 0.760 | 0.758 | 0.835 | 0.803 | 0.871 |
| LightGBM | Класичні | 0.770 | 0.751 | 0.840 | 0.818 | 0.864 |
| Random forest Q | Квантові | 0.750 | 0.793 | 0.840 | 0.762 | 0.936 |
| Random forest H | Гібридні | 0.770 | 0.798 | 0.854 | 0.770 | 0.957 |
Гібридні ознаки покращують усі метрики випадкового лісу, крім precision, а гібридний випадковий ліс досягає вищих AUC, F1 score та recall, ніж CatBoost на класичних ознаках. Найбільший ефект стосується recall, який зростає з 0.921 до 0.957. Самі лише квантово перетворені ознаки не досягають precision класичних моделей.
Тестова вибірка містить лише 200 зразків, тож один додатково правильно передбачений зразок змінює точність на 0.005. Сприймай ці відмінності як тенденцію, що потребує подальшої перевірки, а не як значущий ефект. Точність прогнозування також може залежати від спричиненого обладнанням шуму у вилучених ознаках. Тому використовуй достатньо shots, щоб шум вибірки не обмежував результат.
У бенчмарку використано такі ресурси:
| Приклад | Кількість кубітів | Кількість зразків | Кількість shots | Загальний час (хв) | Використання QPU (хв) | Процесор |
|---|---|---|---|---|---|---|
| German credit | 48 | 1000 | 5000 | 23 | 22 | ibm_boston |
| German credit | 48 | 1000 | 5000 | 3 | 2 | ibm_phoenix |
Кількість зразків, яка дорівнює кількості схем, визначає час QPU. Використовуй тип процесора Nighthawk r2, бо він значно скорочує потрібний час QPU.
Вхідні дані
mode визначає, які параметри потрібні для запуску. Опис кожного вхідного параметра див. у довіднику API.
Вхідні файли
-
Завантаж кожен файл за допомогою
catalog.file_upload()перед запуском функції. -
Завантаження замінює будь-який раніший файл з тією самою назвою, навіть для завдання, яке ти надіслав, але яке ще не почалося. Щоб запускати кілька завдань одночасно, дай файлам кожного завдання власні назви, наприклад
run1_x_train.csvіrun2_x_train.csv. -
Кожен файл — це файл CSV із рядком заголовка. Кожен стовпець файлу ознак — це одна ознака, і кожне значення має бути числовим.
-
y_trainмістить рівно один числовий стовпець, з однією міткою на рядокx_train. Перетвори категоріальні мітки на числа, наприклад good і bad на 1 і 0. -
x_testіx_inferenceповинні мати ті самі стовпці, що йx_train, в тому самому порядку.
mapping_id — єдиний спосіб дістатися до відображення, створеного підгонкою, і його не можна знайти чи відновити. Він авторизує використання цього відображення, тож став до нього як до облікових даних і не поширюй. Якщо ти його втратиш, доведеться підганяти нове відображення, що коштує ще одного запуску на квантовому обладнанні. Також запиши backend_name підгонки, бо відображення працює лише на цьому процесорі.
Обмеження
-
Кожна ознака відображається на один кубіт, тож процесор повинен мати щонайменше стільки кубітів, скільки ознак у твоїх даних. Якщо ознак більше, спершу зменш їх технікою відбору ознак.
-
Кожен зразок стає однією схемою, а запуск враховує навчальні й тестові зразки разом. Запуск може містити щонайбільше 15 000 зразків.
-
Одне завдання може запросити щонайбільше 10 мільйонів виконань, тож кількість зразків, помножена на
shots, не повинна перевищувати 10 мільйонів. -
Завдання має завершитися протягом 24 годин, включно з часом очікування його схем у черзі процесора. Завдання, яке триває довше, зупиняється без результату. На завантаженому процесорі тримай великі набори даних значно нижче цих обмежень.
Вихідні дані
job.result() повертає словник. Самі квантово перетворені ознаки записуються у файли CSV, які ти завантажуєш за допомогою catalog.file_download(). Опис кожного ключа словника див. у довіднику API. Час, який забрала кожна фаза виконання, див. у розділі Метадані запуску.
Кожен вихідний файл містить один рядок на кожен вхідний рядок, у порядку вхідного файлу, і один стовпець на кожну квантово перетворену ознаку. Стовпці, назви яких починаються з corr_, — це двочастинкові середні значення. Файли не містять стовпця міток. Мітки твоїх навчальних даних залишаються у твоєму файлі y_train.
Метадані запуску
resource_usage містить один запис для кожної фази виконання, яку пройшов запуск: "RUNNING: MAPPING", "RUNNING: POST_PROCESSING" і, на QPU, зазвичай "RUNNING: WAITING_FOR_QPU". Кожен запис містить CPU_TIME, астрономічний час фази в секундах, і QPU_TIME, час QPU в секундах. На QPU час QPU, виставлений IBM до оплати, записується під "RUNNING: MAPPING", фазою, у якій виконувалися схеми.
"RUNNING: WAITING_FOR_QPU" — це час, який твої завдання чекали в черзі IBM. Запуск бере цей час із міток часу завдань IBM і не враховує його в "RUNNING: MAPPING". Якщо IBM не повідомляє ці мітки часу для кожного завдання, запис відсутній, а очікування входить до "RUNNING: MAPPING".
IBM® завершує обчислення використання через деякий час після завершення завдання. Запуск чекає на нього до приблизно хвилини. Використання, яке ще обчислюється після цього часу, не включається в QPU_TIME, а остаточне використання показано на IBM Quantum Platform. Якщо запуск не може прочитати використання від IBM, QPU_TIME дорівнює None.
Наприклад:
"metadata": {
    "version": "0.3.0",
    "resource_usage": {
        "RUNNING: MAPPING": {"CPU_TIME": 12.4, "QPU_TIME": 6.0},
        "RUNNING: WAITING_FOR_QPU": {"CPU_TIME": 28.8, "QPU_TIME": 0.0},
        "RUNNING: POST_PROCESSING": {"CPU_TIME": 0.3, "QPU_TIME": 0.0},
    },
}
Початок роботи
Автентифікуйся за допомогою свого ключа API IBM Quantum Platform і вибери Qiskit Function так:
Наведений нижче код припускає, що ти зберіг свої облікові дані. Якщо ні, виконай інструкції в розділі Встановлення клієнта Qiskit Functions Catalog, щоб зберегти свій обліковий запис разом із ключем API.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(kipu-quantum/rimay)]
# Access function
rimay = catalog.load("kipu-quantum/rimay")
Розміри функції
Кожне завдання виконується з одним розміром — S, M або L. Якщо вказаний розмір замалий, завдання відхиляється. Якщо розмір більший, ніж потрібно, завдання виконується на більшому обчислювальному профілі, ніж вимагає робота.
Розмір завдання Rimay залежить від кількості зразків, які воно відображає: рядки x_train і x_test для fit-transform та рядки x_inference для transform. Мітки в y_train не враховуються, а запуск delete не відображає жодних зразків.
| Розмір | Зразків на завдання | Обчислювальний профіль | vCPU | RAM |
|---|---|---|---|---|
S | До 2 999 | 8x32 | 8 | 32 ГБ |
M | Від 3 000 до 9 999 | 8x32 | 8 | 32 ГБ |
L | Від 10 000 до 15 000 | 16x128 | 16 | 128 ГБ |
Кількість зразків — єдиний критерій. Розмір змінює лише обчислювальний профіль: обмеження на ознаки, зразки та shots однакові для кожного розміру. S і M виконуються на одному обчислювальному профілі та відрізняються кількістю зразків, яку кожен охоплює.
Типовий розмір — M, він використовується, коли завдання не запитує розмір. Тому завдання з понад 9 999 зразками має запитати L.
Ти також можеш прочитати відповідність із самої функції через rimay.sizes_map, а розмір, з яким виконується завдання, коли воно його не запитує, — через rimay.default_size.
Обчисли розмір перед надсиланням
Запусти це на власних вхідних даних. Воно лише читає їх і більше нічого не робить: жодне завдання не надсилається і нічого не резервується, тож можеш викликати його скільки завгодно разів.
Передай самі набори даних, а не назви їхніх файлів, у тому самому порядку, що й input_file, разом із mode запуску. Крок 2 прикладу показує виклик.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Якщо розмір замалий, завдання завершується з помилкою 4600, і повідомлення називає розмір, який слід використати натомість. Якщо він більший, ніж потрібно, завдання виконується нормально і записує подію-повідомлення 4601.
Приклад
Цей приклад показує, як завантажити дані, запустити функцію та отримати квантово перетворені ознаки. Наскрізний приклад, що включає попередню обробку та навчання класичної моделі, див. в навчальному матеріалі.
1. Завантаж дані
Цей приклад використовує невеликий синтетичний набір даних із чотирма числовими ознаками та бінарною міткою, тож запуску потрібно лише чотири кубіти, і він швидко завершується. Наступна комірка записує його в чотири файли CSV: навчальні ознаки, навчальні мітки, тестові ознаки та ознаки для кроку 4 цього прикладу. Щоб використати власні дані, натомість запиши свої попередньо оброблені навчальну та тестову вибірки у файли з таким самим макетом.
from pathlib import Path

Path("x_train.csv").write_text("""f0,f1,f2,f3
0.7227,1.3355,1.9595,2.5562
0.2731,0.5779,0.8983,1.1624
0.1139,0.1817,0.2163,0.2426
0.0341,0.1311,0.0854,0.09
0.8996,1.6951,2.497,3.3407
0.9669,1.8906,2.7705,3.6569
0.6366,1.2821,1.8793,2.4602
0.7718,1.4979,2.2223,2.933
0.5465,1.1008,1.67,2.2195
0.9475,1.9423,2.8942,3.8199
0.8829,1.6842,2.4703,3.2865
0.0675,0.0365,0.0705,0.0162
""")
Path("y_train.csv").write_text("label\n1\n0\n0\n0\n1\n1\n0\n1\n0\n1\n1\n0\n")
Path("x_test.csv").write_text("""f0,f1,f2,f3
0.543,1.0786,1.5684,2.0607
0.9928,1.9037,2.9302,3.8422
0.2269,0.3637,0.4628,0.597
0.9896,1.9511,2.8913,3.8208
""")
Path("x_inference.csv").write_text("""f0,f1,f2,f3
0.2708,0.542,0.8506,1.0897
0.3585,0.6025,0.9517,1.2609
0.8871,1.6559,2.4577,3.2992
""")
95
Завантаж навчальні та тестові файли. Файл x_inference.csv ти завантажуєш на кроці 4.
for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
2. Запусти функцію
Обчисли розмір запуску за даними, які ти завантажив, за допомогою калькулятора з розділу Розміри функції.
import pandas as pd

x_train = pd.read_csv("x_train.csv")
y_train = pd.read_csv("y_train.csv")
x_test = pd.read_csv("x_test.csv")

size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Вибери процесор, що має щонайменше стільки кубітів, скільки ознак у твоїх даних, і запусти функцію в режимі fit-transform з цим розміром. Зразкові дані мають чотири ознаки, тож їх може виконати будь-який процесор IBM Quantum.
backend = catalog.least_busy(operational=True, simulator=False)

job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv", "x_test.csv"],
    backend_name=backend.name,
    shots=5000,
    function_size=size,
)
print(job.job_id)
85dabc9f-a769-4f4a-8e92-f3be73f85ca2
Перевір статус робочого навантаження або отримай результати так:
# Monitor the job status
job.status()
'DONE'
result = job.result()

# Keep both: the mapping_id is the only handle on the mapping this run
# fitted, and the mapping runs only on the processor it was fitted on.
mapping_id = result["mapping_id"]
fit_backend_name = result["backend_name"]
3. Отримай результати
Завантаж квантово перетворені ознаки. Передай target_name, щоб кожен файл зберігся під власною назвою.
for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
693iB [00:00, 171kiB/s]
254iB [00:00, 111kiB/s]
4. Відобрази нові дані
Після навчання моделі відобрази нові дані за допомогою підігнаного відображення, наприклад для виведення. Цей приклад відображає x_inference.csv, який записала перша комірка цього прикладу. Передай mapping_id, який повернула підгонка, щоб нові рядки відображалися тим самим відображенням, а не новим.
Відображення будується для розкладу кубітів одного процесора, тож передай той самий backend_name, що й у підгонці, який підгонка повернула в result["backend_name"]. Не використовуй least_busy() для вибору процесора, бо він може повернути інший. Rimay відхиляє будь-який інший процесор, перш ніж щось надішле. Кількість shots також береться з підгонки.
catalog.file_upload("x_inference.csv", rimay)

x_inference = pd.read_csv("x_inference.csv")
size = calculate_function_size([x_inference], mode="transform")

job = rimay.run(
    mode="transform",
    input_file=["x_inference.csv"],
    # The processor the mapping was fitted on
    backend_name=fit_backend_name,
    shots=5000,
    mapping_id=mapping_id,
    function_size=size,
)
# Monitor the job status
job.status()
'DONE'
result = job.result()

for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
202iB [00:00, 73.5kiB/s]
5. Видали відображення
Коли підігнане відображення тобі більше не потрібне, видали його. Запуск delete не виконує жодної квантової роботи, тому не потребує ні процесора, ні shots, ні розміру функції. Видалення неможливо скасувати. Після видалення mapping_id більше ні на що не вказує, і запуск transform із ним завершується помилкою.
job = rimay.run(mode="delete", mapping_id=mapping_id)
job.result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': '30L40joyUPYfnvgwo2d7MXXSzqvHkggR-Kzn81wfIYw',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Отримання повідомлень про помилки
Якщо статус твого робочого навантаження — ERROR, використай job.error_message(), щоб отримати повідомлення про помилку, так:
job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv"],
    backend_name=backend.name,
    shots=0,
)
job.error_message()
Кожна помилка, яку повідомляє Rimay, містить код із кодів помилок IBM Quantum, повідомлення та рішення, яке називає передане тобою значення і допустиме значення. У таблиці нижче наведено найпоширеніші помилки:
| Код | Причина |
|---|---|
1221 | Параметр відсутній або має неправильний тип, mode недійсний, файл, названий у input_file, не було завантажено, файли не відповідають одне одному, ознака не є числовою, або mapping_id не відповідає збереженому відображенню. |
1221 | Запуск "transform" вказує інший backend_name, ніж підгонка, що створила його відображення. |
1216 | Твій екземпляр не має процесора з переданим тобою backend_name. Рішення перелічує процесори, які в ньому є. |
1200 | Твій ключ API не має доступу до екземпляра, під яким виконується завдання. |
3200 | backend_name не починається з ibm_. |
4500 | Дані мають більше ознак, ніж процесор має кубітів. |
6000 | Кількість зразків, помножена на shots, перевищує 10 мільйонів виконань. |
6001 | shots менше за 1. |
6002 | Дані мають більше зразків, ніж дозволяє запуск. |
Сценарії використання
У табличній класифікації на малих і середніх наборах даних Kipu Quantum застосувала квантове вилучення ознак до такого:
Окрім табличних даних, заморожені нейронні мережі можуть перетворювати зображення на числові ознаки, які квантове вилучення ознак потім відображає в квантово перетворені ознаки:
Отримати підтримку
Для підтримки звернись на support@kipu-quantum.com.
Наступні кроки
-
Відвідай довідник API для цієї Qiskit Function.
-
Спробуй навчальний матеріал Класифікація кредитного ризику за допомогою квантового вилучення ознак Rimay від Kipu Quantum.
-
Ознайомся зі статтею Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
-
Ознайомся зі статтею Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.
Посилання
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.
Додаткова інформація
Rimay — слово мови кечуа, що означає «пояснювати».