Обмеження розмірності підпростору
У цьому покроковому прикладі ми покажемо вплив розмірності підпростору в техніці самоузгодженого відновлення конфігурацій.
A priori ми не знаємо, яка розмірність підпростору правильна для досягнення цільового рівня точності. Проте ми знаємо, що збільшення розмірності підпростору підвищує точність методу. Тому ми можемо дослідити точність передбачень як функцію розмірності підпростору. Задай молекулу та її властивості.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pyscf": "pyscf", "qiskit_addon_sqd": "qiskit-addon-sqd"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import warnings

import pyscf
import pyscf.cc
import pyscf.mcscf

warnings.filterwarnings("ignore")

# Specify molecule properties
open_shell = False
spin_sq = 0

# Build N2 molecule
mol = pyscf.gto.Mole()
mol.build(
    atom=[["N", (0, 0, 0)], ["N", (1.0, 0, 0)]],
    basis="6-31g",
    symmetry="Dooh",
)

# Define active space
n_frozen = 2
active_space = range(n_frozen, mol.nao_nr())

# Get molecular integrals
scf = pyscf.scf.RHF(mol).run()
num_orbitals = len(active_space)
n_electrons = int(sum(scf.mo_occ[active_space]))
num_elec_a = (n_electrons + mol.spin) // 2
num_elec_b = (n_electrons - mol.spin) // 2
cas = pyscf.mcscf.CASCI(scf, num_orbitals, (num_elec_a, num_elec_b))
mo = cas.sort_mo(active_space, base=0)
hcore, nuclear_repulsion_energy = cas.get_h1cas(mo)
eri = pyscf.ao2mo.restore(1, cas.get_h2cas(mo), num_orbitals)

# Compute exact energy
exact_energy = cas.run().e_tot
converged SCF energy = -108.835236570775
CASCI E = -109.046671778080  E(CI) = -32.8155692383188  S^2 = 0.0000000
Згенеруй кілька випадкових бітових рядків, щоб імітувати вибірки з QPU.
import numpy as np
from qiskit_addon_sqd.counts import generate_bit_array_uniform

# Create a seed to control randomness throughout this workflow
rng = np.random.default_rng(24)

# Generate random samples
bit_array = generate_bit_array_uniform(
    10_000, num_orbitals * 2, rand_seed=rng
)
Виклич SQD зі зростаючими розмірами пакетів.
from qiskit_addon_sqd.fermion import diagonalize_fermionic_hamiltonian

list_samples_per_batch = [50, 200, 400, 600]

# SQD options
max_iterations = 5

# Eigenstate solver options
num_batches = 10
max_davidson_cycles = 200

energies = []
subspace_dimensions = []

for samples_per_batch in list_samples_per_batch:
    result = diagonalize_fermionic_hamiltonian(
        hcore,
        eri,
        bit_array,
        samples_per_batch=samples_per_batch,
        norb=num_orbitals,
        nelec=(num_elec_a, num_elec_b),
        num_batches=num_batches,
        max_iterations=max_iterations,
        symmetrize_spin=True,
        seed=rng,
    )
    energies.append(result.energy)
    subspace_dimensions.append(np.prod(result.sci_state.amplitudes.shape))
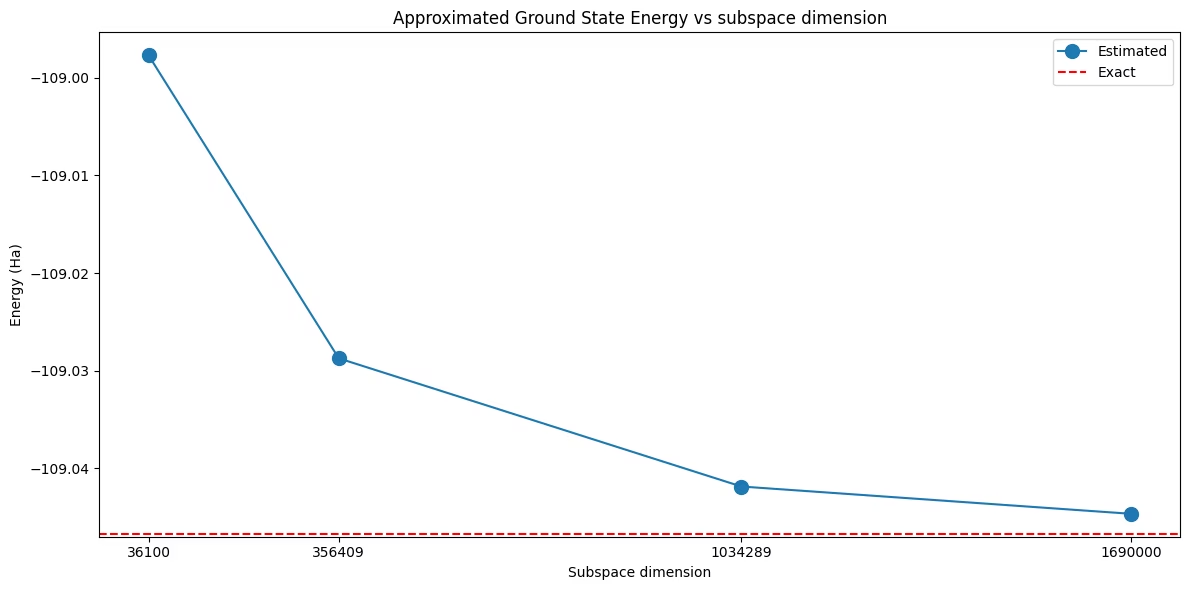
Цей графік показує, що збільшення розмірності підпростору веде до точніших результатів.
import matplotlib.pyplot as plt

# Data for energies plot
x1 = subspace_dimensions
y1 = np.array(energies) + nuclear_repulsion_energy

fig, axs = plt.subplots(1, 1, figsize=(12, 6))

# Plot energies
axs.plot(x1, y1, marker=".", markersize=20, label="Estimated")
axs.set_xticks(x1)
axs.set_xticklabels(x1)
axs.axhline(y=exact_energy, color="red", linestyle="--", label="Exact")
axs.set_title("Approximated Ground State Energy vs subspace dimension")
axs.set_xlabel("Subspace dimension")
axs.set_ylabel("Energy (Ha)")
axs.legend()

plt.tight_layout()
plt.show()
Явне обмеження за допомогою max_dim
У переборі вище розмірність підпростору контролювалася лише опосередковано. samples_per_batch задає, скільки бітових рядків береться в кожен пакет, але розмірність отриманого підпростору визначається тим, скільки різних рядків зі спіном альфа та спіном бета містять ці бітові рядки, а пул конфігурацій, доступних для підвибірки, зростає від однієї ітерації відновлення конфігурацій до наступної. Саме тому розмірності підпростору на горизонтальній осі вище є нерегулярними числами, які ми не обирали.
Аргумент max_dim функції diagonalize_fermionic_hamiltonian обмежує розмірність безпосередньо. Він обмежує кількість CI-рядків, що зберігаються в кожному спіновому секторі, а оскільки підпростір натягується на декартів добуток двох секторів, його розмірність дорівнює добутку розмірностей двох секторів:
-
max_dim=dобмежує обидва сектори доdрядків, тож розмірність підпростору не перевищуєd ** 2. -
max_dim=(d_a, d_b)обмежує сектори зі спіном альфа та спіном бета окремо, тож розмірність підпростору не перевищуєd_a * d_b. Колиsymmetrize_spin=True, обидва обмеження мають бути рівними. -
max_dim=None, значення за замовчуванням, не накладає обмежень.
Коли пакет містить більше рядків, ніж дозволяє обмеження, найменш важливі відкидаються: спочатку зберігаються рядки, передані через include_configurations, потім рядки, перенесені з попередньої ітерації (див. carryover_threshold), а решта місць заповнюється вибраними рядками в порядку спадання частоти, з якою вони траплялися у вибірці.
Оскільки max_dim обмежує розмір найбільшої діагоналізації, яку доведеться виконати розв'язувачу власних станів, це зручний спосіб утримати розв'язувач у межах бюджету часу виконання та пам'яті: обери щедре значення samples_per_batch і дозволь max_dim визначити, наскільки великим може стати підпростір.
Нижче ми повторюємо дослідження, цього разу зафіксувавши samples_per_batch і збільшуючи max_dim.
list_max_dim = [100, 200, 400, 800]

# Use a generous number of samples per batch, so that max_dim is what limits
# the dimension of the subspace
samples_per_batch = 600

energies_max_dim = []
subspace_dimensions_max_dim = []

for max_dim in list_max_dim:
    result = diagonalize_fermionic_hamiltonian(
        hcore,
        eri,
        bit_array,
        samples_per_batch=samples_per_batch,
        norb=num_orbitals,
        nelec=(num_elec_a, num_elec_b),
        num_batches=num_batches,
        max_iterations=max_iterations,
        symmetrize_spin=True,
        max_dim=max_dim,
        seed=rng,
    )
    energies_max_dim.append(result.energy)
    subspace_dimensions_max_dim.append(
        int(np.prod(result.sci_state.amplitudes.shape))
    )

print(f"max_dim:            {list_max_dim}")
print(f"subspace dimension: {subspace_dimensions_max_dim}")
max_dim:            [100, 200, 400, 800]
subspace dimension: [10000, 40000, 160000, 640000]
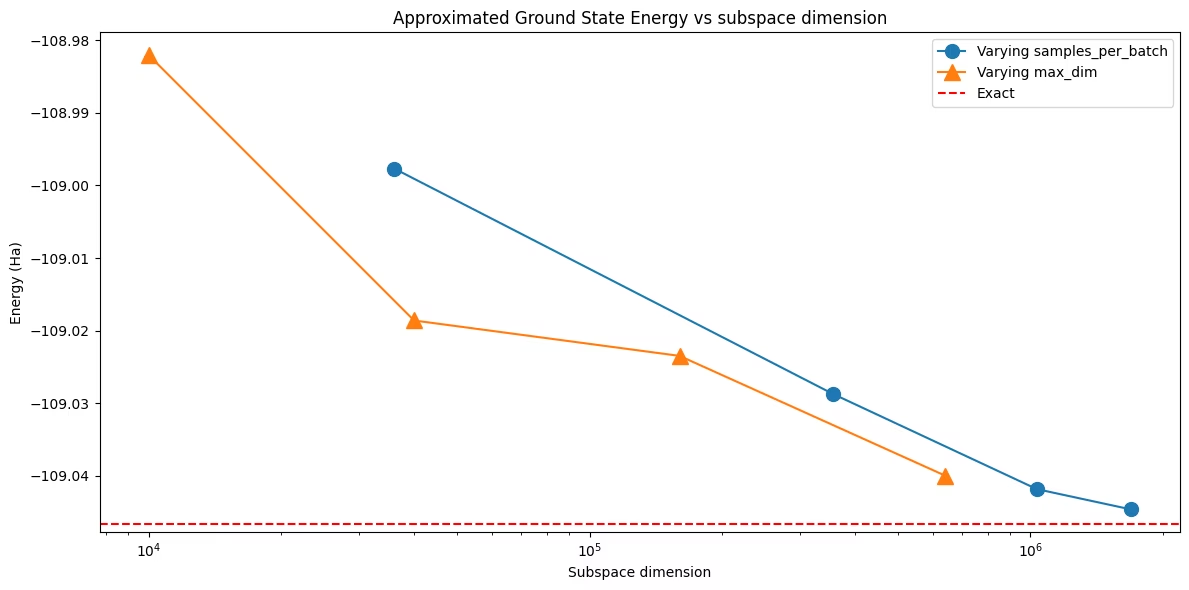
Розмірність підпростору тепер у кожному запуску точно дорівнює max_dim ** 2: її обрали, а не виявили. Побудова обох переборів на одному графіку показує, що точність визначається самою розмірністю підпростору, незалежно від того, за допомогою якого аргументу її було досягнуто. Проте дві криві не обов'язково збігаються точно. Запуски з max_dim беруть 600 бітових рядків на пакет, а потім залишають найчастіше вибрані рядки, тому за заданої розмірності вони можуть зберігати кращий набір конфігурацій, ніж запуск, що досяг цієї розмірності, взявши від початку менше бітових рядків.
fig, axs = plt.subplots(1, 1, figsize=(12, 6))

axs.plot(
    subspace_dimensions,
    np.array(energies) + nuclear_repulsion_energy,
    marker=".",
    markersize=20,
    label="Varying samples_per_batch",
)
axs.plot(
    subspace_dimensions_max_dim,
    np.array(energies_max_dim) + nuclear_repulsion_energy,
    marker="^",
    markersize=12,
    label="Varying max_dim",
)
axs.axhline(y=exact_energy, color="red", linestyle="--", label="Exact")
axs.set_xscale("log")
axs.ticklabel_format(axis="y", useOffset=False)
axs.set_title("Approximated Ground State Energy vs subspace dimension")
axs.set_xlabel("Subspace dimension")
axs.set_ylabel("Energy (Ha)")
axs.legend()

plt.tight_layout()
plt.show()