Навчання зашумлених квантових станів за допомогою класичних тіней
Оцінка використання: 34 хвилини на процесорі Heron r2 (ПРИМІТКА: це лише оцінка. Твій час виконання може відрізнятися.)
Результати навчання
-
Збирати рандомізовані вимірювання на квантовому процесорі IBM® з Julia та зберігати їх для подальшого аналізу
-
Перевіряти дані вимірювань на несправні кубіти та вентилі перед навчанням
-
Підганяти модель матричного добутку операторів (MPO) зашумленого стану до класичних тіней
-
Перевіряти модель на відкладених вимірюваннях і порівнювати її з ідеальною схемою
Передумови
-
Класичні тіні, як вони представлені в туторіалі Shadow tomography of the Greenberger-Horne-Zeilinger (GHZ) state
-
Матриці густини та змішані стани, розглянуті в Basics of quantum information
-
Запуск схем з Julia за допомогою
Qiskit.jlтаQiskitIBMRuntime.jl, представлений у туторіалі Simulate time evolution of the transverse-field Ising model
Передісторія
На реальному квантовому процесорі шум перетворює чистий стан , який схема має підготувати, на змішаний стан . Повна квантова томографія стану може відновити , але кількість потрібних вимірювань зростає експоненціально з кількістю кубітів. Votto та ін. [1] натомість навчили компактну модель до 96 кубітів за рандомізованими вимірюваннями. Цей туторіал слідує їхньому робочому процесу.
У рандомізованому вимірюванні [2] кожен кубіт повертається незалежним випадковим унітарним оператором і потім вимірюється в обчислювальному базисі. Один розіграш поворотів називається налаштуванням вимірювання, і кожне налаштування повторюється для шотів. Шот з вихідними бітами дає класичну тінь [3]
середнє якої за налаштуваннями та шотами дорівнює . Туторіал-передумова обирає кожен з трьох базисів Паулі; цей туторіал, як і стаття, обирає їх рівномірно з усіх однокубітних унітарних операторів (випадкових за Хааром), і та сама формула застосовується.
Тіні оцінюють властивості кількох кубітів одночасно. Стаття поєднує їх у матричний добуток операторів (MPO), який записує матрицю густини як ланцюжок малих тензорів, по одному на кубіт; зашумлені стани з короткосяжними кореляціями потребують лише малих зв'язків між сусідніми тензорами. Як і алгоритм ренормалізаційної групи матриці густини (DMRG), алгоритм навчання проходить уздовж ланцюжка та оновлює по одному тензору, так що модель узгоджується з тінями на вікні з кубітів, зосередженому на цьому тензорі (рівняння 4 статті). Розмірність зв'язку під час цих оновлень залишається фіксованою, тому алгоритм ніколи не обрізає модель. Оскільки дані входять лише через ці вікна, кількість потрібних налаштувань не зростає з довжиною ланцюжка.
Налаштування розділяються на навчальну та тестову вибірки. На тестовій вибірці стаття оцінює максимальну вірність між та моделлю ,
Пряме вимірювання потребувало б експоненційно багато вимірювань. Натомість стаття припускає умову наближеної факторизації (AFC): кореляції в згасають протягом кількох кубітів, тому глобальні перекриття та чистоти факторизуються на члени на блоках із сусідніх кубітів. Чистота також дає ентропію Реньї-2 , яка вимірює, наскільки змішаний стан.
Стаття готує кікнутий стан Ізінга глибини
на 96 кубітах ibm_brisbane, процесора Eagle, з 2 048 налаштуваннями по 1 024 шоти для . Рисунок 1(c,d) статті повідомляє два результати для :
-
Навчена модель досягає з експериментальним станом при , що значно перевищує перекриття ідеального стану з експериментом.
-
Ентропія зростає лінійно, , а ентропія моделі збігається з незалежною оцінкою за тестовою вибіркою.
Цей туторіал перевіряє обидва результати: спершу у восьмикубітній симуляції, де точні відповіді відомі, а потім у новому 96-кубітному запуску на ibm_fez, процесорі Heron r2. Алгоритм навчання — це незалежна реалізація рівнянь зі статті та її додатка мовою Julia.
Вимоги
Для цього туторіалу потрібна macOS або Linux, оскільки Qiskit.jl ще не підтримує Windows (Qiskit.jl issue #15). Також тобі потрібне таке:
-
Julia 1.11, зі сторінки завантаження Julia або за допомогою
juliaup add 1.11, та пакетIJulia:julia -e 'using Pkg; Pkg.add("IJulia")' -
Для прикладу на обладнанні потрібен обліковий запис IBM Quantum® Platform з доступом до QPU, що має щонайменше 96 кубітів, та збережені облікові дані. Без облікового запису ти можеш запустити приклад на обладнанні зі збережених вимірювань запуску на
ibm_fez, який дав результати в цьому туторіалі. Інші розділи працюють без облікового запису.
Ноутбук використовує Qiskit.jl та QiskitIBMRuntime.jl для побудови й запуску схем, RandomMeas.jl [4] для рандомізованих вимірювань (він також надає ITensors.jl та ITensorMPS.jl), а також NPZ.jl, JSON.jl і Plots.jl. Цей туторіал протестовано з Qiskit.jl 0.6.1, QiskitIBMRuntime.jl 0.3.2 та RandomMeas.jl 0.3.1.
Є два способи налаштувати середовище:
-
Варіант 1: встанови найновіші сумісні версії пакетів у тимчасове середовище. Запусти наступну комірку без змін.
-
Варіант 2: точно відтвори протестоване середовище. Встанови
download_toml_files = trueу наступній комірці. Комірка завантажуєProject.tomlтаManifest.tomlіз репозиторію документації у папкуenv_tutorial/classical-shadows/поруч із цим ноутбуком, а потім встановлює точну версію кожного пакета, записану в маніфесті, включно з непрямими залежностями. Подробиці дивись у документації Julia про ці файли.
using Pkg
using Downloads

download_toml_files = false

if !download_toml_files
    # Option 1: Install the latest compatible versions into a temporary environment
    Pkg.activate(mktempdir(); io=devnull)
    Pkg.add([
        PackageSpec(name="Qiskit", version="0.6"),
        PackageSpec(name="QiskitIBMRuntime", version="0.3"),
        PackageSpec(name="RandomMeas", version="0.3"),
        PackageSpec(name="NPZ"),
        PackageSpec(name="JSON"),
        PackageSpec(name="Plots"),
    ]; io=devnull)
else
    # Option 2: Install the exact tested versions recorded in Project.toml and Manifest.toml
    base_url = "https://raw.githubusercontent.com/Qiskit/documentation/main/docs/tutorials/assets/classical-shadows/julia"
    env_dir = joinpath(@__DIR__, "env_tutorial", "classical-shadows")
    mkpath(env_dir)
    for file in ("Project.toml", "Manifest.toml")
        Downloads.download("$base_url/$file", joinpath(env_dir, file))
    end
    Pkg.activate(env_dir; io=devnull)
    Pkg.instantiate(; io=devnull)
end
Налаштування
using RandomMeas  # also loads ITensors and ITensorMPS
using Qiskit, QiskitIBMRuntime
using Random, LinearAlgebra, Statistics
using Downloads, SHA, NPZ, JSON, Plots

# Download the helper module that implements the learner, unless a copy exists
docs_url = "https://raw.githubusercontent.com/Qiskit/documentation/main"
helper_file = joinpath(@__DIR__, "env_tutorial", "classical-shadows", "mpo_learning.jl")
if !isfile(helper_file)
    mkpath(dirname(helper_file))
    helper_url = "$docs_url/docs/tutorials/assets/classical-shadows/julia/mpo_learning.jl"
    Downloads.download(helper_url, helper_file)
end
include(helper_file)
using .ShadowMPOLearning
BLAS.set_num_threads(1)  # the learner multiplies many small matrices
Допоміжний модуль mpo_learning.jl, який завантажує комірка налаштування, реалізує алгоритм навчання. Туторіал викликає з нього такі функції:
| Функція | Призначення |
|---|---|
kicked_ising_reference(N, D; depolarization) | Точний MPO ідеального кікнутого стану Ізінга або стану після локального деполяризуючого шуму |
split_settings(group; seed, train_fraction) | Випадково розподіляє налаштування вимірювань на навчальну й тестову вибірки (за замовчуванням порівну) |
training_marginals(train; ell, prior) | Оцінки тіней кожного вікна навчання лише за навчальними налаштуваннями |
fitted_prior(ideal, train) | Апріорі для спільних рандомізованих вимірювань (CRM), підігнане до виміряної чистоти кожного вікна, як у статті |
learn_mpo(marginals, N; ell, maxbond, sweeps) | Проходить одноцентровим оновленням зі статті вздовж ланцюжка, починаючи з максимально змішаного стану |
max_fidelity(a, b), mpo_overlap(a, b) | Точні та між двома MPO |
afc_estimate, afc_statistics, afc_prefix_curve | Оцінки AFC для та за тестовими налаштуваннями з похибками методом складного ножа |
Алгоритм навчання зберігає MPO в базисі Паулі. Це робить модель ермітовою з одиничним слідом, але не змушує її бути додатно напіввизначеною, тому ноутбук повідомляє, наскільки від'ємними стають її власні значення.
Приклад малого масштабу на симуляторі
Почни із системи, достатньо малої, щоб усе обчислити точно: кікнутий стан Ізінга глибини один на восьми кубітах із 12% локальним деполяризуючим шумом, що моделює обладнання. Оскільки зашумлений стан відомий, ти можеш порівняти з ним навчену модель безпосередньо.
Крок 1: Відобразіть класичні входи на квантову задачу
Функція kicked_ising_reference повертає точний стан як MPO. При depolarization=0.12 вектор Блоха кожного кубіта зменшується на 12% після схеми.
N = 8
ideal = kicked_ising_reference(N, 1)
rho = kicked_ising_reference(N, 1; depolarization=0.12)
println("Purity of the noisy state: ", round(mpo_overlap(rho, rho), digits=3))
println("F_max between the noisy and ideal states: ", round(max_fidelity(rho, ideal), digits=3))
Purity of the noisy state: 0.327
F_max between the noisy and ideal states: 0.56
Крок 2: Оптимізуйте задачу для виконання на квантовому обладнанні
Цей приклад семплує результати вимірювань класично, тому немає схеми для транспіляції. Цей крок розглянуто в прикладі на обладнанні.
Крок 3: Виконайте за допомогою примітивів Qiskit
Використай RandomMeas.jl, щоб згенерувати 2 048 налаштувань вимірювань, випадкових за Хааром, і зробити по 256 шотів для кожного, а потім розділи налаштування порівну на навчальну й тестову вибірки. Розділяй за налаштуванням, а не за шотом: шоти з одного налаштування мають спільні повороти, тож вони не є незалежними.
Random.seed!(20260921)
sites = siteinds("Qubit", N)
settings = [LocalUnitaryMeasurementSetting(N; site_indices=sites, ensemble=Haar) for _ in 1:2048]
measurements = MeasurementGroup(to_itensor_mpo(rho, sites), settings, 256)
split = split_settings(measurements; seed=20260921)
println(length(split.train_ids), " training settings, ", length(split.test_ids), " testing settings")
1024 training settings,
1024 testing settings
Крок 4: Післяобробіть і поверніть результат у бажаному класичному форматі
Навчи модель з параметрами глибини один із статті: вікна, що розширюються на кубіти з кожного боку від оновлюваного тензора, віртуальна розмірність 4 і 20 проходів, починаючи з максимально змішаного стану. Перший прохід оновлює сусідні пари тензорів, що дозволяє віртуальній розмірності зрости від 1 до 4; кожен наступний прохід оновлює по одному тензору за раз за цієї фіксованої віртуальної розмірності.
Щоб зменшити статистичний шум тіней, у статті використовують спільні рандомізовані вимірювання (CRM) [5]. Для кожного налаштування від середньої тіні, яку створила б у цьому ж налаштуванні апріорна здогадка про стан, віднімають її саму, а потім додають назад точне значення апріорного стану. Поправка в середньому дорівнює нулю, тож апріорний стан змінює розмір статистичної похибки, але не те, що оцінюється. Тут апріорний стан — це ідеальний стан із 10% локальної деполяризації, що близько до справжніх 12%. На апаратному забезпеченні рівень шуму невідомий, тому в апаратному прикладі апріорний стан підганяють під виміряні чистоти, як і в статті.
prior = kicked_ising_reference(N, 1; depolarization=0.10)
marginals = training_marginals(split.train; ell=2, prior)
fit = learn_mpo(marginals, N; ell=2, maxbond=4, sweeps=20)
sigma = fit.model
plot([h.sweep for h in fit.history], [h.local_loss for h in fit.history];
    xlabel="sweep", ylabel="mean squared residual", label="training windows",
    size=(680, 320), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
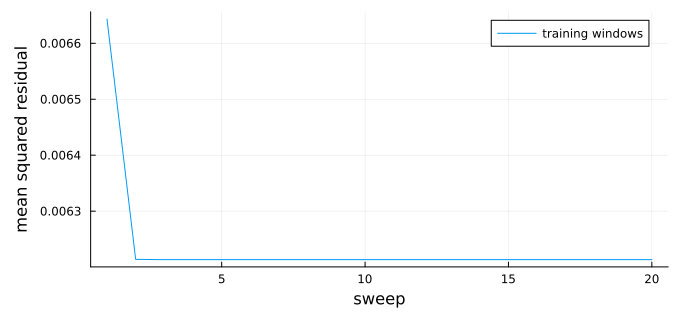
Нев'язка вимірює, наскільки вікна моделі відрізняються від тренувальних тіней. Вона спадає, коли у другому проході починаються одновузлові оновлення, а потім залишається приблизно сталою замість того, щоб досягти нуля, бо тіні містять статистичний шум, який модель з малою віртуальною розмірністю відтворити не може.
Оскільки цей стан відомий, ти можеш точно порівняти з ним навчену модель, а також порівняти з ним дві найпростіші здогадки: апріорний стан CRM та ідеальний стан.
eigenvalues = eigvals(Hermitian(dense_operator(sigma)))
println("F_max with the noisy state")
println("  learned model: ", round(max_fidelity(rho, sigma), digits=3))
println("  CRM prior:     ", round(max_fidelity(rho, prior), digits=3))
println("  ideal state:   ", round(max_fidelity(rho, ideal), digits=3))
println("Most negative eigenvalue of the model: ", round(minimum(eigenvalues), digits=4))
println("Total negative eigenvalue weight:      ", round(-sum(min.(eigenvalues, 0)), digits=4))
F_max with the noisy state
learned model: 0.993
  CRM prior:     0.911
  ideal state:   0.56
Most negative eigenvalue of the model: -0.0076
Total negative eigenvalue weight:      0.0348
Навчена модель ближча до зашумленого стану, ніж апріорний чи ідеальний стан, тож вона навчилася шуму з даних. Її невеликі від'ємні власні значення виникають через скінченну кількість вимірювань.
На апаратному забезпеченні стан невідомий, тож ти оцінюєш натомість за тестовими налаштуваннями. AFC розбиває ланцюжок на блоки по кубітів і наближує чистоту за формулою
а — таким самим відношенням локальних перекриттів. За два блоки охоплюють усі вісім кубітів, і формула точна; за вона спирається на припущення про факторизацію. Похибки джекнайфа, які виключають по одному тестовому налаштуванню, охоплюють лише статистичну похибку тестових даних, а не випадковість тренування чи наближення AFC.
for k in (2, 4)
    estimate = afc_estimate(sigma, split.test; k, statistics=afc_statistics(split.test, k; prior))
    println("k = $k: held-out F_max = ", round(estimate.fidelity, digits=3), " ± ",
        round(estimate.fidelity_sem, digits=3))
end
println("Exact F_max:              ", round(max_fidelity(rho, sigma), digits=3))
k = 2: held-out F_max = 0.966
± 0.036
k = 4: held-out F_max =
0.958 ± 0.049
Exact F_max:              0.993
Обидві оцінки на відкладених даних збігаються з точним значенням у межах своїх похибок.
Великомасштабний апаратний приклад
Тепер запусти експеримент на 96-кубітному ланцюжку ibm_fez — процесора Heron r2. Як і ibm_brisbane, він має карту зв'язків heavy-hex і подібний рівень шуму.
Збір даних потребує 1 024 завдань Sampler і приблизно 34 хвилин часу QPU. Якщо ти не маєш доступу до QPU щонайменше з 96 кубітами або черга довга, запусти апаратний приклад на вимірюваннях, записаних на ibm_fez 27 вересня 2026 року, які дали результати, показані в цьому посібнику. З use_saved_data = true ноутбук завантажує ці вимірювання (15 МБ) із Zenodo [6] на кроці 1 і пропускає надсилання завдань на кроці 3. Щоб зібрати власні дані, встанови false.
use_saved_data = true; # set to false to collect new measurements on hardware
Крок 1: Відобразіть класичні вхідні дані на квантову задачу
Кожне налаштування потребує однієї схеми: схеми kicked-Ising, вентиля на кожному кубіті для та вимірювання кожного кубіта. Вибірка , де , і рівномірні на , робить випадковою за мірою Хаара. Функція u3_matrix повертає матрицю , яку використовує крок 4.
Бюджет становить 1 024 налаштування по 1 024 вимірювання, тобто вдвічі менше налаштувань, ніж у статті, порівну розділених між тренуванням і тестуванням. Із збереженими даними комірка завантажує записані кути. Інакше вона генерує нові кути і зберігає їх до того, як ти щось надішлеш, бо без них не можна проаналізувати результати. Якщо файл уже існує, комірка завантажує його, щоб кути й далі відповідали збереженим результатам після перезапуску сесії.
"Matrix of the U(θ, ϕ, λ) gate, as used by `qc.u` in Qiskit."
u3_matrix(θ, ϕ, λ) = [cos(θ/2)              -exp(im*λ)*sin(θ/2);
                      exp(im*ϕ)*sin(θ/2)    exp(im*(ϕ + λ))*cos(θ/2)]

"Angles (θ, ϕ, λ) for which `u3_matrix(θ, ϕ, λ)` is a Haar-random unitary."
random_u3_angles() = (2asin(sqrt(rand())), 2π*rand(), 2π*rand())

N_hw, NU_hw, NM_hw = 96, 1024, 1024
data_directory = joinpath(@__DIR__, "classical-shadows-data")
saved_file = joinpath(data_directory, "ibm-fez-run.npz")
run_directory = joinpath(data_directory, "new-run")
settings_file = joinpath(run_directory, "settings.npz")
if use_saved_data
    saved_url = "https://zenodo.org/records/24116174/files/ibm-fez-run.npz?download=1"
    saved_sha256 = "c42f4d8d42e5083e9e152b4fec0846884ebe3be003e5ab528deebf4f00c9fe50"
    if !isfile(saved_file)
        mkpath(data_directory)
        println("Downloading the saved ibm_fez run (15 MB)...")
        Downloads.download(saved_url, saved_file * ".part")
        mv(saved_file * ".part", saved_file)
    end
    bytes2hex(open(sha256, saved_file)) == saved_sha256 ||
        error("$saved_file is incomplete or corrupted; delete it and run this cell again")
    saved_run = npzread(saved_file)
    angles = saved_run["angles"]
elseif isfile(settings_file)
    angles = npzread(settings_file)["angles"]
else
    mkpath(joinpath(run_directory, "outcomes"))
    Random.seed!(20260927)
    angles = Array{Float64}(undef, NU_hw, N_hw, 3)
    for r in 1:NU_hw, i in 1:N_hw
        angles[r, i, :] .= random_u3_angles()
    end
    npzwrite(settings_file, Dict("angles" => angles))
end
println("Measurement settings: ", size(angles, 1), " × ", size(angles, 2), " qubits")
Measurement settings: 1024
× 96 qubits
Крок 2: Оптимізуйте задачу для виконання на квантовому апаратному забезпеченні
Ланцюжок настільки хороший, наскільки хороший його найгірший кубіт, тому обери 96 фізичних кубітів самостійно. Функція transpile з Qiskit.jl поки що не приймає фіксованого початкового розташування, а в тесті на ibm_phoenix обране нею розташування містило кубіт із 51% похибкою зчитування. Наведений нижче ланцюжок — це 96-кубітний шлях у карті зв'язків ibm_fez, який вибрало розташування з урахуванням похибок функції transpile з Python Qiskit (з optimization_level=3) за даними калібрування від 27 вересня 2026 року. Його середня похибка зчитування становить 1,6%, але в ґратці heavy-hex мало 96-кубітних шляхів, і цей включає кубіт 35 із 15% похибкою зчитування. Калібрування змінюються, тож перш ніж запускати в інший день чи на іншому QPU, обери новий ланцюжок із актуальних даних калібрування.
Щоб зберегти цей ланцюжок, записуй схеми одразу в рідних вентилях замість транспілювання. Вентиль дорівнює з точністю до глобальної фази. Цей розклад охоплює і випадкові обертання, і удар . Вентиль дорівнює вентилю CZ, за яким на обох кубітах іде , з точністю до глобальної фази. Оскільки ці вентилі діагональні, вони комутують з вентилями CZ, тож кожен кубіт накопичує по одному на зв'язок перед своїм обертанням для вимірювання.
num_device_qubits = 156
# Physical qubits of ibm_fez, in IBM numbering, forming the chain
chain_physical = [
    2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 19, 35, 34, 33, 39, 53, 54, 55, 59, 75, 74,
    73, 79, 93, 94, 95, 99, 115, 114, 113, 119, 133, 132, 131, 130, 129, 128, 127, 137, 147, 146,
    145, 144, 143, 136, 123, 124, 125, 117, 105, 106, 107, 108, 109, 110, 111, 98, 91, 90, 89,
    88, 87, 86, 85, 77, 65, 66, 67, 68, 69, 70, 71, 58, 51, 50, 49, 48, 47, 46, 45, 37, 25, 24,
    23, 22, 21, 36, 41, 42, 43, 56, 63]
chain = chain_physical .+ 1  # Qiskit.jl numbers qubits from 1

"Apply U(θ, ϕ, λ) to qubit q with native gates: rz(λ), sx, rz(θ + π), sx, rz(ϕ + π)."
function native_u!(qc, q, θ, ϕ, λ)
    qc.rz(λ, q)
    qc.sx(q)
    qc.rz(θ + π, q)
    qc.sx(q)
    qc.rz(ϕ + π, q)
end

"Kicked-Ising circuit on `chain`, then the rotations of one setting and a measurement."
function native_setting_circuit(chain, angles, num_device_qubits)
    n = length(chain)
    qc = QuantumCircuit(num_device_qubits, n)
    for q in chain
        native_u!(qc, q, π/4, -π/2, π/2)       # e^{-iπ/8 X}
    end
    for i in 1:n-1
        qc.cz(chain[i], chain[i + 1])          # e^{iπ/4 ZZ}, up to the S† gates below
    end
    for (i, q) in enumerate(chain)
        bonds = (i > 1) + (i < n)
        qc.rz(-π/2 * bonds, q)                 # one S† per bond
        native_u!(qc, q, angles[i, 1], angles[i, 2], angles[i, 3])
        qc.measure(q, i)                       # outcome of chain qubit i goes to bit i
    end
    qc
end

circuits = [native_setting_circuit(chain, angles[r, :, :], num_device_qubits) for r in 1:NU_hw]
println(length(circuits), " circuits, each with ", count(inst -> inst.name == "cz", circuits[1].data), " CZ gates")
1024 circuits, each with
95 CZ gates
Крок 3: Виконайте за допомогою примітивів Qiskit
QiskitIBMRuntime.jl запускає одну схему на завдання Sampler, тож для збору даних потрібно 1 024 завдання. Наступна комірка тримає в черзі до 32 завдань і зберігає результати кожного налаштування, щойно його завдання завершується. Кожне вимірювання повертається як вектор бітів, у якому елемент — результат кубіта ланцюжка.
Ти маєш отримати результати в тій самій сесії, що надіслала завдання, бо QiskitIBMRuntime.jl поки що не вміє шукати завдання за його ID (qiskit-ibm-runtime-c issue #28). Якщо завдання завершується помилкою, комірка видає попередження і продовжує. Якщо сесія зупиниться, запусти кроки з 1 по 3 знову. Повторний запуск комірки надсилає лише ті налаштування, результатів яких бракує. З use_saved_data = true комірка нічого не надсилає.
outcome_file(r) = joinpath(run_directory, "outcomes", "setting_$(lpad(r, 4, '0')).npz")

"Save the outcomes of setting `r` as a (shots × N) matrix of 0/1 values."
function save_outcomes(r, job)
    try
        samples = get_sampler_job_results(job, service)
        bits = UInt8.(permutedims(reduce(hcat, samples)))
        npzwrite(outcome_file(r), Dict("bits" => bits))
    catch err
        @warn "Setting $r failed and was not saved; run this cell again to resubmit it" err
    end
end

if use_saved_data
    println("Using the saved ibm_fez measurements; no jobs submitted")
else
    backend_name = "ibm_fez"
    service = Service()  # uses the credentials saved on this computer
    backend = only(b for b in backend_search(service) if b.name == backend_name)
    open(joinpath(run_directory, "metadata.json"), "w") do io
        JSON.print(io, Dict("backend" => backend_name, "N" => N_hw, "depth" => 1, "settings" => NU_hw,
                            "shots" => NM_hw, "chain" => chain_physical), 2)
    end
    in_flight = []
    for r in 1:NU_hw
        isfile(outcome_file(r)) && continue
        push!(in_flight, (r, run_sampler_job(service, backend, circuits[r], NM_hw)))
        length(in_flight) >= 32 && save_outcomes(popfirst!(in_flight)...)
    end
    foreach(job -> save_outcomes(job...), in_flight)
    println("Saved outcomes: ", count(r -> isfile(outcome_file(r)), 1:NU_hw), " of ", NU_hw, " settings")
end
Using the saved ibm_fez measurements; no jobs submitted
Крок 4: Обробіть результат і поверніть його в потрібному класичному форматі
Цей крок читає лише збережені дані: завантажений запуск ibm_fez, якщо use_saved_data дорівнює true, або інакше файли, які записав крок 3. Тому ти можеш запускати його в новій сесії без надсилання завдань (спершу запусти комірку Setup, комірку use_saved_data і крок 1). Завантажений файл зберігає 96 результатів кожного вимірювання, упакованих у 12 байтів, старшим бітом уперед, тож завантажувач їх розпаковує. RandomMeas.jl позначає результати 1 і 2, тому завантажувач також додає 1 до кожного біта.
"Build a `MeasurementGroup` from the angles and a function `outcomes(r)` that returns
the (shots × N) 0/1 outcomes of setting `r`."
function measurement_group(angles, outcomes)
    settings_count, n = size(angles, 1), size(angles, 2)
    sites = siteinds("Qubit", n)
    data = map(1:settings_count) do r
        rotations = Array{ComplexF64}(undef, n, 2, 2)
        for i in 1:n
            rotations[i, :, :] = u3_matrix(angles[r, i, :]...)
        end
        MeasurementData(Int.(outcomes(r)) .+ 1;
            measurement_setting=LocalUnitaryMeasurementSetting(rotations; site_indices=sites))
    end
    MeasurementGroup(data)
end

if use_saved_data
    packed = saved_run["outcomes"]  # settings × shots × 12 bytes
    # Bit i of a shot is in byte (i - 1) ÷ 8 + 1, most significant bit first
    unpack(r) = [(packed[r, s, (i - 1) ÷ 8 + 1] >> (7 - (i - 1) % 8)) & 0x01
                 for s in 1:size(packed, 2), i in 1:N_hw]
    group_hw = measurement_group(angles, unpack)
else
    group_hw = measurement_group(angles, r -> npzread(outcome_file(r))["bits"])
end
println(group_hw.NU, " settings × ", group_hw.NM, " shots on ", group_hw.N, " qubits")
1024 settings ×
1024 shots on 96 qubits
Перед навчанням перевір дані. Зламаний кубіт або погано відкалібрований вентиль робить виміряний стан навколо себе значно більш змішаним і може призвести до розбіжності навчання. Чистота кількох сусідніх кубітів — це безмодельний еталон такого шуму: функція get_purity з RandomMeas.jl оцінює для підсистеми , порівнюючи пари вимірювань з того самого налаштування. Обчисли ентропію Реньї-2 кожного вікна з шести сусідніх кубітів і порівняй її з тим самим вікном ідеального стану. Ідеальне значення не дорівнює нулю, бо кожне вікно заплутане з рештою ланцюжка; шум збільшує його, а зламаний кубіт підштовхує кожне вікно, що його містить, до максимуму в шість.
ideal_hw = kicked_ising_reference(N_hw, 1)
width = 6
starts = 1:N_hw - width + 1
window_entropy(rho, w) = -log2(mpo_overlap(segment_mpo(rho, w), segment_mpo(rho, w)))
measured_entropy = [-log2(get_purity(group_hw, collect(j:j + width - 1))) for j in starts]
ideal_entropy = [window_entropy(ideal_hw, j:j + width - 1) for j in starts]
worst = argmax(measured_entropy)
println("S₂ of six-qubit windows: median ", round(median(measured_entropy), digits=2), "; highest ",
    round(measured_entropy[worst], digits=2), " (chain positions ", worst, " to ", worst + width - 1, ")")
println("Ideal state: ", round(minimum(ideal_entropy), digits=2), " to ", round(maximum(ideal_entropy), digits=2))
plot(starts, measured_entropy; marker=:circle, markersize=2, label="measured",
    xlabel="first chain position of the window", ylabel="S₂ of six qubits", ylims=(0, width),
    legend=:topright, size=(800, 280), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
plot!(starts, ideal_entropy; linestyle=:dash, label="ideal state")
S₂ of six-qubit windows: median 0.9
; highest 1.43 (chain positions 30 to 35)
Ideal state: 0.19 to 0.39
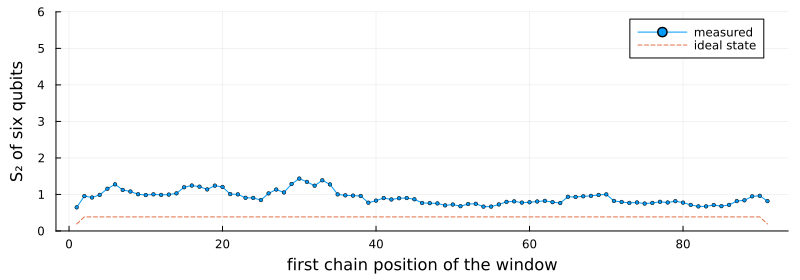
Кожне вікно більш змішане, ніж ідеальний стан, приблизно на півбіта–біт, а найшумніша ділянка розташована навколо позицій ланцюжка від 30 до 35. Жодне вікно не наближається до максимуму в шість, тож жоден кубіт не зламаний, і аналіз використовує весь 96-кубітний ланцюжок. Якби деякі вікна мали ентропію, близьку до шести, ти б видалив кубіт, спільний для цих вікон, і навчав найдовшу частину ланцюжка без нього.
Ті самі чистоти визначають апріорний стан CRM. Для кожного вікна fitted_prior бере ідеальний стан і підганяє силу локальної деполяризації так, щоб його чистота збігалася з чистотою, виміряною в тренувальних налаштуваннях, як і в статті.
Функція learn_and_validate у наступній комірці виконує решту аналізу. Вона навчає модель за тренувальними налаштуваннями, а потім оцінює і за тестовими налаштуваннями для перших кубітів ланцюжка з кроком 12. Це величини з рис. 1(c,d) статті. Ідеальний стан обчислюється на тих самих тестових даних як базовий рівень.
Комірка запускає функцію з , а потім повторює її з і , щоб побачити, наскільки важить розмір навчальних вікон. Віртуальна розмірність може бути щонайбільше , тож навчає добутковий стан: кожен кубіт окремо, без кореляцій між кубітами.
function learn_and_validate(group; ideal, ell=2, k=3, sizes=12:12:group.N, seed=20260921, train_fraction=0.5)
    split = split_settings(group; seed, train_fraction)
    prior = fitted_prior(ideal, split.train)
    marginals = training_marginals(split.train; ell, prior)
    fit = learn_mpo(marginals, group.N; ell, maxbond=min(4, 4^ell), sweeps=20)
    last(fit.history).purity <= 1 ||
        @warn "The model has purity above one, so the fit diverged. Collect more settings or shots."
    statistics = afc_statistics(split.test, k; prior)
    learned = afc_prefix_curve(fit.model, statistics, split.test.NU; k, sizes)
    baseline = afc_prefix_curve(ideal, statistics, split.test.NU; k, sizes)
    model_entropy = [-log2(mpo_overlap(prefix_mpo(fit.model, n), prefix_mpo(fit.model, n))) for n in sizes]
    (; ell, fit, split, learned, baseline, model_entropy)
end

function plot_validation(results, title)
    n = [r.n for r in first(results).learned]
    # Marker, size, and line style per ℓ. The ℓ = 1 squares are small enough to sit inside the
    # ℓ = 2 circles, so both stay visible where the two curves overlap.
    style = Dict(2 => (:circle, 7, :solid), 1 => (:rect, 3.5, :dash), 0 => (:utriangle, 5, :dot))
    fidelity = plot(yscale=:log10, ylims=(1e-6, 1.5), legend=:bottomleft, xlabel="number of qubits N",
        ylabel="held-out F_max", title=title)
    entropy = plot(xlabel="number of qubits N", ylabel="Rényi-2 entropy S₂", legend=:topleft)
    held_out = first(results).learned
    # Draw every error bar before any marker, so the bars stay behind the symbols
    for (color, result) in enumerate(results)
        scatter!(fidelity, n, [r.fidelity for r in result.learned]; yerror=[r.fidelity_sem for r in result.learned],
            markersize=0, markerstrokecolor=color, label="")
    end
    scatter!(entropy, n, [r.entropy for r in held_out]; yerror=[r.entropy_sem for r in held_out],
        markersize=0, markerstrokecolor=:black, label="")
    for (color, result) in enumerate(results)
        marker, markersize, linestyle = style[result.ell]
        label = "learned model, ℓ = $(result.ell)"
        plot!(fidelity, n, [r.fidelity for r in result.learned]; color, marker, markersize, linestyle,
            markerstrokewidth=0, label)
        plot!(entropy, n, result.model_entropy; color, linestyle, linewidth=2, label)
    end
    plot!(fidelity, n, [r.fidelity for r in first(results).baseline]; marker=:diamond, markersize=5,
        linestyle=:dashdot, color=:black, label="ideal state")
    scatter!(entropy, n, [r.entropy for r in held_out]; marker=:circle, markersize=4, color=:black,
        label="held-out AFC estimate")
    plot(fidelity, entropy; layout=(1, 2), size=(1000, 400), left_margin=7Plots.mm, bottom_margin=7Plots.mm)
end

function summarize(result)
    final = last(result.learned)
    println("ℓ = ", result.ell, ", N = ", final.n, ": held-out F_max = ", round(final.fidelity, sigdigits=3), " ± ",
        round(final.fidelity_sem, sigdigits=2), " (ideal state: ", round(last(result.baseline).fidelity, sigdigits=2), ")")
    println("  S₂ = ", round(final.entropy, digits=2), " ± ", round(final.entropy_sem, digits=2),
        " held out; ", round(last(result.model_entropy), digits=2), " from the model")
    lowest = minimum(minimum(eigvals(Hermitian(operator_from_coefficients(local_coefficients(result.fit.model, w)))))
                     for w in unique(learning_windows(final.n, max(result.ell, 1))))
    println("  Most negative eigenvalue in any learning window: ", round(lowest, digits=4))
end

results_hw = [learn_and_validate(group_hw; ideal=ideal_hw, ell) for ell in (2, 1, 0)]
foreach(summarize, results_hw)
plot_validation(results_hw, "ibm_fez, 96-qubit chain")
ℓ = 2
, N = 96: held-out F_max = 0.591 ± 0.1 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.21 from the model
  Most negative eigenvalue in any learning window: -0.0523
ℓ = 1, N = 96: held-out F_max = 0.554 ± 0.094 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.26 from the model
  Most negative eigenvalue in any learning window: -0.0215
ℓ = 0, N = 96: held-out F_max = 6.18e-6 ± 1.1e-6 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 32.01 from the model
  Most negative eigenvalue in any learning window: 0.0012
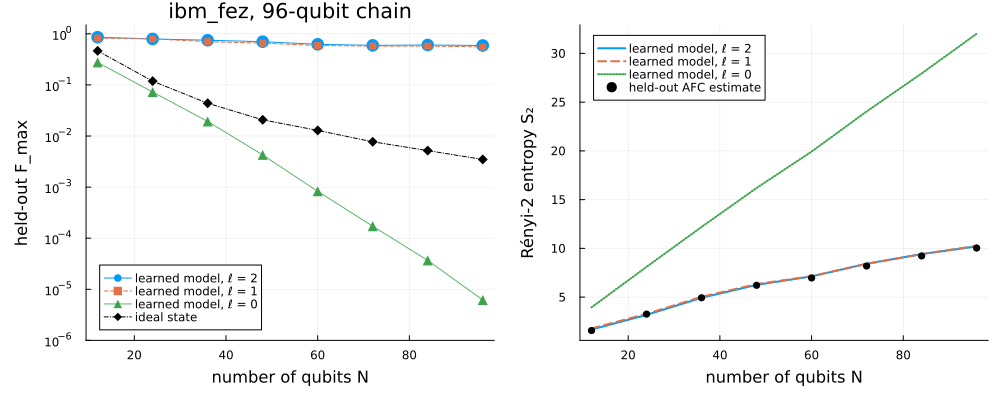
Результати відтворюють обидва твердження статті на іншому процесорі:
-
Модель описує дані значно краще, ніж ідеальний стан. За значення моделі з на відкладених даних становить 0,59 ± 0,10 проти 0,0035 для ідеального стану. У статті повідомляють про приблизно 0,75 на
ibm_brisbane. -
Ентропія моделі узгоджується з тестовими даними за кожного . За вона становить 10,2 за моделлю і 10,0 ± 0,3 за тестовими даними, тобто , порівняно з 0,14–0,15 на старішому
ibm_brisbane.
Порівняння розмірів вікон показує, де міститься інформація. З модель майже така ж хороша (), тож для цих даних кореляції за межами кількох кубітів додають мало. З добутковий стан не враховує заплутаність між сусідніми кубітами: його ентропія зростає до 32 замість 10, а падає ще швидше, ніж в ідеального стану, до за .
Пам'ятай про такі обмеження, коли читаєш ці числа:
-
Розбиття на тренування. Похибки охоплюють лише статистичну похибку тестових даних. Інші випадкові розбиття тих самих налаштувань дають від 0,49 до 0,59 за для .
-
Останній прохід. Навчальник завжди повертає модель з останнього проходу, тож тестові дані ніколи не впливають на модель.
-
Додатність. Модель не обмежена бути додатно напіввизначеною; її найбільш від'ємне власне значення у навчальному вікні становить приблизно . Тому її і описують оператор, а не засвідчені властивості фізичного стану.
-
Факторизація. Кожна оцінка на відкладених даних спирається на припущення AFC, яке самі вимірювання засвідчити не можуть.
Наступні кроки
-
Повтори експеримент на глибині два з параметрами статті для цієї глибини ( і максимальна віртуальна розмірність 8) та визнач, скільки налаштувань вимірювання потрібно навчальнику.
-
Навчай із двовузловим оновленням замість цього (
update=:two_siteуtraining_marginalsіlearn_mpo), яке обрізає віртуальну розмірність після кожного кроку, і подивись, як воно поводиться з меншою кількістю тренувальних налаштувань. -
Навчай без апріорного стану CRM (
prior=nothing) і порівняй точність на відкладених даних. -
Застосуй той самий аналіз до опублікованих авторами вимірювань
ibm_brisbane. -
Прочитай додаток до статті, щоб побачити виведення оновлення та оцінювачів AFC.
-
Дослідж інші протоколи рандомізованих вимірювань у прикладах
RandomMeas.jl.
Література
-
M. Votto, M. Ljubotina, C. Lancien, J. I. Cirac, P. Zoller, M. Serbyn, L. Piroli, and B. Vermersch, "Learning mixed quantum states in large-scale experiments", Phys. Rev. Lett. 136, 090801 (2026). arXiv:2507.12550
-
A. Elben, S. T. Flammia, H.-Y. Huang, R. Kueng, J. Preskill, B. Vermersch, and P. Zoller, "The randomized measurement toolbox", Nat. Rev. Phys. 5, 9 (2023). arXiv:2203.11374
-
H.-Y. Huang, R. Kueng, and J. Preskill, "Predicting many properties of a quantum system from very few measurements", Nat. Phys. 16, 1050 (2020). arXiv:2002.08953
-
A. Elben and B. Vermersch, "RandomMeas.jl: A Julia package for randomized measurements in quantum devices", Quantum 10, 2086 (2026). arXiv:2509.12749
-
B. Vermersch, A. Rath, B. Sundar, C. Branciard, J. Preskill, and A. Elben, "Enhanced estimation of quantum properties with common randomized measurements", PRX Quantum 5, 010352 (2024). arXiv:2304.12292
-
H. Zou, "Randomized measurements of a 96-qubit kicked-Ising state on ibm_fez", Zenodo (2026). doi:10.5281/zenodo.24116174